上海交大Deep ASMR开源:用耳语数据训练低语音合成

上海交大开源Deep ASMR,解耦耳语方式与音色,实现低语合成。
上海交通大学团队开源了Deep ASMR项目,提出一种将耳语“方式”与说话人“音色”解耦的语音合成方法。模型分两步:语言模型参考别人的耳语学习读法、停顿和气声节奏;声学解码器参考本人的普通录音还原音色。团队整理了670小时中英文录音,在已有语音合成模型上微调,并公开数据、代码和训练脚本。插件实践只微调声学解码器末端参数,冻结语言模型和声码器,以观察气声质感变化。当前版本一次最多处理一百字,输出单声道人声,部分字头听不清需人工检查,配乐和空间效果留给后期。该开源工作为低语合成提供了可复现基线,其解耦思路可迁移至其他风格化语音任务。
闭上眼睛,好好休息吧。这段低语合成声音背后,是上海交通大学团队开源的Deep ASMR项目,以及一套可复用的训练方法。
技术核心:把耳语“方式”与说话人“音色”分开
传统语音合成面临一个现实问题:如果一个人只有平时的说话录音,没有耳语录,能否让他用低声的方式演绎新台词?Deep ASMR的解法是把任务拆成两步,引用两路不同来源的参考音频。
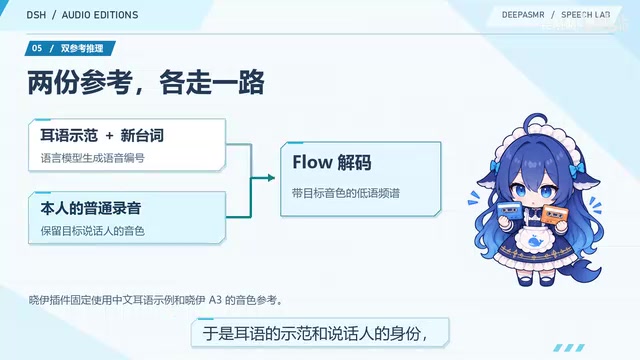
具体来说,语言模型参考别人的耳语,负责为新台词安排读法——哪里停顿、哪里气声、节奏如何。声学解码器则参考本人的普通录音,负责还原音色。这样,耳语的示范和说话人的身份可以来自不同的声音。
据B站UP主在视频中的讲解,团队整理了670小时的中英文录音,用不同人的耳语来学习这种说话方式。模型并非从零训练,而是在已有语音合成模型基础上进行微调,并公开了数据、代码和训练脚本。
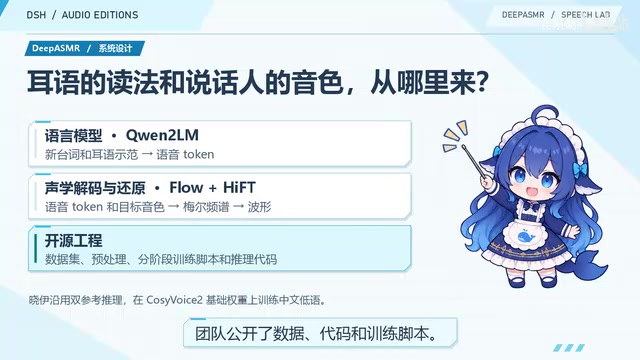
语言模型与声学解码器是两阶段语音合成架构中的常见分工。语言模型负责将文本映射为离散的语音单元序列(类似音素或子词单元),决定“说什么、怎么断句”;声学解码器则将这些单元序列转换为声学特征(如梅尔频谱),决定“听起来像谁”。Deep ASMR 的创新在于让两者分别接受不同参考音频的引导,从而实现风格与音色的解耦。
数据预处理:一句录音如何变成训练材料
训练数据需要三个维度的对齐:录音要同时对上文字内容和说话人身份。系统里有两个编码器分工协作:一个提取音色向量,代表说话人的声音特征;另一个把声音压成一串编号,代表语音的离散单元。
两份结果只算一次,连同原始录音一起打成分片,训练时直接读取。这种打包方式减少了训练时的重复计算,也让数据加载更高效。
音色向量(speaker embedding)是从音频中提取的固定维度向量,用于表征说话人的音质、音高等身份特征,常见方法包括基于深度网络的 d-vector、x-vector 等。离散语音单元(discrete speech unit)则是将连续音频压缩为有限词表编号的表示,通常通过自监督学习模型(如 HuBERT、Wav2Vec 2.0)聚类得到,每个编号对应一段短音频的抽象语音内容。两者结合,既保留了“谁在说”,又提取了“说了什么”。
两路训练策略与合成流程
交大的训练脚本从已有模型出发,分两路学习。第一路把耳语录音转成语音编号,让语言模型看着文字,练习预测这些编号——本质上是学习“怎么说”。第二路把录音里的编号和音色交给声学模型,以同一段录音的真实频谱为目标,学习还原声音的细节——本质上是学习“像谁说”。
合成时,两路接起来,由声码器输出最终声音。这套设计最巧妙的地方在于推理阶段的灵活性:假设你只有朋友平时说话的录音,手里没有他的耳语,程序会从耳语样本库里找一个声音相近的人,让语言模型参考那个人怎么轻声说话。但还原音色时,用的仍是你朋友的录音。
插件实践:只调声学解码器能带来什么
UP主开发的插件固定了上述两路参考:一路给中文耳语示例,另一路给小一的参考声。一个关键选择是只微调声学解码器,冻结语言模型和声码器。
原因在于,中文耳语示范已经能引导语言模型给出台词的读法和停顿,保留这个读法,只改声音还原的这一步,可以观察气声的质感会如何变化。训练时固定语言模型和声码器,只更新声学解码器末端的参数;推理时把这组参数加载到原版模型上。
数据划分上按节目标来源切分训练集和验证集,确保同一个节目的录音不会同时出现在两边,避免数据泄漏。
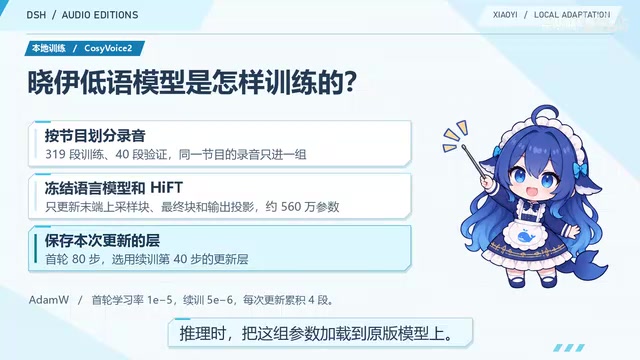
微调(fine-tuning)指在预训练模型基础上,用少量目标数据继续训练部分或全部参数,以适应特定任务。冻结(freezing)则是固定某些层的参数不更新,仅训练其余部分。只微调声学解码器末端参数,可以大幅减少可训练参数量,降低过拟合风险,同时保留语言模型已学到的通用读法能力,使实验聚焦于气声质感的改变。
数据泄漏(data leakage)在语音合成中指训练集和验证集包含同一说话人或同一来源的录音,导致模型在验证集上表现虚高,无法反映真实泛化能力。按节目来源切分训练集和验证集,确保同一节目的录音只出现在一边,是避免泄漏的常见做法,尤其当数据来源有限时更为关键。
使用体验与限制
下载包包含微调权重、训练说明和推理代码。在插件里输入一句中文,就能导出单独的人声音轨。当前版本一次最多接一百个字,说出一条单声道人声。长故事需要分段生成,再把停顿接好。
轻声说话时,有些字头会听不清,录完需要听一遍。配乐、雨声和左右耳移动都留给后期处理。这些限制说明低语合成适合作为配音素材生成工具,而非一键成品方案。
开源意义
Deep ASMR公开数据、代码和训练脚本,意味着低语合成不再是闭源黑盒。670小时中英文录音覆盖不同人的耳语,为后续研究提供了可复现的基线。把耳语方式与说话人音色解耦的思路,也可以迁移到其他风格化语音合成任务上,比如情感语音、方言转换。对于想做中文低语音频的开发者,这套权重和推理代码是一个可以直接上手的起点。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。