商业AI检测器被“文风模仿”攻破:改写降分实证

研究显示,用Gemini模仿指定作者风格改写AI文本,可使QuillBot检测器中位数分数从100%降至0%。
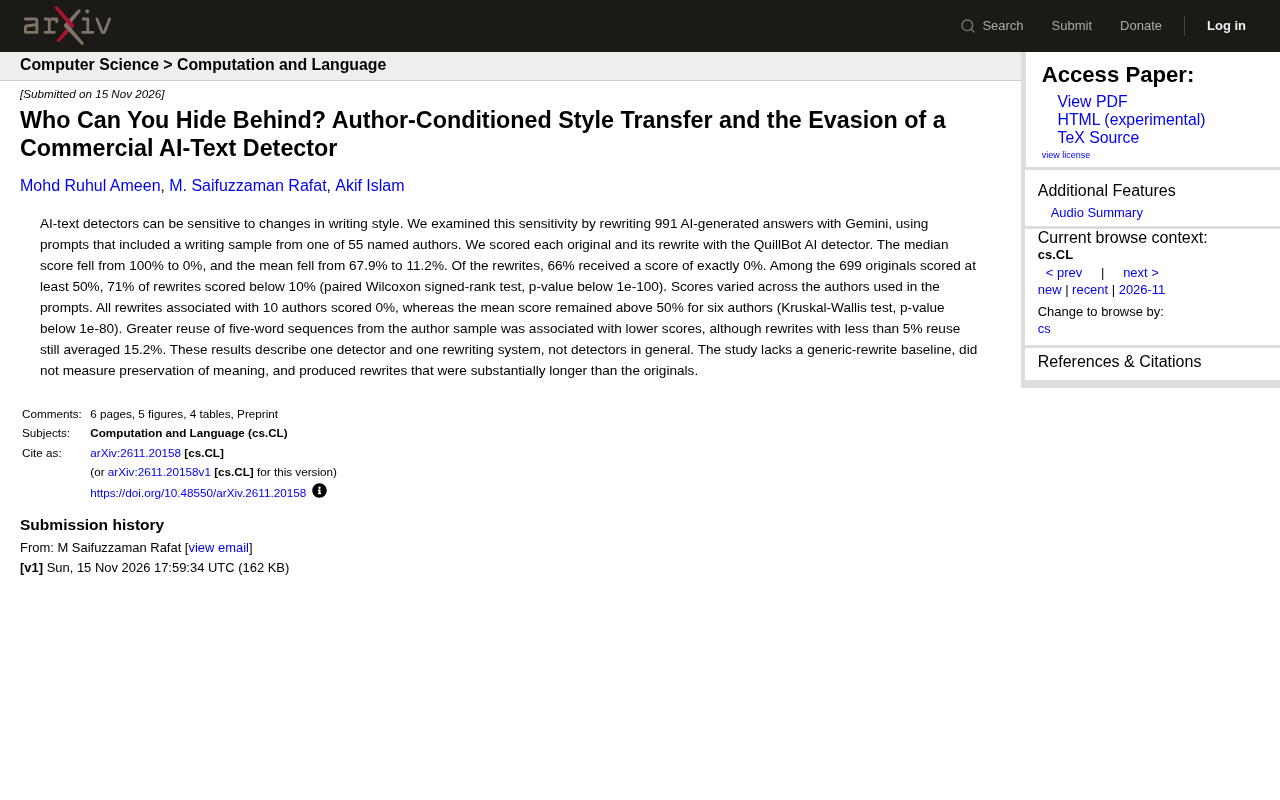
一项针对QuillBot AI检测器的最新研究发现,当AI生成文本经过“作者条件化风格迁移”改写后,检测器评分会断崖式下降。研究用Gemini模仿55位指定作者的写作风格,重写了991条AI生成答案,结果中位数分数从100%降至0%,均值从67.9%降至11.2%,66%的改写版本获得精确0%分数。不同作者样本效果差异显著:10位作者关联的改写全部得0%,6位作者的平均分仍高于50%。词汇复用与分数下降相关,但复用率低于5%的版本平均分仍为15.2%,说明深层风格模仿也在起作用。作者提醒结论仅适用于QuillBot与Gemini组合,且缺少通用改写基线和语义保留测量,但核心发现警示依赖单一风格特征的检测器可能非常脆弱。
一项最新研究揭示了商业AI文本检测器的一个显著弱点:当AI生成的文本经过“作者条件化风格迁移”(Author-Conditioned Style Transfer)改写后,检测器给出的AI概率分数会大幅下降。该研究以QuillBot AI检测器为对象,通过让Gemini模仿55位指定作者的写作风格来重写991条AI生成的答案,结果中位数分数从100%直接降至0%,均值从67.9%降至11.2%。这意味着,仅靠改变文风,就可能绕过当前商用检测工具的判断。
实验设计:用“作者样本”驱动风格迁移
研究团队的核心思路并不复杂:先准备一批由AI生成的答案(共991条),然后要求Gemini在重写这些答案时,参照某位特定作者的写作样本。提示词中包含了来自55位具名作者的文字片段,模型需要模仿该样本的用词、句式与节奏。每条原始答案及其改写版本都用QuillBot AI检测器打分,形成配对比较。
这种设计将“风格”作为唯一的操控变量,而非简单更换同义词或调整段落顺序。作者条件化的做法使得改写后的文本在表面特征上更接近人类写作的某个具体范例,从而干扰检测器基于风格统计的判别逻辑。
风格迁移(Style Transfer) 是自然语言处理中的一类任务,目标是在保留文本语义内容的前提下,改变其表达风格(如正式/随意、不同作者笔调、不同体裁)。传统风格迁移多针对情感、礼貌程度等粗粒度属性,而作者条件化风格迁移进一步将“风格”具体化为某位作者的写作指纹——用词偏好、句法复杂度、标点习惯、节奏感等。这类方法通常以少量作者样本作为条件提示(conditioning),引导大模型在生成时模仿目标风格。由于大模型具备强大的上下文学习能力,仅需一段作者原文即可实现较逼真的风格模仿,这也使得风格迁移的门槛大幅降低,成为规避基于风格统计的AI检测器的潜在手段。
分数断崖:中位数归零,均值大幅下滑
检测结果呈现出极端的分布变化。原始AI答案的中位数得分为100%,即检测器几乎确定其为AI生成;改写后的中位数直接跌至0%,彻底翻转。均值从67.9%降至11.2%,说明即便考虑离群值,整体偏移依然巨大。
更细致的统计显示,66%的改写版本获得了精确的0%分数。在原始分数不低于50%的699条样本中,有71%的改写版本分数低于10%。配对Wilcoxon符号秩检验的p值低于1e-100,表明这种下降并非随机波动。
Wilcoxon符号秩检验是一种非参数统计检验,用于比较两组配对样本是否存在显著差异,不要求数据服从正态分布。它基于配对差值的大小和符号进行秩次计算,特别适合本研究中“同一原始答案 vs. 其改写版本”的配对设计。p值低于1e-100意味着,若真实情况是改写前后分数无差异,观察到如此一致且大幅的分数下降的概率极低,从而支持风格迁移确实系统性降低了检测器评分。该检验对离群值稳健,比配对t检验更适合检测分数这种偏态分布的数据。
作者身份的影响:有人“隐身”成功,有人仍被识别
研究进一步发现,不同作者样本带来的逃逸效果差异显著。在55位作者中,有10位作者关联的所有改写版本得分均为0%,相当于完全“隐身”;而另有6位作者,其对应改写的平均分数仍高于50%,检测器依然保持较高警觉。Kruskal-Wallis检验的p值低于1e-80,说明作者之间的差异具有统计显著性。
这一结果暗示,风格迁移的效果并非均匀,某些写作风格可能天然更接近检测器判定为“人类”的特征空间。
Kruskal-Wallis检验是Wilcoxon检验的多组扩展,用于判断三个及以上独立样本是否来自同一分布,同样属于非参数方法。在本研究中,它将55位作者视为55个组,检验不同作者样本对应的改写分数分布是否存在整体差异。p值低于1e-80表明作者身份对逃逸效果有高度显著的影响,即某些作者的风格确实更容易让检测器“误判”为人类写作。这一结果提示,检测器的决策边界在风格空间中并不均匀,可能存在某些“人类风格盲区”,被特定作者样本触发。
词汇复用与分数下降相关,但并非全部原因
研究还考察了改写文本对作者样本中五词序列的复用程度。数据显示,对作者样本五词序列的复用越多,检测分数越低。然而,即便复用率低于5%的改写版本,平均分数仍为15.2%。这说明分数下降不能仅归因于直接复制片段,风格层面的深层模仿也在起作用。
局限与启示:一个检测器,一个改写系统
作者明确提醒,这些结果仅描述了一个检测器(QuillBot AI检测器)和一个改写系统(Gemini)的组合,不能推广到所有检测器。此外,研究缺少通用改写基线(即不指定作者风格的普通改写),因此无法判断风格条件化相比普通改写究竟带来多少额外优势。研究也没有测量改写前后语义的保留程度,而且改写文本比原文明显更长,长度差异本身可能影响检测器判断。
这些局限并不削弱核心发现的警示意义:依赖单一风格特征的AI文本检测器,在面对有针对性风格迁移时可能非常脆弱。对于需要甄别AI生成内容的场景,检测工具需要融合更多维度的信号,而不是仅凭文风统计下结论。
相关推荐
AI替你写代码,还要学Git吗?五个理由
AI编程代理能自动处理Git操作,还有必要学Git吗?本文提炼五个理由:与团队沟通、审阅代理提交的PR、监督代码改动、在AI宕机时兜底,以及学习本身的乐趣,并分析代理时代Git学习重心的转移。

Anthropic据报以每股83美元定价IPO,估值达1.5万亿美元
Anthropic据报以每股83美元定价IPO,高于预期发行区间,完全稀释估值达1.5万亿美元。本文分析此次定价的信号意义及其对AI行业融资环境的影响。

纳德拉预言:AI代理将重塑网络经济规则
微软CEO纳德拉预测AI代理将重新洗牌网络经济,冲击广告驱动模式,并迫使亚马逊等平台重新思考客户争夺方式。本文解析代理经济对广告、电商与平台竞争逻辑的影响。