少标签多问题校准:极小极大速率与识别极限

论文证明少标签多问题场景下,池化校准可跨问题共享信息,识别极限衰减极快。
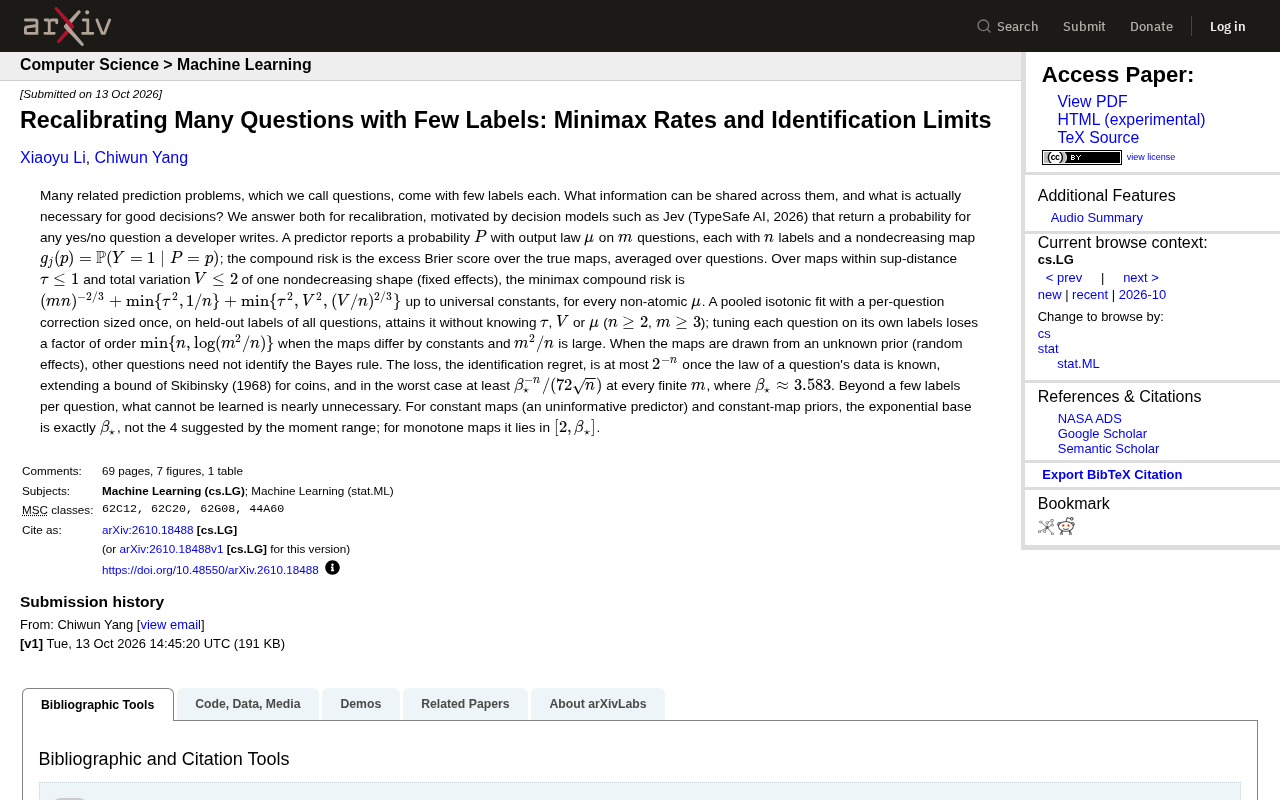
论文围绕“许多相关问题各自只有极少标签”这一设定,研究概率预测的重校准问题。作者定义了相对于真实校准曲线的超额 Brier 分数均值作为复合风险,并给出极小极大速率:在固定效应下,风险由 (mn)^{-2/3} 与关于异质性 τ、总变差 V 的若干 min 项构成。算法上,池化 isotonic 拟合加一次性全局校正即可达到该速率,且无需预先知道任何参数;逐题单独调参则会在 m²/n 较大时损失约 min{n, log(m²/n)} 的因子。在随机效应下,其他问题未必能识别本问题的贝叶斯规则,识别后悔上界为 2^{-n},最坏情况下界由 β★≈3.583 控制。核心结论是:跨问题共享结构远比逐题攒标签重要,少标签本身并非致命瓶颈。
当许多相关的预测问题(论文称之为“questions”)各自只有极少数标签时,我们能在它们之间共享什么信息?哪些信息又是做出良好决策真正必需的?这篇论文围绕**重校准(recalibration)**对这两个问题给出了答案,其动机来自 Jev(TypeSafe AI, 2026)这类决策模型——它们会为开发者写下的任意是/否问题返回一个概率。
问题设定:概率、真实映射与复合风险
论文的形式化设定很清晰。一个预测器在 $m$ 个问题上报告概率 $P$,其输出分布为 $\mu$;每个问题有 $n$ 个标签,并存在一个非递减映射 $g_j(p)=\mathbb{P}(Y=1\mid P=p)$,即校准曲线。复合风险被定义为相对于真实映射的超额 Brier 分数,并在所有问题上取平均。
换句话说,我们关心的不是单个问题上校准得准不准,而是把 $m$ 个问题的校准误差汇总后,整体上有多少可以改进的空间。这个设定贴近实际场景:一个通用模型同时回答大量细分问题,每个问题的标注却都寥寥无几。
论文把估计难度拆成几个来源:真实映射偏离某个共同非递减形状的程度(用 sup-distance $\tau$ 和总变差 $V$ 刻画,即 fixed effects),以及每个问题标签数量的稀缺性 $n$。这种分解方式让“共享什么”和“需要什么”两个问题都变得可量化。
极小极大速率:共享信息能带来什么
对于 non-atomic 的输出分布 $\mu$,当所有映射落在某个非递减形状的 sup-distance $\tau\le 1$ 且总变差 $V\le 2$ 的范围内时,复合风险的极小极大下界为:
$$(mn)^{-2/3}+\min{\tau^2,1/n}+\min{\tau^2,V^2,(V/n)^{2/3}}$$
(忽略通用常数因子)。
这个式子有几个值得拆解的层次。第一项 $(mn)^{-2/3}$ 表明,即便每个问题标签很少,只要问题数量 $m$ 足够大,跨问题池化仍然能把整体风险压下去。第二项 $\min{\tau^2,1/n}$ 反映的是映射之间的异质性代价:如果各问题的校准曲线差异较大($\tau$ 大),那么单靠共享结构无法消除这部分误差。第三项则把总变差 $V$ 也纳入进来,形成对复杂形状偏离的更细致刻画。
在算法层面,论文给出的估计器并不复杂:池化 isotonic 拟合,再加上一个按问题进行的校正项,而这个校正只在整个问题的留出标签上估计一次。关键的是,该估计器不需要事先知道 $\tau$、$V$ 或 $\mu$,只要满足 $n\ge 2$、$m\ge 3$,它就能达到上述速率。
反过来,如果对每个问题用其自身标签单独调参,就会在映射仅相差常数、且 $m^2/n$ 较大时损失约 $\min{n,\log(m^2/n)}$ 的因子。这直接说明:把问题拆开各自为战,在标签稀缺时是一种浪费。
识别极限:其他问题未必能识别贝叶斯规则
如果各问题的映射是从某个未知先验中抽取的(random effects),情况会更微妙。论文指出,此时其他问题未必能识别出贝叶斯规则。由此产生的损失被称为“识别后悔(identification regret)”。
论文给出了两个方向的界。上界方面,一旦某个问题的数据分布已知,识别后悔至多为 $2^{-n}$——这一结果把 Skibinsky (1968) 关于硬币的界进行了推广。下界方面,在最坏情况下,对每个有限的 $m$,后悔至少为 $\beta_\star^{-n}/(72\sqrt{n})$,其中 $\beta_\star\approx 3.583$。
这里有意思的是对常数 $\beta_\star$ 的精确刻画。对于常数映射(即无信息的预测器)和常数映射先验,指数底数恰好是 $\beta_\star$,而不是矩范围所暗示的 4;对于单调映射,该底数落在 $[2,\beta_\star]$ 区间内。
从实践角度看,这组结果传递出一个乐观的信号:每个问题只要超过少数几个标签,那些无法被学到的信息几乎也是不必要的。换句话说,识别极限带来的损失衰减得很快,真正的瓶颈更多落在有限标签下的估计速率上,而不是信息论层面的不可识别性。
对工程实践的启示
这篇工作最有价值的地方,在于它把“跨问题共享”这件事从直觉变成了可计算的权衡。
- 池化优于逐题调参:当问题之间有共同形状可借,共享信息能显著降低整体校准误差,逐题独立调参在标签少时会付出明显代价。
- 校正要省着用:按问题的校正只需在全局留出标签上估计一次,不必为每题单独消耗标签,这与很多工程直觉相反。
- 标签不必多:识别后悔随 $n$ 以指数级别衰减,说明“少标签”本身并非致命瓶颈,真正需要的是足够多的问题数量 $m$。
对构建是/否概率预测服务的团队而言,这套框架提供了一种思路:与其为每个细分问题攒大量标注,不如把精力放在扩大问题覆盖面上,并用带全局校正的池化校准来对齐概率输出。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。