舍入位置对齐:稳定LLM强化学习的新方法

对齐推理与训练在RoPE、SwiGLU等关键区域的舍入位置,可稳定BF16强化学习训练。
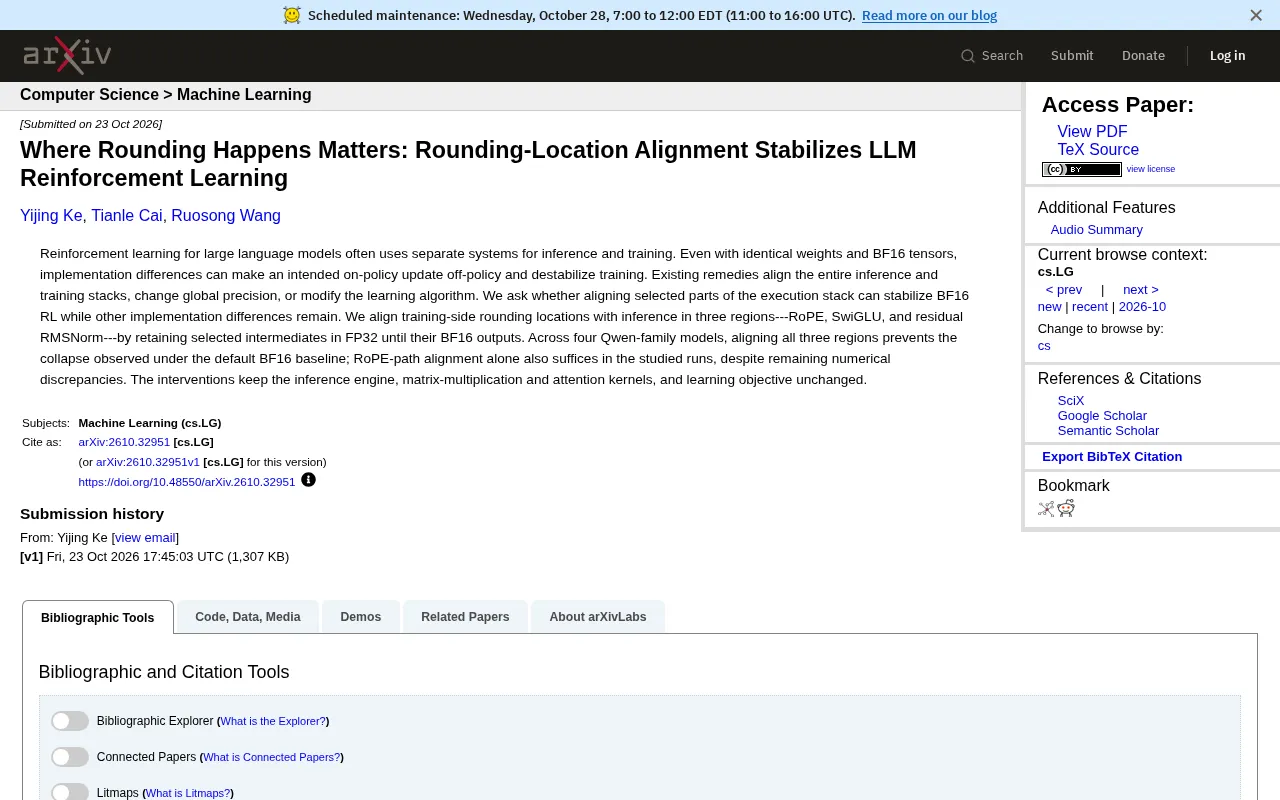
文章指出,LLM强化学习中推理与训练常运行于不同软件栈,即使权重和BF16精度相同,中间结果的舍入位置差异也会使本应on-policy的更新变为off-policy,导致训练崩溃。研究提出不改变推理引擎、矩阵乘法和注意力内核,而是选择性地在RoPE、SwiGLU和残差RMSNorm三个关键区域将中间结果保留在FP32,直到BF16输出阶段再舍入。在四个Qwen系列模型上的实验表明,同时对齐三处可完全防止默认BF16基线的崩溃,仅对齐RoPE路径也足以稳定训练。该方法开销小、兼容性好,为稳定BF16强化学习提供了轻量级方案。
大语言模型(LLM)的强化学习训练通常依赖推理和训练两套独立系统。即使权重和BF16张量完全相同,实现差异也可能让本应同策略(on-policy)的更新变成异策略(off-policy),导致训练不稳定。最近一项研究提出,通过对齐推理和训练中的舍入位置,可以在不改变推理引擎、矩阵乘法和注意力内核、学习目标的情况下,稳定BF16强化学习训练。
问题背景:同权重为何仍不稳定?
在LLM的强化学习流程中,推理和训练往往运行在不同的软件栈上。即使两边加载相同的权重并使用BF16精度,由于实现细节不同,中间计算结果的舍入位置可能存在差异。这些微小的数值差异会逐渐累积,使得训练过程中策略更新偏离预期,最终引发训练崩溃。
传统的解决思路包括:对齐整个推理和训练栈、全局修改精度(如使用FP32)、或调整学习算法。但这些方法要么成本高昂,要么会牺牲训练效率。
BF16 与舍入误差
BF16(Brain Floating Point 16)是一种 16 位浮点格式,保留 8 位指数(与 FP32 相同)但只有 7 位尾数,因此动态范围大而精度低。任何一次浮点运算的结果若无法被 BF16 精确表示,就必须舍入到最近的可表示值,产生约 2^-8 量级的相对误差。在 LLM 的 RL 训练中,前向推理与反向训练涉及大量矩阵乘、归一化和激活运算,每一步都会引入此类舍入误差。当推理侧与训练侧对同一中间结果选择不同的舍入时机(例如一个在 FP32 下累加后再舍入,另一个在中间步骤就舍入到 BF16),两边的数值轨迹就会分叉。对于 PPO、GRPO 等依赖重要性采样比值的 on-policy 算法,这种分叉会直接破坏策略一致性假设。
核心方法:只对齐关键区域的舍入位置
该研究提出了一种更精细的策略:不改变整个执行栈,而是选择性地对齐训练侧与推理侧的舍入位置。具体来说,研究团队在三个关键区域——RoPE(旋转位置编码)、SwiGLU(激活函数)和残差RMSNorm——将选定的中间结果保留在FP32精度,直到其BF16输出阶段再进行舍入。
这种方法的核心洞察是:并非所有舍入差异都同等重要,只要对齐关键区域的舍入行为,就能显著提升训练稳定性。
RoPE、SwiGLU 与 RMSNorm 的数值敏感性
RoPE(旋转位置编码)通过对 query/key 向量施加与位置相关的旋转来编码相对位置信息,其计算涉及 sin/cos 与逐元素乘法,对舍入位置极为敏感:旋转角度的微小偏差会改变注意力分数的相对排序。SwiGLU 是 Transformer 中常用的门控激活,形式为 SiLU(xW1) ⊗ (xW3),其中 SiLU 包含指数运算,在 BF16 下容易损失精度。残差 RMSNorm 则在残差分支上做均方根归一化,归一化系数由全局统计量决定,任何提前舍入都会放大到整个隐藏状态。将这三处的中间结果保留在 FP32、仅在输出阶段舍入到 BF16,相当于让推理与训练在数值最脆弱的环节共享同一条舍入路径,从而消除策略分叉的主要来源。
实验效果:防止崩溃,RoPE对齐即可
研究在四个Qwen系列模型上进行了实验。结果显示:
- 同时对齐三个区域(RoPE、SwiGLU、残差RMSNorm)可以完全防止默认BF16基线下的训练崩溃。
- 仅对齐RoPE路径的舍入位置,在研究的运行中也足以稳定训练,尽管仍存在其他数值差异。
有意思的是,这些干预措施没有改变推理引擎、矩阵乘法和注意力内核,也没有修改学习目标,因此具有很好的兼容性和实用性。
意义与展望
这项研究揭示了舍入位置对齐在LLM强化学习中的重要性,为稳定BF16训练提供了一种轻量级解决方案。相比全局精度调整,该方法计算开销更小,且易于集成到现有系统中。未来,这种思路可能扩展到更多模型架构和训练场景,帮助从业者更高效地训练大模型。
对于AI工程师和研究者而言,这一发现提醒我们:在混合精度训练中,舍入位置的选择可能比整体精度更为关键。精细控制关键区域的数值行为,或许是平衡训练稳定性和效率的有效途径。
相关推荐

Hermes Agent零基础实战:自进化AI助手
Hermes Agent 零基础教程:GitHub 41.7K 星的自进化 AI Agent 怎么装怎么用。本文拆解其学习循环、三层记忆与 Skill 自改进机制,对比 Claude Code 和 OpenClaw 的差异,并附 WSL 安装实操步骤。

RAG面试核心:离线建库与在线检索全流程拆解
拆解RAG检索增强生成的完整工作流程:离线阶段文档加载、切割、向量化、入库,在线阶段问题改写、向量检索、重排、生成,并解析RAG面试核心考点与系统优化方向。

AI大模型零基础入门:原理与API调用实战指南
从AI发展脉络到大模型训练原理,再到Token、Temperature、Top-P等核心概念,本文结合实战课程讲解系统提示词、Function Call、RAG与记忆能力的实现逻辑,并给出四类API调用场景的落地路径,适合零基础开发者入门。