深度实测:Gemini 4 全系模型能力揭秘,默认档为何垫底?
Gemini 4 四款模型双盲实测:默认档翻车,开最高思考档与多模型编排才是正解。
文章基于 B 站 UP 主 Axton 对 Gemini 4 系列(Argon、Carbon、Hydrogen、Neon)的双盲实测,梳理了四款模型的单向血缘关系:Argon 为原生稀疏 MoE 基座,Carbon 基于 Argon 做深度推理,Hydrogen 与 Neon 从 Carbon 分叉,Argon 已被官方从家族表移除。三道高难度三维题显示,菜单置顶的默认 Neon High 多次垫底,而打开 X High 最高思考档后同一模型拿下多个第一;多模型编排 Orchestrator 以 Neon 统筹、Hydrogen 并行执行,对阵默认档 3 比 0 完胜。成本上,Carbon 虽处半价推广期,因多轮调用总花费反高于默认 Neon。文章最后给出四条选型建议。
谷歌在一个多月内密集发布了四款 Gemini 4 系列模型——Argon、Carbon、Hydrogen、Neon,命名混乱得让人头晕。为了彻底搞清楚这四款模型的真实能力边界,B站UP主「Axton」花了十多个小时,把六个档位拉到同一批高难度题目里做了双盲实测,结果非常反常:官方菜单里置顶的默认 Neon 在几道三维生成题里居然垫底,而只要打开一个设置,它立刻反超顶配的 Carbon 拿下第一。
本文基于该实测素材,梳理 Gemini 4 家族的模型关系、能力表现、多模型编排实战以及成本账单,最后给出四条选型建议。
Gemini 4 家族关系:一条清晰的血缘链
很多人以为这四个模型是不同基座训练出来的,甚至流传 Neon 是 Hydrogen 的轻量改版。但翻看 DeepMind 官方的四份技术卡片,真相只有一条单向血缘链。
- Argon 是 10 月 13 日上线的原生稀疏混合专家大基座,整个家族的原点,并非旧模型微调而来。
- Carbon 基于 Argon 做深度推理,于 11 月 10 日发布。
- Hydrogen 和 Neon 全部从顶配的 Carbon 分叉适配,分别于 11 月 12 日和 11 月 18 日上线。
说个细节,11 月 18 日官方博客的家族表里已经把 Argon 移除,只保留 Carbon、Neon、Hydrogen 三档。谷歌 Gemini App 的菜单也由 Neon 顶替,AI 编程工具 AntiGravity 的下拉菜单置顶第一位就是默认的 Neon High,底下跟着四款单模型和多模型编排 Orchestrator。
稀疏混合专家(Sparse MoE) 是一种 Transformer 架构变体:模型内部由多个“专家”前馈子网络组成,每次前向计算时由门控网络只激活其中少数几个专家,而非全部参数。这样总参数量可以做得极大,但单次推理的算力开销只与激活部分相当,兼顾容量与效率。Argon 被称为“原生稀疏混合专家大基座”,意味着它从预训练第一步就按 MoE 结构设计,而非先训稠密模型再改造,因此路由与专家分工更充分,也为后续 Carbon、Neon 等分叉模型提供了容量基础。
模型分叉(fork) 指在已有基座权重上做继续预训练或针对性微调,得到面向不同场景的衍生模型。它不同于从头训练:分叉模型继承父模型的语言与推理能力,只需在目标能力(如深度推理、轻量化)上增量优化,因此发布时间可以非常密集。这也解释了为何 Hydrogen 和 Neon 能在 Carbon 发布后短短数日内相继上线,且三者共享大量底层能力。
实测翻车:默认 Neon 为何垫底?
三维物理题:越野车过减速坎
第一道题是离线三维物理题:纯写代码造一辆越野车驶过减速坎,重点考察轮胎贴地、悬挂压缩回弹和车身动态。六个档位全部跑出了悬挂压缩,但质感高下立判。
排第一的是打开最高思考档的 Neon X High,用了 24.7 分钟,比顶配 Carbon 快了十多分钟。全场只有它把哑光橄榄绿车身的曲面、轮眉和金色减震器质感做得像真车,慢放过坎没有穿模也没有过曝。排第二的 Carbon High 跑了 36.3 分钟,悬挂机械动作扎实,但默认机位死板,车尾高光过曝。
真正的反差在第 3 和第 4 名:菜单置顶的默认 Neon High 用了 23.1 分钟只排到第 4,反倒多模型编排 Orchestrator 用了全场最短的 19.6 分钟冲上第 3。老基座 Argon 排第 5,最轻量的 Hydrogen 垫底,车底缺少接触阴影,轮拱里漏做了刹车盘卡钳和轮轴。
思考档位(thinking budget / reasoning effort) 是推理模型常见的一类可调参数:它决定模型在给出最终答案前,允许消耗多少“思考 Token”进行内部推理、自我检查与方案迭代。档位越高,模型越可能发现并修正几何穿模、部件缺失、动画逻辑错误等深层问题,但耗时和费用也同步上升。文中 Neon 在默认档与 X High 档下表现判若两个模型,正是因为默认档为控制延迟压缩了思考预算,复杂三维任务来不及完成多轮校验;而 X High 会花更长时间反复推演物理与空间关系。这一机制意味着同一模型名下的“能力”并非固定值,选型时必须把思考档位与任务复杂度一起考虑。
精细机械结构:可交互三维机械蝴蝶
第二道题造一只可交互的三维机械蝴蝶,要求镂空金属和水晶质感、内部齿轮真实联动,并在旋转视角后切开四层爆炸拆解图检查零件是否飞出画框。
综合排第一的是 Carbon High,用了 30.7 分钟,银白钛金搭配香槟金和水晶四片翅膀,内部嵌进真实联动的齿轮,四层爆炸视图全部稳稳落在画框内,代价是单跑这一题就得等上半个小时。Neon X High 排第二,只用了 16.2 分钟,耗时是 Carbon 的二分之一,暗场钟表风格的机身和密密麻麻的齿轮细节非常惊艳,但切到百分百爆炸状态时翅膀左右超出了画面边缘。
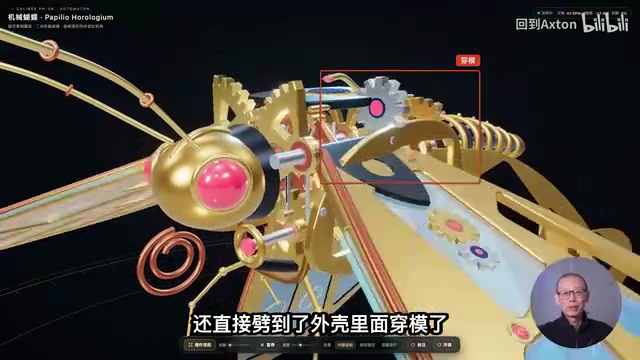
垫底第 6 名的又是默认 Neon High,用了 13.7 分钟,翅膀化成死板的巨型方格,看着像两块太阳能板,玻璃表面死白,齿根大齿轮直接劈到外壳里造成了穿模。同一个 Neon 开不开 X High,简直像两个模型。
复杂工程动画:桌子装配说明书
第三道题把午夜桌子的 PDF 装配说明书做成三维分布组装动画。之前测 Carbon 时这道题直接超时,这次六个档位全部做出来了。
拿第一的又是 Neon X High,29.4 分钟做完,全场只有它同时做对了第二步非对称错层桌头、一百件五金、多层木板侧纹,以及木销对准孔位插进去的动画。Carbon 跑了 49.8 分钟排第二,但把第二步做成了三块全对称的 X 板。默认 Neon High 只花 21.1 分钟排第五,不但把 92 根木销算成了 58 根,还有两段动画全程停在静态爆炸图上,完全漏做了分布移动的组装动画。
这道题彻底坐实了结论:遇到复杂工程的重活,千万不要停在默认档。
静态看图:快问快答拉不开差距
在认罗马数字、数鸡蛋、认李斯本、找七处不同、读林肯手写信这五道静态看图快问快答里,五个单模型档位全员满分。最便宜的 Hydrogen 只花了 1.6 分钟、折合 0.19 美元就全对,而 Carbon 用了 12.1 分钟、0.67 美元。
静态看图拉不开差距,真正分高下的是思考深度和多模型编排。
多模型编排:Orchestrator 3 比 0 完胜默认档
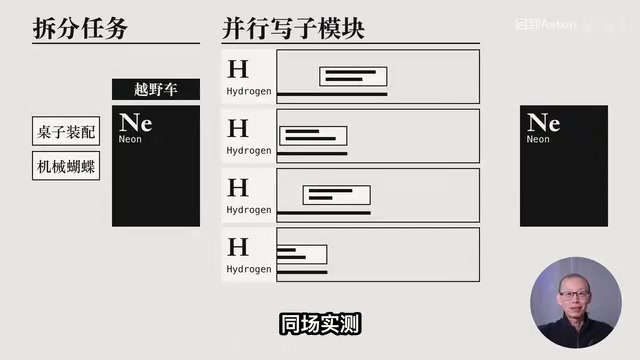
在 AntiGravity 菜单里选择 Orchestrator 模式时,不需要手动调思考档位,服务端会自动让 Neon 负责拆分任务和汇总把关,同时调动多个轻量便宜的 Hydrogen 并行写具体子模块。
把 Orchestrator 放到刚才三道三维重题里同场实测,它在成品质量上对阵默认单跑的 Neon High 打出 3 比 0 完胜:
- 越野车过坎拿第 3,赢过默认档的第 4,19.6 分钟跑出全场最快纪录,全系只有它把轮胎侧壁型号做出了立体浮雕,轮拱里的黄色螺旋弹簧也最通透。
- 机械蝴蝶只用 12.4 分钟排第 4,比 13.7 分钟垫底的默认 Neon High 更快,质量还赢过对方两名。
- 桌子装配说明书 33.7 分钟拿下第 3,赢过第 5 名默认 Neon High 和第 4 名 Argon,把默认单跑漏掉的分布组装动画完整做了出来。
但放到严苛的空间细节上,它还是小输给单跑的 Neon X High 和 Carbon High。越野车冲上坎顶瞬间有轻微穿模,机械蝴蝶翅膀内部少了内嵌齿轮,爆炸视图时翅膀飞出左右画框。桌子说明书里,编排模式虽然补出了分布组装动画,但木销是从正上方竖直掉下来卡在板件顶边,没有进入目标孔位。
也就是说,让 Neon 统筹规划、带 Hydrogen 并行干活,确实能稳稳拉高默认档的下限,但真要抠精细部件对位和画幅控制,上限还是达不到单跑的 Neon X High 和 Carbon High。
多模型编排(orchestration) 是指由一个“调度模型”把复杂任务拆解为若干子任务,再分派给多个更轻量、更便宜的模型并行执行,最后由调度模型汇总、校验与整合结果。它本质上是把“一个全能大模型单打独斗”换成“一个规划者加一群执行者”的流水线,优势在于并行缩短总耗时、把简单子任务交给低价模型以压低成本;代价是跨模型交接会损失上下文细节,精细对位、画幅控制这类需要全局一致性的环节容易出现偏差。文中 Orchestrator 让 Neon 统筹、多个 Hydrogen 并行写子模块,正是这一模式的典型形态。
成本账单:单价便宜不等于总花费更低
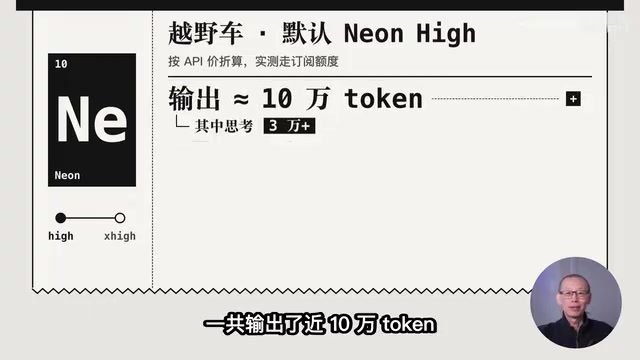
实测按订阅额度走,单模型费用统一按官方 API 列表价折算,思考 Token 也计入。以越野车这道题默认 Neon High 为例,一共输出近 10 万 Token,包含 3 万多思考 Token,加上输入和缓存读取,折合 2.81 美元。
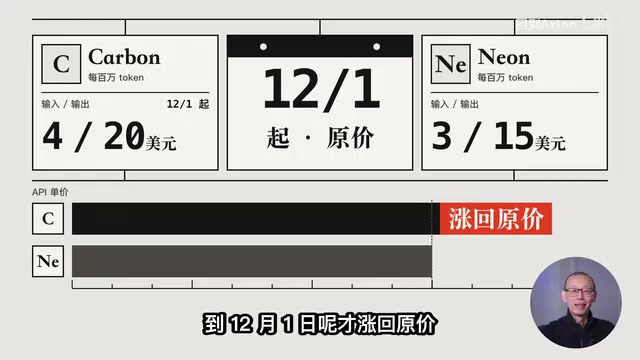
这里有一个价格倒挂:命中隐式缓存时读取费用只要普通输入的 5%,顶配 Carbon 在 11 月 30 日前还在推广期,API 单价大约是新主力 Neon 的三分之二,12 月 1 日才涨回原价。
结果非常反直觉:哪怕 Carbon 还在半价推广期,五道题核算下来,它在多轮调用的输入和缓存读取上多花了约 1.22 美元,把单价优势全抵消了。Carbon 最终跑了 138 分钟、折合 10.25 美元,比默认 Neon High 的 9.71 美元反而多花 0.54 美元。默认 Neon High 五道题只用了 66 分钟,耗时大约是 Carbon 的二分之一。
等到 Carbon 恢复原价后,它的五题总花费会跳到 20.5 美元,默认 Neon High 的花费大约只有它的 47%。更划算的是拿下两个冠军一个亚军的 Neon X High:五题总共耗时 86 分钟、折合 14.89 美元,比 Carbon 快 38%,12 月以后总花费反而比 Carbon 便宜 27%。Orchestrator 五题只要 5.8 美元,老基座 Argon 在 12 月后会涨到 16.14 美元,新项目已经不建议再选 Argon。
隐式缓存(implicit caching) 是部分大模型 API 提供的计费优化:当多次请求包含相同的前缀内容(如系统提示、长文档、多轮对话历史)时,服务端自动复用已计算的中间状态,命中部分按远低于普通输入的价格计费,文中为普通输入价的 5%。它对多轮调用、长上下文场景影响巨大,但也让“单价”失去了直观可比性——一个单价更低的模型如果每轮都重复读取大量未命中缓存的内容,总账单反而可能更高。评估模型成本时,应看包含输入、缓存读取、思考 Token 与输出在内的实际总消耗,而非列表单价。
四条选型建议
把十几个小时的实测落到日常选模型,可以直接对号入座:
- 静态看图、批量处理和简单子任务:直接选 Hydrogen,一分半钟就能拿满分,最快最省。
- 日常中等任务:用菜单里置顶的默认 Neon High,单模型里速度最快,但碰到复杂三维和重大工程不要指望它。
- 不想手动调设置、又嫌默认单模型不够稳:选多模型编排 Orchestrator,三道重题全部赢过默认档,速度往往还更快。
- 真正扛重活:直接锁死 Neon X High,比 Carbon 快 38%,12 月以后还能省约 27%。Carbon 可以在 11 月 30 日前趁推广价搭配使用,涨回原价后只留给极少数实在卡壳的超难题兜底。
UP 主还把全部 18 个可交互的 3D 成品做成了在线展示,包括越野车过坎、机械蝴蝶和午夜桌子装配动画,可以 360 度旋转拖拽、切换四层爆炸拆解图,感兴趣可以去亲自上手试玩找错误。
相关推荐

TensorLean:GPU内核形式化验证新工具
哥伦比亚大学与CertiK提出TensorLean,基于Lean在PTX层对生产GPU内核做形式化验证,检查149个内核实例,证明83个正确并发现38个缺陷,涉及FlashAttention、DeepGEMM等。

WorkBuddy零基础自动化办公实战教程
WorkBuddy 零基础实战教程:了解这款 Codex 国内平替如何适配常用办公软件,通过 28 个知识点和配套 SQL 资料,手把手教你实现办公自动化,告别重复劳动。
零基础3小时入门AI自动化测试:Playwright与DeepSeek实战
基于B站热门视频,解析Playwright自动化测试的核心优势:微软开发、基于DevTools协议、无需浏览器驱动、天生支持异步,并对比Selenium的局限,介绍通过MCP协议结合AI大模型实现Agent测试的零基础入门路径。