深度学习FYP选题指南:Reddit社区建议与实战思路

Reddit社区精华:深度学习FYP选题需平衡学术与职业,小而深、重工程、避坑指南。
本文综合Reddit社区讨论,为计算机专业毕业生提供深度学习FYP选题策略。核心原则是平衡学术可行性与职业相关性,选择小而深的题目,并与教授研究方向对齐。文章推荐五个热门方向:轻量化视觉模型与边缘部署、垂直领域NLP微调、可控生成与质量评估、强化学习仿真决策、跨学科AI应用。同时强调通过工程化(Git、README、演示)和量化对比实验让FYP成为求职利器,并列出常见避坑点:选题过泛、低估数据难度、忽视计算资源、缺乏评估计划。最后建议从兴趣出发,以终为始选择问题清晰、方法可行、结果可衡量的题目。
为什么FYP选题如此重要?
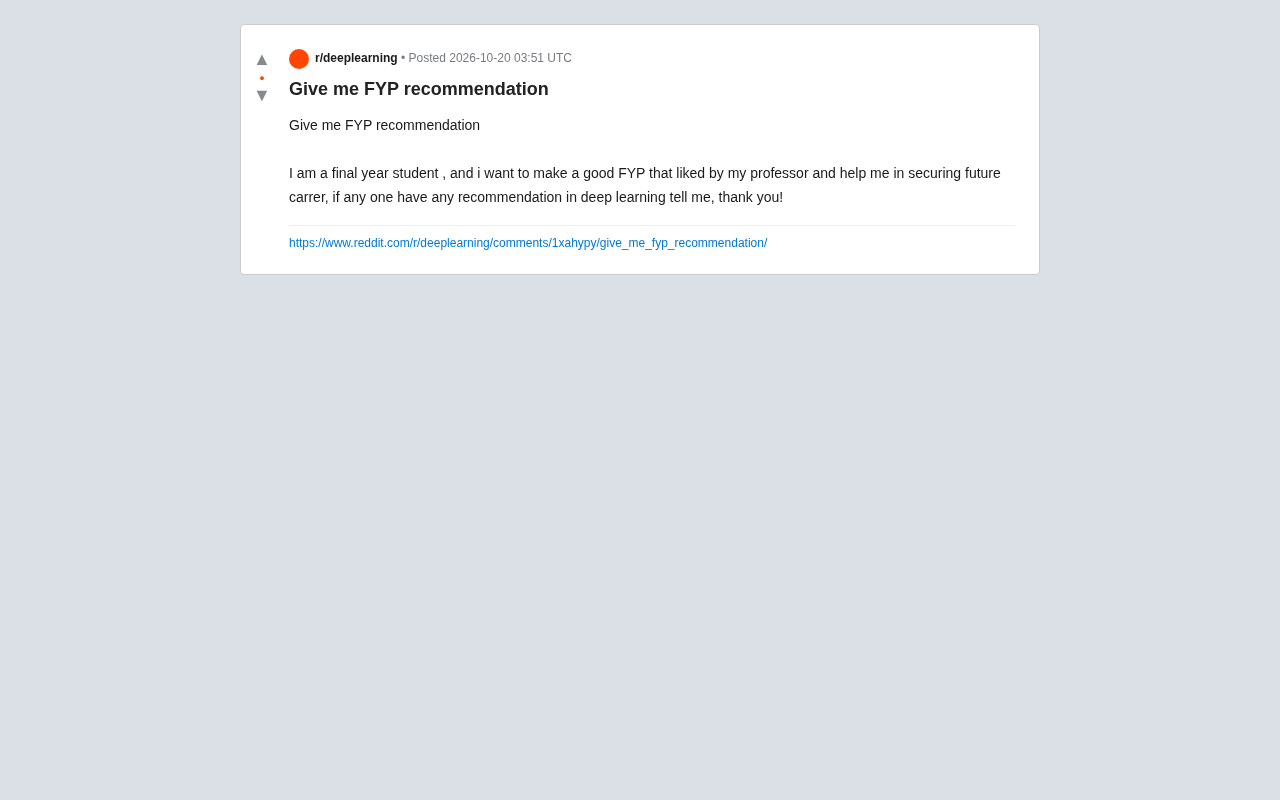
一名计算机专业的 final year 学生在 Reddit 上发帖求助:“我想要一个既能获得教授好评,又能帮助未来职业发展的 FYP,希望大家推荐深度学习方向。” 这则帖子虽然简短,但道出了许多毕业生的共同焦虑。FYP(Final Year Project)不仅是学术能力的集中展示,更是求职时的核心作品。一个糟糕的选题可能耗费数月却收获甚微,而一个巧妙的选题则能同时满足学术评价和职业需求。
本文综合 Reddit 社区的多方讨论(包括该帖的回复以及类似话题的常见建议),为你梳理深度学习 FYP 的选题策略、热门方向与避坑指南。
选题的核心原则:教授满意+职业赋能
Reddit 上多位有经验的学长和从业者反复强调,FYP 选题必须平衡两个维度:学术可行性与职业相关性。教授通常看重项目的新颖性、方法严谨性和结果可复现性;而雇主更关注项目是否涉及实际问题的解决、工程完整度和技术栈的匹配度。
一个常见的误区是追求“大而全”的题目,例如“通用目标检测系统”。这类题目往往因数据规模、计算资源限制而难以做出有说服力的成果。相反,小而深的题目更容易产出清晰的结果,例如“基于轻量级Transformer的特定场景缺陷检测”。Reddit 用户 @DeepLearn_Advice 提到:“教授喜欢看到你能够定义清晰的问题边界,并合理评估方法。”
另一个共识是:尽量与教授的研究方向或实验室资源对齐。这样不仅能获得更多指导,还可能接触真实数据集或计算资源。
热门深度学习FYP方向推荐
结合 Reddit 社区(r/MachineLearning、r/learnmachinelearning 等)的讨论,以下几个方向在近年 FYP 中较为热门且容易平衡学术与就业:
1. 计算机视觉:轻量化模型与边缘部署
目标检测、图像分割、姿态估计等经典任务依然是 FYP 的常见选择,但建议聚焦于模型压缩与边缘部署。例如:为移动端设计实时人脸口罩检测模型,对比剪枝、量化、知识蒸馏的效果。这类题目既有明确的评价指标(mAP、FPS、模型大小),又能展示工程能力,深受嵌入式AI岗位雇主欢迎。
模型压缩与边缘部署涉及三类主流技术:剪枝(pruning)通过移除冗余权重或通道减少参数量;量化(quantization)将浮点权重和激活值转换为低比特表示(如INT8),显著降低内存占用和推理延迟;知识蒸馏(knowledge distillation)让小型学生模型模仿大型教师模型的输出分布,从而在保持精度的同时压缩模型。边缘部署则关注在移动端或嵌入式设备上实现实时推理,常用工具包括TensorFlow Lite、ONNX Runtime和TensorRT。评估时需同时关注精度指标(如mAP)和效率指标(如FPS、模型大小、功耗),这对嵌入式AI岗位的求职非常有说服力。
2. 自然语言处理:垂直领域微调与评估
大模型时代,FYP 可以围绕特定领域的文本分类、信息抽取或问答系统展开。例如:利用 LoRA 微调开源模型进行法律文书摘要,并设计人工评估与自动指标结合的评估框架。Reddit 用户 @NLP_Student 建议:“不要试图从头训练大模型,而是聚焦于微调策略和领域适应,这样计算成本可控且结果容易分析。”
LoRA(Low-Rank Adaptation) 是一种参数高效微调方法,它冻结预训练模型的大部分参数,仅在Transformer层的注意力矩阵中注入低秩分解矩阵进行训练。相比全参数微调,LoRA大幅降低了显存需求和训练成本,使得在单张消费级GPU上微调大模型成为可能。在FYP中,使用LoRA可以快速在垂直领域数据上适配开源模型(如LLaMA、ChatGLM),并对比不同秩(rank)和适配层选择对效果的影响。评估方面,自动指标(如ROUGE、BERTScore)需与人工评估结合,尤其要注意领域术语的准确性和生成内容的忠实度。
3. 生成模型:可控生成与质量评估
扩散模型和 GAN 在图像、音频生成上仍有大量可探索空间。FYP 可以研究生成内容的质量评估指标或条件控制方法。例如:基于文本引导的图像编辑,并对比不同注意力机制的效果。这类题目新颖性强,容易吸引教授兴趣,但需注意计算资源需求。
扩散模型(Diffusion Models) 通过逐步去噪过程生成数据:前向过程向数据添加噪声直至纯噪声,反向过程学习从噪声中恢复数据。其条件控制通常通过Classifier-Free Guidance实现,即在训练时随机丢弃条件信息,推理时通过调节引导尺度平衡生成质量与条件一致性。质量评估方面,常用FID(Fréchet Inception Distance)衡量生成分布与真实分布的差异,IS(Inception Score)评估生成样本的多样性和清晰度,CLIP Score则用于衡量图文对齐程度。FYP中可对比不同注意力机制(如Cross-Attention vs. Self-Attention)对可控性的影响,但需注意扩散模型训练对GPU显存要求较高,可优先使用预训练模型进行微调或推理实验。
4. 强化学习:仿真环境中的决策优化
如果对机器人、游戏AI感兴趣,可以选择在开源仿真环境(如 PyBullet、Gym)中研究决策算法。例如:基于PPO的机械臂抓取策略改进。这类题目理论深度足够,且能体现对RL核心概念的理解,适合继续深造或应聘算法岗。
PPO(Proximal Policy Optimization) 是一种基于策略梯度的强化学习算法,通过裁剪重要性采样比率来限制策略更新幅度,在稳定性和样本效率之间取得平衡。它属于Actor-Critic框架,Actor网络输出动作概率,Critic网络估计状态价值。在仿真环境中(如PyBullet、MuJoCo、Gym),PPO常用于连续控制任务(如机械臂抓取、 locomotion)。FYP中可研究奖励函数设计、超参数敏感性或与SAC、TD3等算法的对比。需注意仿真到现实(sim-to-real)的迁移差距,以及训练不稳定时的调试策略(如观察价值损失、熵正则系数)。
5. 跨学科应用:AI for Science / Healthcare
将深度学习应用于生物信息、医学影像、材料发现等领域是近年热点。例如:基于CNN的皮肤病变分类,并结合可解释性方法(如Grad-CAM)分析模型关注区域。此类题目容易获得教授青睐,但需要与领域专家合作获取数据。
如何让FYP成为求职利器?
Reddit 讨论中,多位已毕业的从业者指出,FYP 在简历上的价值取决于你如何呈现它。建议在项目过程中注意以下几点:
- 工程化与可复现:使用 Git 管理代码,撰写清晰的 README,提供训练脚本和预训练模型。这直接体现工程素养。
- 量化结果与对比实验:至少与一个基线方法对比,报告关键指标和消融实验。面试官常问“你的方法比baseline好多少?为什么?”
- 部署演示:如果可能,将模型封装为 API 或简单 Web 应用(如 Gradio),附上演示链接。这会让项目更具说服力。
- 文档与博客:撰写技术博客解释项目思路和踩坑经验,既能展示沟通能力,也能增加线上曝光。
避坑指南:Reddit社区的血泪教训
在 r/learnmachinelearning 的类似讨论中,一些常见错误被反复提及:
- 选题过于宽泛:“基于深度学习的图像识别”这类题目缺乏焦点,难以深入。
- 低估数据获取难度:很多学生假设能轻松获得标注数据,结果卡在数据收集上。建议优先使用公开数据集或与实验室合作。
- 忽视计算资源:训练大模型需要GPU,如果实验室资源有限,应选择轻量级模型或使用云端免费额度(如 Colab)。
- 缺乏评估计划:只报告准确率是不够的,需要设计合理的评估协议,包括交叉验证、误差分析等。
总结:从兴趣出发,以终为始
FYP 是一次难得的深度学习实践机会。与其盲目追求热点,不如结合自己的职业目标(读博?进大厂?创业?)和可用资源,选择一个问题清晰、方法可行、结果可衡量的题目。Reddit 社区的建议可以概括为:小切口、深挖掘、重工程、勤沟通。希望每位毕业生都能找到那个让教授点头、让面试官眼前一亮的 FYP 题目。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。