深度学习为何十年攻不下表格数据?Frank Hutter的解答
Frank Hutter解释表格深度学习为何长期失败,以及上下文学习如何带来真正突破。
AutoML学者Frank Hutter在访谈中深入剖析了深度学习长期无法征服表格数据的根本原因:表格数据脏、异构,且不同领域的表格在数据行层面不共享任何可迁移的语义。以2019年谷歌TabNet为典型案例,他指出一代表格深度学习方法的共同缺陷——在特定基准上表现亮眼,却无法泛化到未见数据集。与图像数据可以通过ImageNet这样的单一大型数据集习得通用视觉特征不同,表格数据的知识迁移不能发生在"行"的层面,而必须发生在抽象的统计"模式"层面。上下文学习(in-context learning)正是实现这一跨越的关键技术,以TabPFN为代表的新一代表格基础模型由此带来了该领域的真正突破,并正在挑战"表格数据就用梯度提升树"的长期默认共识。
表格数据(tabular data)是机器学习领域最常见、也最具商业价值的数据形态——从医疗记录到保险精算,从银行风控到零售分析,结构化的行列表格无处不在。然而在深度学习席卷图像、文本、语音的这十年里,表格数据却始终是神经网络难以征服的堡垒。传统的梯度提升树(如XGBoost、LightGBM)长期在这一领域占据统治地位。AutoML领域的权威学者Frank Hutter在一次访谈中,给出了一个颇具洞见的解释。
脏数据与泛化难题
Hutter开门见山地指出:"表格数据非常脏,我认为这正是深度学习花了这么长时间才真正做好它的原因之一。"
与图像、文本这类高度结构化且语义连续的数据不同,表格数据充斥着缺失值、异构的数据类型(数值、类别、日期混杂)、不一致的编码方式以及领域特定的噪声。神经网络擅长在连续、平滑的特征空间中学习,而表格数据的离散性和异质性恰恰击中了它的软肋。
他特别提到了一个标志性案例:2019年谷歌推出的TabNet。"TabNet当时被炒得很热,上千次引用,被视为表格数据的新宠。但它就是不work,无法泛化到新的数据集上。"
TabNet的失败并非孤例,而是整整一代表格深度学习方法的缩影——它们在特定基准上或许能跑出漂亮的数字,但一旦换到新的真实数据集,性能便迅速崩塌。这种缺乏泛化能力的问题,恰恰是深度学习本应擅长、却在表格领域反复失守的痛点。
梯度提升树之所以长期主导表格数据领域,原因正在于其设计天然适配这类数据的特性。XGBoost、LightGBM等算法基于决策树的分裂机制,天然支持混合数据类型,对缺失值有内置处理策略,且对特征尺度不敏感,不需要像神经网络那样对输入做归一化预处理。更关键的是,树模型通过轴对齐分裂捕捉特征间的分段线性关系,而表格数据中许多业务规则恰好呈现这种结构——例如"收入超过X且年龄低于Y则风险等级为Z"。神经网络则需要通过大量参数和非线性激活函数去拟合这类本可以用几条规则描述的模式,在数据量有限时极易过拟合。
ImageNet的启示与表格数据的根本差异
Hutter用ImageNet做了一个精妙的类比来解释问题的本质。
"你可以有一个ImageNet,它基本涵盖了世界上各种各样的图像,然后你在这一个数据集上学习就够了。"图像世界存在一种内在的统一性——无论是猫、狗还是汽车,它们共享像素、边缘、纹理这些底层视觉特征,一个足够大的图像数据集就能让模型学到可迁移的通用表征。

但表格数据的逻辑完全不同。"表格数据真正需要的是大量不同的表格,因为如果你有一张来自医疗的表,又有一张来自保险的表,就单个行而言,从一张表里根本学不到任何能告诉你另一张表信息的东西。"

这是一个深刻的观察:一张医疗表格的某一行(某位患者的化验指标)与一张保险表格的某一行(某份保单的参数)之间,在原始数据层面毫无共通语义。你无法像图像那样,通过堆叠海量同质样本来学到通用特征。
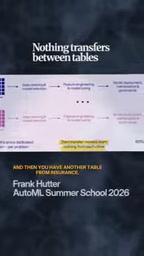
这正是过去表格深度学习方法的致命伤——它们试图在"行"的层面进行学习和迁移,而这条路从根本上就走不通。
上下文学习带来的突破
那么突破口在哪里?Hutter给出的答案是:迁移不该发生在数据行的层面,而应发生在"模式"(patterns)的层面。
"你能做的、能实现迁移的地方,是在这些模式的层面上。"虽然医疗表和保险表的具体数据毫无关联,但它们在统计结构上可能共享某些规律——比如特征之间的相关性模式、某类分布的形状、异常值的表现方式。这些抽象的"如何从数据中学习"的元知识,才是真正可以跨数据集迁移的东西。
实现这种模式级迁移的关键技术,是上下文学习(in-context learning)。"通过上下文学习,你确实可以跨不同的数据集进行迁移,这就是为什么,是的,借助上下文学习,我们终于看到了表格数据领域的突破。"
这一思路正是以TabPFN为代表的新一代表格基础模型的核心。模型在海量合成的、多样化的表格任务上预训练,学会的不是某个具体数据集的规律,而是一种通用的"面对一张新表该如何推断"的能力。推理时,整张训练表作为上下文输入,模型一次前向传播即可完成预测,无需针对新数据集重新训练。这种范式彻底绕开了传统深度学习在表格数据上的泛化困境。
上下文学习(in-context learning)最初因GPT-3的大规模语言模型而广为人知:模型在推理阶段无需更新任何参数,仅凭提示词中给出的若干示例(即"上下文")就能完成新任务。TabPFN将这一思想迁移到表格数据:预训练阶段,模型在数以百万计的合成分类任务上训练,每个任务对应一张随机生成的小型表格;推理阶段,整个训练集作为上下文拼接进输入,模型通过Transformer的注意力机制在行与行之间建立关联,直接输出测试样本的预测分布。这相当于模型在内部模拟了一次贝叶斯推断:它学会的是如何根据观测到的训练样本对新样本的标签分布进行后验估计,而不是记忆任何具体数据集的统计规律。这种"算法本身作为预训练目标"的设计,是其能够零样本泛化到全新领域表格的理论基础。
对实践者的意义
Hutter的分析不仅是学术层面的复盘,对工程实践同样有启发。
长期以来,"表格数据就用梯度提升树"几乎是数据科学的默认共识,深度学习被视为性价比不高的选择。但上下文学习范式的成熟,正在改写这一规则。对于中小规模数据集,基于预训练的表格基础模型有望以极低的调参成本,达到甚至超越精心调优的树模型效果。
更重要的是思维方式的转变:理解了"迁移发生在模式层面而非数据层面"这一点,才能真正把握为什么某些方法有效、某些方法注定失败。TabNet的教训提醒我们,在新的论文声称攻克表格数据时,泛化到真实、未见数据集的能力,永远是检验价值的试金石。
从TabNet的喧嚣到上下文学习的突破,表格深度学习走过的这十年弯路,本质上是一场关于"什么才是可迁移知识"的漫长探索。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。