深度学习自学坚持不下去?学习搭子模式帮你撑过60天

一个真实的求助:深度学习自学者的孤独
最近在 Reddit 上看到一位计算机科学(AI/ML方向)大三学生的发帖,内容朴实却极具代表性。他刚刚完成机器学习基础的学习,准备正式进入深度学习领域。用他自己的话说:「我是一个普通学生,但我知道只要保持坚持,我就有潜力学好并不断进步。」
他坦承自己最大的问题不是能力,而是独自学习时难以保持自律与责任感。因此他希望找到 2-3 位同样认真、能够坚持的伙伴,一起制定一份为期 60 天的深度学习路线图,设定每周目标、共享资源、并在周末进行简短的 Zoom 讨论。
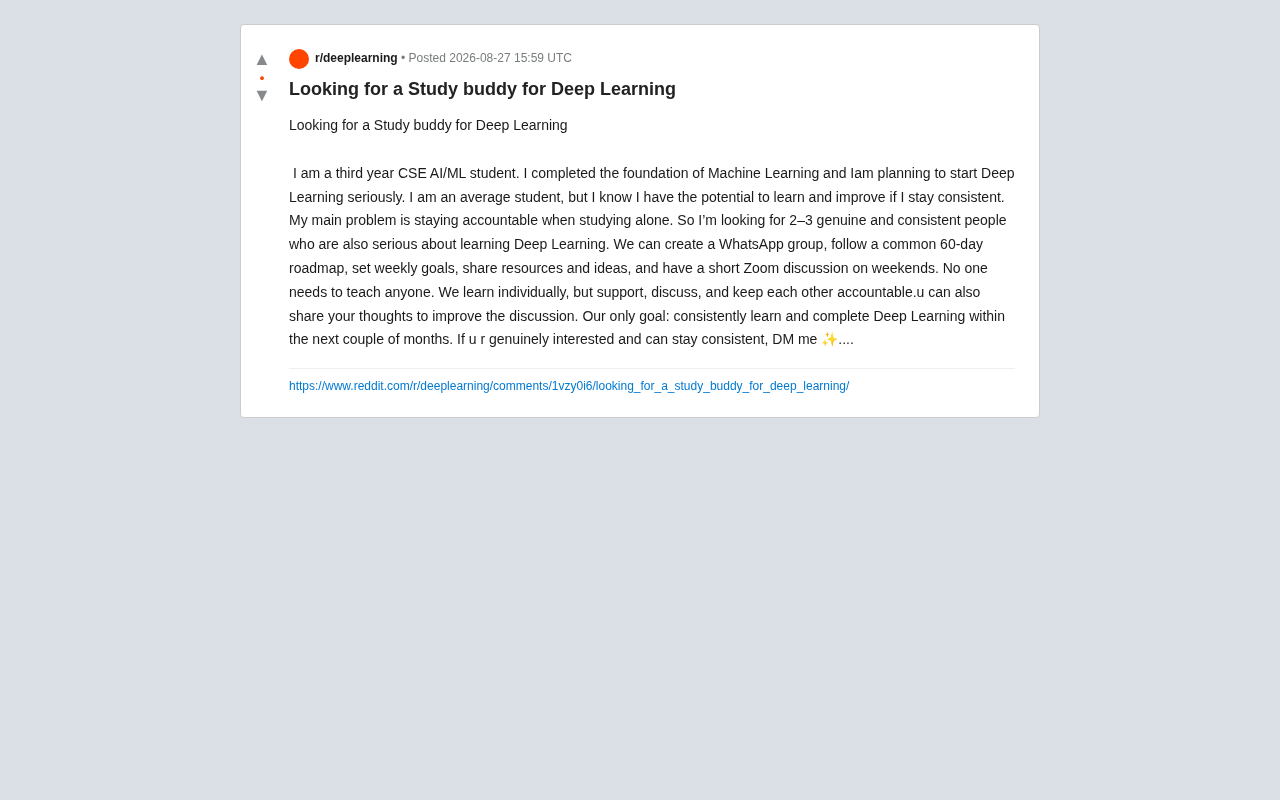
你可能没注意到,他明确表示「没有人需要教任何人」——大家各自独立学习,但彼此支持、讨论、互相监督。这条帖子的背后,其实折射出一个被广泛忽视的问题:在AI学习热潮中,坚持比智商更稀缺。
为什么独自学深度学习这么难?
知识曲线陡峭,容易半途而废
深度学习的门槛不算低。从反向传播、梯度下降,到卷积神经网络(CNN)、循环网络(RNN),再到如今的 Transformer 与大语言模型,知识密度极高。
这里值得展开说明这些概念为何会构成如此陡峭的学习曲线。反向传播(Backpropagation)是深度学习训练的核心算法,它通过链式法则将输出层的误差逐层传递回网络,计算每个参数对损失函数的梯度。梯度下降(Gradient Descent)则利用这些梯度信息迭代更新参数,使模型逐步逼近最优解。这两个概念涉及大量多元微积分和矩阵运算,对于首次接触的学习者来说,理解计算图中每一步的数学推导往往是第一个重大障碍。值得注意的是,梯度下降本身有多个重要变体——从最基础的批量梯度下降(Batch GD),到实践中最常用的小批量梯度下降(Mini-batch GD),再到自适应学习率优化器如Adam和RMSprop。初学者在实践中经常遭遇的梯度消失、梯度爆炸、陷入鞍点等问题,都与这些基础概念直接相关。
而从CNN到Transformer的演进,代表了深度学习在不同数据模态上的架构创新——CNN通过局部感受野和权重共享高效处理空间信息,RNN通过隐藏状态捕捉时序依赖,Transformer则通过自注意力机制实现了对全局上下文的并行建模,这些架构的理论复杂度层层递进。这一演进过程中还有若干关键里程碑不容忽视:ResNet(2015)通过残差连接解决了深层网络退化问题,首次使训练上百层的网络成为可能;LSTM和GRU通过精巧的门控机制缓解了标准RNN的长程依赖难题;而Transformer的横空出世则打破了序列模型和视觉模型之间的壁垒,统一了多个模态的建模范式,成为当今基础模型(Foundation Model)时代的核心架构。
对于一个刚打完机器学习基础的本科生来说,独自面对这些概念,很容易在遇到第一个数学推导或调参失败时产生挫败感。
缺乏即时反馈,动力被慢慢消耗
自学最大的敌人是「反馈真空」。当你写完一段模型训练代码却不收敛时,没有人能告诉你问题出在数据预处理、学习率还是网络结构。这种不确定性会持续消耗学习动力,让人在困惑中反复怀疑自己是不是"不适合学这个"。
模型不收敛的排查实际上是一门实践性极强的隐性技能。常见原因包括:学习率设置不当(过大导致损失震荡发散、过小导致训练停滞)、输入数据未标准化或存在标签错误、网络架构与任务复杂度不匹配、损失函数选择不当等。经验丰富的实践者通常会遵循一套系统化的调试流程:先在极小的数据子集(甚至几十个样本)上验证模型能否过拟合——如果连小数据都无法过拟合,说明模型本身或训练代码存在bug——再逐步扩大数据规模观察泛化表现。这种隐性知识几乎不可能从教科书中习得,恰恰是学习搭子讨论中最有价值的交流内容,一个伙伴的一句「你检查过数据加载时的标签顺序吗」可能就为你节省了几天的调试时间。
自律的心理学困境
心理学研究早已证明,公开承诺(public commitment)和社会监督(social accountability)能显著提升目标达成率。当你只对自己负责时,拖延几乎没有成本;但当有几个人在等着你周末汇报进度时,坚持就有了外部约束。这正是这位学生想要找「学习搭子」的核心逻辑。
公开承诺效应最早由社会心理学家Robert Cialdini在其经典著作《影响力》中系统阐述,其核心机制是「一致性原理」——人们在公开做出承诺后,会产生强烈的内在驱动力去保持行为与承诺的一致性,因为违背公开承诺会带来认知失调和社会评价压力。社会监督的研究则表明,当个体知道自己的行为会被他人观察和评价时,其目标坚持率可提升至单独行动时的1.5到2倍。美国训练发展协会(ATD)的一项研究更具体地指出,将目标告知他人后完成概率从25%提升至65%,而如果约定了定期汇报机制,完成概率可进一步提升至95%。这为学习搭子模式提供了坚实的心理学依据。
学习搭子模式到底好在哪里?
从个体苦撑到群体驱动
这位发帖者设计的模式相当务实:
- 共同路线图:60天的统一学习计划,避免各自为战导致进度混乱
- 每周目标:将大目标拆解为可执行的小任务
- 资源共享:优质教程、论文、代码库的互通有无
- 周末讨论:通过 Zoom 定期同步进展、答疑解惑
这种「独立学习 + 集体监督」的混合模式,既保留了个人学习的灵活性,又借助群体的力量解决了自律难题。它本质上是一种轻量级的同伴学习社群(peer learning community)。
同伴学习的理论根基可以追溯到维果茨基(Vygotsky)的「最近发展区」理论和社会建构主义学习观。维果茨基认为,学习者在与能力相近的同伴互动时,能够触及独自学习无法到达的认知区域。现代教育研究进一步证实,同伴之间的知识建构过程——包括提问、解释、辩论——能激活更深层的认知加工。与传统课堂不同,对等学习关系消除了权威压力,学习者更敢于暴露自己的知识盲区,而这种「安全的脆弱性」恰恰是深度理解的前提。在在线学习场景中,Coursera和edX等平台早期的数据显示,参与学习小组的学员课程完成率比独自学习者高出3到5倍。
为什么不是「老师教学生」
发帖者特意强调「没有人需要教任何人」,这一点很有智慧。传统的师徒模式会让水平较高者承担教学负担,容易失衡而难以持续。而对等的学习关系中,每个人都是贡献者也是受益者,讨论中的思维碰撞往往比单向灌输更有价值——费曼学习法早就告诉我们,向他人解释一个概念是最好的巩固方式。
费曼学习法(Feynman Technique)得名于诺贝尔物理学奖得主理查德·费曼,其核心步骤是:选择一个概念,尝试用最简单的语言向一个完全不懂的人解释它,然后识别自己解释过程中卡壳或含糊的地方,回到原始材料重新学习这些薄弱环节,最后精简和打磨解释直至清晰流畅。这个方法之所以有效,是因为「教」的过程迫使大脑将碎片化的知识重新组织成连贯的叙事结构,同时暴露了「以为理解但实际只是熟悉」的伪知识。在深度学习领域,这意味着当你尝试向学习搭子解释为什么BatchNorm能加速训练,或者Transformer中多头注意力的维度拆分逻辑时,你对这些概念的理解会得到质的飞跃。
一份可落地的60天深度学习计划
如果你也想加入或组建类似的学习小组,这里提供一个可参考的路线框架。
第一阶段(第1-20天):夯实基础
- 复习线性代数、微积分与概率论中与深度学习相关的核心内容
- 掌握神经网络基本原理:前向传播、反向传播、损失函数
- 熟悉一个主流框架(PyTorch 或 TensorFlow),完成第一个手写数字识别(MNIST)项目
关于框架选择,PyTorch和TensorFlow是当前深度学习领域的两大主流框架。PyTorch由Meta(原Facebook)AI Research开发,以其动态计算图和Pythonic的API设计著称,在学术研究领域占据压倒性优势——截至2024年,顶级AI会议(如NeurIPS、ICML、ICLR)中超过80%的论文使用PyTorch实现。TensorFlow由Google Brain团队开发,拥有更成熟的生产部署工具链(如TensorFlow Serving、TensorFlow Lite),在工业界仍有广泛应用。对于初学者而言,PyTorch的调试体验更接近标准Python开发,错误信息更直观,因此近年来逐渐成为入门首选。但无论选择哪个框架,核心概念——张量运算、自动微分、模型定义与训练循环——都是相通的。
而MNIST(Modified National Institute of Standards and Technology)手写数字数据集自1998年由Yann LeCun等人发布以来,一直被视为深度学习领域的「Hello World」。它包含60000张训练图像和10000张测试图像,每张图像为28×28像素的灰度手写数字(0-9)。这个数据集的特殊价值在于它足够简单(现代模型轻松达到99%以上准确率),使初学者能够将注意力集中在理解框架的使用流程和训练pipeline的构建上,而不是被复杂的数据预处理或模型调优所淹没。
第二阶段(第21-40天):核心架构
- 深入卷积神经网络(CNN),实践图像分类任务
- 学习循环神经网络(RNN/LSTM),理解序列建模
- 掌握正则化、批归一化、Dropout 等常用训练技巧
这三大训练技巧是深度学习工程实践中的重要支柱。正则化(如L1/L2权重衰减)通过在损失函数中添加参数惩罚项来限制模型复杂度,防止过拟合。批归一化(Batch Normalization,2015年由Ioffe和Szegedy提出)通过对每一层的输入进行标准化,缓解了内部协变量偏移(Internal Covariate Shift)问题,使得更高的学习率成为可能,显著加速了训练收敛。Dropout(2014年由Srivastava等人提出)在训练过程中随机「关闭」一定比例的神经元,迫使网络学习更鲁棒的特征表示,可以理解为一种隐式的模型集成方法。这些技巧看似原理简单,但在实际项目中如何组合使用、各自的超参数如何设置(例如Dropout率通常在0.1到0.5之间,不同层可能需要不同的值),往往需要大量实验和经验积累——这也是为什么学习小组中的经验分享格外有价值。
第三阶段(第41-60天):进阶与实战
- 学习注意力机制与 Transformer 架构
注意力机制(Attention Mechanism)最初由Bahdanau等人在2014年引入机器翻译任务,其核心思想是让模型在处理每个输出元素时,能够动态地「关注」输入序列中最相关的部分,而非依赖一个固定长度的向量来压缩全部信息。2017年,Google团队在论文《Attention Is All You Need》中提出Transformer架构,完全抛弃了RNN的循环结构,仅通过自注意力(Self-Attention)和前馈网络构建模型。自注意力机制通过Query-Key-Value三组矩阵计算序列中任意两个位置之间的关联强度,实现了对全局依赖关系的建模,同时由于计算可以并行化,训练效率大幅提升。Transformer不仅催生了BERT、GPT等革命性的大语言模型,还在计算机视觉(ViT)、语音处理、蛋白质结构预测(AlphaFold2)等领域引发了范式变革,是当今AI技术栈中最重要的架构基石。
- 尝试迁移学习与预训练模型微调
迁移学习(Transfer Learning)的核心假设是:在大规模数据上学到的通用特征表示可以迁移到下游任务中,即使下游任务的数据量很小。在计算机视觉中,ImageNet上预训练的ResNet或EfficientNet已经学会了从边缘、纹理到语义对象的层次化特征;在自然语言处理中,GPT或BERT在海量文本上预训练后掌握了丰富的语言知识。微调(Fine-tuning)是迁移学习最常用的策略,通常冻结预训练模型的底层参数(因为底层特征具有较强的通用性),只训练顶层参数或全部参数以适应特定任务。这种方法大幅降低了对标注数据和计算资源的需求——一个学生用消费级GPU和几百张图片就能训练出表现优异的图像分类器,这在从零训练时代几乎不可想象。Hugging Face的Model Hub已托管超过50万个预训练模型,使迁移学习成为当今AI开发的默认范式。
- 完成一个端到端的完整项目并整理进作品集
完成一个端到端项目意味着经历从问题定义、数据收集与清洗、模型选择与训练、评估与调优、到最终部署或展示的完整流程。这与只完成教程中的代码片段有本质区别——真实项目中80%的时间花在数据处理和工程问题上,而非模型架构设计。对于求职而言,GitHub上一个完整的、有清晰README文档的项目仓库,往往比简历上罗列的课程证书更有说服力。整理作品集时建议包含:问题动机、技术选型理由、实验结果对比、失败经验与改进方向,这些内容展示的是工程思维和解决问题的能力,而非单纯的编码技巧。
保持节奏的关键
每周固定汇报、公开进度、遇到问题及时在群里提问。完成率永远比完美更重要——宁可每天学30分钟并坚持60天,也不要一时兴起学8小时后消失一周。
从一条帖子看AI自学生态的变化
这条看似普通的求助帖,其实反映了当下AI学习者的普遍焦虑:资源从不缺乏,缺的是坚持下去的方法与陪伴。在 MOOC、YouTube 教程、开源代码泛滥的今天,信息过载反而加剧了「知道很多却学不会」的困境。
当前AI学习资源的爆炸式增长构成了一个悖论:选择越多,决策瘫痪越严重。仅在YouTube上搜索「deep learning tutorial」就能返回超过百万条结果,Coursera、Udacity、fast.ai、Stanford CS231n等课程各有优劣,GitHub上的开源项目更是浩如烟海。心理学中的「选择悖论」(Paradox of Choice)指出,过多的选项不仅不会提升满意度,反而会增加焦虑和后悔感——学习者常常在「我是否选了最好的教程」的反复犹豫中浪费大量时间。更深层的问题是,碎片化的免费资源缺乏系统性的课程设计和递进式的难度编排,学习者很容易陷入「跳课」或「重复学习已会内容」的陷阱。
MOOC(Massive Open Online Course,大规模开放在线课程)自2012年被《纽约时报》称为「MOOC元年」以来已经历了深刻变革。早期的完成率数据令人沮丧——哈佛和MIT的联合研究显示,MOOC的平均完成率仅为5-15%。这一数据本身就是「自学难以坚持」的有力佐证。为应对这一挑战,平台逐渐演化出付费认证、项目制学习、同伴互评等机制。fast.ai创始人Jeremy Howard采取了一种独特的「自上而下」教学法——先让学生跑通完整代码看到结果,再逐层拆解底层原理——这种方法显著降低了深度学习的入门挫败感。但即便如此,平台层面的设计仍无法完全替代人与人之间真实的社群连接。这正是为什么一份有明确时间节点和目标的60天路线图,以及能够提供方向感的学习社群,在资源过剩的时代反而变得弥足珍贵。
真正的稀缺资源不是知识本身,而是持续的执行力。学习搭子、共学社群、打卡机制之所以在AI领域越来越流行,正是因为它们回应了这个时代最真实的需求——在孤独的自学旅程中,找到几个愿意一起坚持的人。
对于每一个正在或准备踏上深度学习之路的人来说,这条帖子或许是一个提醒:不要低估「一起学」的力量。
核心要点
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。