神经算子新突破:可学习分数阶导数让PDE求解更精准

研究提出∂-NO,用可学习分数阶导数特征增强神经算子,最优阶数意外小于PDE阶数。
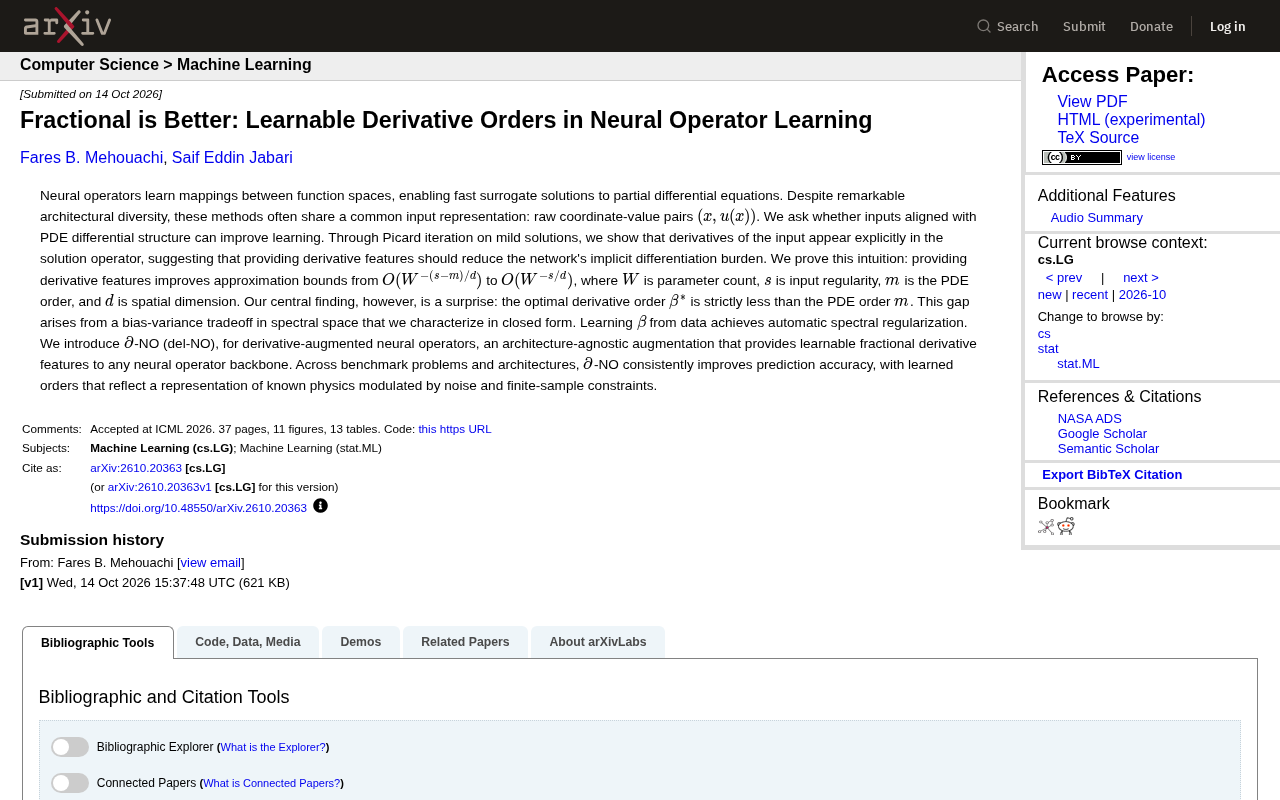
神经算子在求解偏微分方程时需隐式学习微分运算,加重了网络负担。一项最新研究从理论和实验两方面证明,向网络显式提供导数特征可显著降低学习难度:逼近界从O(W^{-(s-m)/d})改善为O(W^{-s/d})。但核心发现反直觉——最优导数阶数β*严格小于PDE阶数m,源于谱空间中的偏差-方差权衡,学习β*实现了自动谱正则化。基于此,研究团队提出∂-NO,一种架构无关的即插即用增强方法,可为任意神经算子骨干提供可学习分数阶导数特征,在多个基准上持续提升精度,且学到的阶数反映了物理规律在噪声和有限样本下的调制表示。
神经算子在求解偏微分方程(PDE)时一直面临一个根本性问题:网络需要隐式地学习微分运算,这增加了学习负担。一项最新研究提出了反直觉的解决方案——使用分数阶导数特征,且最优阶数严格小于PDE本身的阶数。
神经算子的隐式微分困境
神经算子学习的是函数空间之间的映射,能够为偏微分方程提供快速的代理求解方案。尽管架构设计层出不穷,但这些方法通常共享同一种输入表示:原始的坐标-值对 $(x, u(x))$。
问题在于,PDE的解算子本质上涉及微分运算。当网络只接收坐标和函数值作为输入时,它必须通过多层非线性变换隐式地学会微分。这无疑加重了网络的负担,尤其是在高维或高阶PDE问题中。
研究团队通过Picard迭代分析温和解发现,输入函数的导数会显式地出现在解算子中。这意味着,如果直接向网络提供导数特征,应该能够减少其隐式微分的负担。
神经算子(Neural Operator) 是一类学习无限维函数空间之间映射的深度学习模型,其目标是逼近PDE的解算子 $\mathcal{G}: a \mapsto u$,即从系数函数或初始/边界条件映射到解函数。与传统神经网络学习有限维向量映射不同,神经算子在函数空间层面进行学习,因此具有分辨率无关性——训练后可泛化到不同离散网格。代表性架构包括FNO(傅里叶神经算子,在频域进行全局卷积)、DeepONet(深度算子网络,采用分支-主干双网络结构)等。相比传统数值求解器每次求解都需重新计算,神经算子可离线训练一次、在线快速推理,为PDE代理建模提供了数量级的速度提升。
Picard迭代 是分析常微分方程和偏微分方程温和解(mild solution)的经典工具。其基本思想是将微分方程 $\dot{u} = f(u)$ 改写为积分方程 $u(t) = u_0 + \int_0^t f(u(s))ds$,然后通过迭代 $u_{n+1} = u_0 + \int_0^t f(u_n(s))ds$ 构造解序列。在PDE语境下,Duhamel原理给出的温和解形式中,非线性项通过积分算子作用,而积分前的被积函数往往包含输入函数的导数。研究团队正是通过这一分析发现:解算子对输入函数的依赖中,导数项会显式出现,从而为提供导数特征作为网络输入提供了理论依据。
理论证明与意外发现
研究团队从理论上证明了这一直觉。提供导数特征后,逼近界从 $O(W^{-(s-m)/d})$ 改善为 $O(W^{-s/d})$。其中 $W$ 是参数量,$s$ 是输入正则性,$m$ 是PDE阶数,$d$ 是空间维度。这一结果确认了导数特征确实能降低学习难度。
然而,核心发现出人意料:最优导数阶数 $\beta^*$ 严格小于PDE阶数 $m$。换言之,并非提供越高阶的导数越好。
这一差距源于谱空间中的偏差-方差权衡,研究团队给出了闭式刻画。从数据中学习 $\beta$ 实际上实现了自动谱正则化——网络会自适应地选择最有利于泛化的导数阶数。
逼近界 是衡量神经网络表达能力的重要理论指标。文中 $O(W^{-(s-m)/d})$ 表示:当网络参数量为 $W$、输入函数属于正则性为 $s$ 的Sobolev空间、PDE阶数为 $m$、空间维度为 $d$ 时,逼近误差随参数量增加而衰减的速率。该速率中的指数 $(s-m)/d$ 反映了问题的内在难度:PDE阶数 $m$ 越高、维度 $d$ 越大,指数越小,衰减越慢,意味着需要更多参数才能达到同等精度。当提供导数特征后,逼近界改善为 $O(W^{-s/d})$,相当于消除了 $m$ 带来的惩罚项——这从理论上量化了导数特征的价值。
偏差-方差权衡 是统计学习中的核心概念:模型偏差指假设空间无法完美拟合真实函数的系统性误差,方差指模型对训练数据扰动的敏感性。在谱空间中,高阶导数特征能更好地捕捉解的高频成分、降低偏差,但同时会放大噪声、增加方差。因此存在一个最优的导数阶数 $\beta^$,使总误差最小。研究团队给出的闭式刻画表明,$\beta^$ 严格小于PDE阶数 $m$,这是因为过度追求高阶导数会导致方差主导,反而损害泛化。
∂-NO:架构无关的即插即用增强
基于上述理论,研究团队提出了 $\partial$-NO(del-NO),一种导数增强神经算子。它的核心特点是架构无关:可以为任何神经算子骨干网络提供可学习的分数阶导数特征。
在多个基准问题和不同架构上的实验表明,$\partial$-NO 能够持续提升预测精度。更值得关注的是,学习到的阶数反映了已知物理规律在噪声和有限样本约束下的调制表示——这意味着网络学到的不仅是数值拟合,还捕获了物理结构。
这一方法的价值在于其通用性。无论是FNO、DeepONet还是其他神经算子架构,都可以直接集成 $\partial$-NO 增强,无需重新设计网络结构。
分数阶导数 是整数阶导数的推广,通过傅里叶变换定义为 $\mathcal{F}D^\alpha f = (i\xi)^\alpha \mathcal{F}f$,其中 $\alpha$ 可为任意实数。与整数阶导数相比,分数阶导数提供了连续可调的“微分强度”,能够在低频与高频之间实现更精细的平衡。在 $\partial$-NO 中,网络学习一个连续的阶数参数 $\beta$,对输入函数施加分数阶微分后再送入骨干网络。这种参数化方式使得导数特征既保留了物理先验(微分结构),又具备数据驱动的灵活性(阶数可学习),避免了人工选择整数阶导数的离散性限制。
自动谱正则化 指网络在训练过程中自动学习到最优的导数阶数 $\beta^*$,这一过程等价于在谱空间中对不同频率成分施加不同程度的衰减或增强。具体而言,分数阶微分在频域对应乘以 $(i\xi)^\beta$,其模长为 $|\xi|^\beta$。当 $\beta$ 较小时,高频成分被相对保留;当 $\beta$ 较大时,高频被放大。学习 $\beta$ 的过程实际上是在调整谱空间的加权,使得网络在拟合数据的同时抑制噪声主导的高频分量,从而起到正则化作用。这与传统需人工调节的正则化系数不同,$\beta$ 从数据中自动确定,且具有物理可解释性。
对PDE代理建模的启示
这项研究传递了几个重要信号。微分结构先验值得被显式编码到网络输入中,而非完全依赖网络隐式学习。分数阶导数比整数阶更灵活,能更好地平衡偏差与方差。自动谱正则化提供了一种数据驱动的方式来确定最优特征阶数,避免了人工调参的困难。
对于从事科学计算与AI交叉研究的从业者,这意味着在设计PDE代理模型时,应当重新审视输入特征工程——导数特征可能比更复杂的架构设计带来更大的收益。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。