神经网络本就是干净的?Goodfire研究员推翻叠加理论

叠加理论提出者之一推翻旧论,称神经网络本就干净可读。
Goodfire 研究员 Nick Camerata——叠加理论的提出者之一——发表长文推翻自己此前的理论,认为神经网络并非混乱叠加,而是有规律可循的"干净"结构。他重新解读经典证据:所谓猫脸车头神经元的共同点是 V 型,被当作叠加电路证据的实验实为姿态神经元,可视化方法本身存在误导。通过修复可视化工具、用现代架构重训和压力测试三板斧,Inception V1 最后一层可读性从约 0-5% 提升至约 99%,GPT-2 和 Qwen 32B 上的审计也显示绝大多数神经元只有一个主页。他提出"递归泛化"替代叠加:神经元像活树生长分叉,每一叉都有来历可追踪。方法论上主张直接读网络、像用 Google Maps 一样探索式解读,而非先拆解审计。若成立,欺骗行为将藏不住,对 AI 安全意义重大。
过去十年,"AI是个黑盒"几乎成了共识。几十亿参数层层叠叠,谁也说不清里面到底发生了什么。但这个共识的基石——叠加理论(Superposition),正在被它最初的提出者之一亲手推翻。
Goodfire研究员Nick Camerata在博客上发表长文,标题直白得挑衅:《神经网络本来就是干净的》。他的核心论点:过去十年,我们看错了。
叠加理论:一个统治领域多年的"丧"理论
十年前,科学家用特征可视化技术画出每个神经元最想看到的东西,发现了怪事:有个神经元既对猫脸反应强烈,又对车头反应强烈。更夸张的是Inception V1——当年可解释性领域的"模式生物"——最后一层几乎全是这种混乱神经元,能说清楚用途的约0-5%。
由此诞生了叠加理论:神经元不够用,网络就把不相关的特征硬塞进同一个神经元,反正它们平时不打架。就像一团毛线打了个结,乱但是能用。这个理论有个很丧的推论:如果网络是个结,你就别想直接研究它,必须先训练第二个模型(如稀疏自编码器)把结解开,再去研究拆完的版本。原版?没法看,扔了吧。
提出这个理论的人之一,就是Nick Camerata。他参与过OpenAI早期可解释性工作,主导过OpenAI第一个大规模让AI自己解读神经元的项目——当年只看懂了约2%的神经元,这也是他一度相信叠加的原因之一。
稀疏自编码器(Sparse Autoencoder, SAE) 是叠加理论流行后兴起的可解释性工具。其思路是:既然原始神经元的激活是多个特征叠加的稠密向量,就训练一个带稀疏约束的自编码器,把高维激活分解成大量近乎单义的稀疏特征。SAE 在 2023 年前后成为可解释性领域的主流方法,Anthropic 等机构用它从大模型中提取出大量可读特征。但批评者指出,SAE 本质上是事后拟合的"拆解器",它重建出的特征未必对应网络内部真实的计算单元,且稀疏性约束本身会引入人为偏差。Camerata 的"直接读网络"主张正是对 SAE 范式的正面挑战:如果原始神经元本来就足够单义,中间加一层拆解反而可能把信号搅乱。
第一板斧:猫脸和车头到底有什么共同点?
Camerata说他盯着那张猫脸车头神经元的照片看了几百遍,这次第一次问自己:这俩到底有啥共同点?五秒钟答案跳出来了——V型。猫脸是V,车头是V,V型火焰,消防船喷出的V型水珠,狐狸脸,全是V。
再看这个神经元的"腹肌"——它不喜欢什么?是个O。圆的V在哪它就在哪,反着来。一个V型检测器顺手连着火焰,这太合理了。那些误导人的猫须子呢?是可视化技术"搭便车"带进来的:画图时一旦走上猫这条路,胡子就跟着一起来了,虽然神经元根本不想要它们。
2019年那个被认为是唯一叠加电路证据的实验——一辆车的特征看起来藏进了一堆不相关的狗神经元里——他重新查了一遍,发现根本不是藏车和狗,是因为姿态被放在一起了。Inception V1里有100多个这种跨猫狗车的姿态神经元,以前没人注意到。当年之所以看着像藏,一部分是可视化方法被reward hack了,优化过程掉进了狗的盆地爬不出来。他的原话:这是我见过唯一的叠加电路,而且是错的。据他所知,从来没人发表过第二个长这样的电路。
第二板斧:从2%到99%的可读性跃迁
光推翻老证据不够,他准备了三板斧。第一斧砍向Inception V1的最后一层——当年叠加理论的主证据。他做了三件事:
- 先修显微镜,给特征可视化打补丁,同一批神经元能看懂的从约0-5%涨到约50%
- 把Inception V1按原架构重训一遍,加上现代正则化,约70%
- 换一个同参数同数据的现代网络(带残差连接和LayerNorm),最后一层约99%的神经元都能看懂
据他估计,当年那一层的混乱不是叠加这种新学习原理,是学坏了——架构有缺陷加上工具太弱。讽刺的是,领域为了让深层学得更好做的架构改进,顺手就把可解释性也修好了,没人是冲着可解释去的。
第二斧砍向语言模型。2023年他自己的自动化项目在GPT-2上只看懂了约2%的神经元,现在重审约70%粗看是一个东西,剩下大多是两三个相关含义。更狠的是现代大模型在Qwen 32B上的初步审计:约90%的神经元只有一个主页,约7%有两个相关副页,只有2%到4%还没看懂。他反复强调这个数字很依赖你怎么数,阈值一变它就变。
万亿参数级的模型他也画出了归因图:模型捡到一个钱包,钱包、现金、失主证件一路连到失误和诚实,最后回答归还。据他所知,这是公开发表的第一张万亿参数模型的归因图。混合专家模型(MoE)上,他的专家高度专化,有一个专家几乎只管RPG桌游里的boss——这简直是反叠加架构,想把一万个不相关的东西塞进同一个专家门都没有,路由器只是个小线性层,根本分不过去。
第三斧是压力测试。按叠加理论,神经元不够用就该叠罗汉。他把Inception V1某一层从480个神经元砍到10个重训,看它叠不叠。结果没叠,只是变粗了:10个曲线检测器变成一个曲线和环神经元,几种元变成两个元神经元。没有曲线加橙色螺旋加蜘蛛网的叠罗汉,只有变粗的泛化。连残差流压到46维,看到的也只是变粗,没有精心编织的干扰。
三板斧砍完,他的判断是:叠加应该从默认假设降级成最后才考虑的假设。一个东西看不懂,更可能是工具不行、架构有病,或者下面这个原因。
归因图(attribution graph) 是理解文中"万亿参数级模型"实验的关键。它把模型的计算过程表示成一张有向图:节点是中间激活或特征,边表示因果影响强度,通常通过在特定输入上做梯度归因或激活 patching 得到。与只看单个神经元不同,归因图追踪的是信息从输入特征(如"钱包""现金""失主证件")如何一步步流向最终输出(如"归还"),因此能在不拆解网络的前提下展示一条可读的推理链。Camerata 所说的"像 Google Maps 一样缩放",指的就是在这种图上按问题需要局部展开或全局俯瞰,而非预先枚举所有特征再逐一审计。
递归泛化:神经元是活树,不是死结
剩下那点多义到底是什么?他起了个新名字:递归泛化。想象一棵树,神经元生长时沿着相关方向分叉,长出小枝,小枝再长小枝。本地看每一步都合理,全局看它就不单一了。
有个神经元一开始只认"iy"(比如Miyazaki里的iy),训练中长出了"diy",最后长到了"do it yourself"这个词组里,连iy都没有了。还有一个地质神经元分叉到了Cesium——一个地质学的JS库。
为什么说这比叠加好得多?叠加是硬塞,因为不打架所以塞一起,塞的理由学不到任何东西。递归泛化是生长,每一叉都有来历,能追踪、能预测,还能在训练录像里亲眼看着它长出来。一个是死结,一个是活树,完全是两种世界。
他还解释了网络为什么天生爱泛化,叫"电路赛跑"。拿一张拉布拉多的照片从零训练:一条电路认绿色草地、棕色毛这种宽特征,另一条电路计第322个像素是什么颜色这种死特征。宽的那条每次吃到更多梯度,长得更快,把误差全抢光,窄的那条直接饿死。泛化不是第二步,是第一步就开始的,赢的永远是宽的、能复用的。
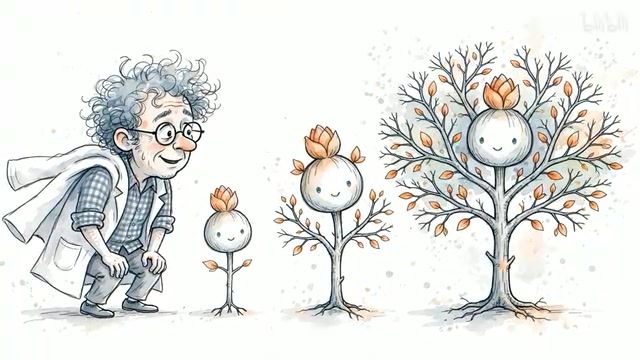
所以"神经网络干净的"真正意思,不是每个神经元对应一个人类概念——那反而是坏消息,说明网络没学到超出我们想象的东西。干净是说网络真的在学习、形成了一套生态,像雨林:每只动物都有来历,每个生态位都有reason。老虎为什么是橙色的?因为鹿分不清橙和绿,而哺乳动物长出绿毛太难了。一旦知道这个,一整类动物都讲得通了。
电路赛跑(circuit race) 一词借用了生物发育与进化中的"竞争性生长"隐喻。在训练早期,多条候选电路同时试图拟合同一批误差信号,谁的特征更宽、更可复用,谁就能在更多样本上获得梯度,从而长得更快、抢占更多参数容量,最终把窄电路"饿死"。这一机制解释了为什么网络从第一步就在泛化,而不是先过拟合再泛化:泛化不是正则化的事后效果,而是梯度竞争的初始偏向。它也解释了为什么现代架构(残差连接、LayerNorm)往往顺带提升了可读性——这些设计让宽特征更容易传播梯度,窄特征更难存活,网络自然长成更干净的生态。
方法论转向:直接读网络,像用Google Maps
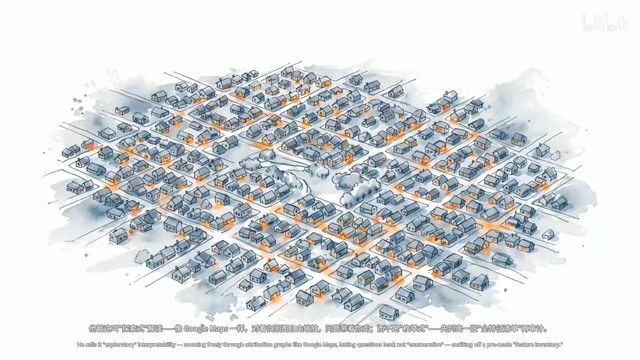
方法论上,他主张别先拆解,直接读网络。他管这叫探索式解读——像Google Maps一样,对着归因图自由缩放,问题带着你走,而不是一开始就列出一张全特征清单再审计。他说网络本身就是答案,可解释性是在寻找正确的问题。把东京切碎了扔到布鲁克林,东京只会显得更乱;稀疏自编码器干的就是这事,把微型神经元拆成车特征和猫特征,离真相更远了。
这对AI安全含义很刺激。如果网络是一座规划好的城市而不是毛线结,那欺骗就藏不住——欺骗必须对网络自己的读者(下游神经元)可访问,否则它传不下去。我们只要成为另一个读者就能读到它。他说自己真正怕的不是漏掉某个激活,而是他就在眼前、我们不会读。过去十年所有的误读都是在眼皮底下没看懂,没有一次是有个隐藏激活溜过去了。
城市这个比喻他展开讲了:小镇上你问几句话,问不出金融区在哪——银行一条街,保险公司另一条街,会计在家办公。但在纽约,一分钟就能在地图上定位。他们在三个差300倍大小的模型里看到,大模型里找锤头狗神经元反而更快,因为下面有一整套苍白的波浪的长在头侧的耳朵神经元拖着他——越大越好导航。
几句必须说的诚实的话
这是Goodfire的公司博客,不是同行评审论文,配套的技术论文还没发。所有数字都是估计,而且很依赖怎么数。作者自己说他只有85%的确信——注意,是85%确信整个世界观是对的,不是85%的神经元是对的,这是两种完全不同的确信。当年的玩具模型实验本身他承认没做错,分歧只在真实世界到底是哪一个。以及,Goodfire是做可解释性工具的公司,乐观叙事和他的生意方向是一致的。
但如果他是对的,可解释性的前景就比全领域以为的好得多。借他一句话收尾:我们一直拥有自然科学里最好的实验室——每个神经元可读,每次干预可做,每个实验可在完全相同的副本上重跑。以前缺的只是足够多的自动科学家替我们盯着看。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。