神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习

华为AI课程梳理AI知识版图,厘清机器学习与深度学习差异及神经网络本质。
本文基于B站华为集团AI深度学习教程,首先用一张图厘清AI知识版图:深度学习是机器学习的子集,主流方向包括CV、NLP和语音识别。接着对比机器学习与深度学习,指出特征工程是两者分水岭——机器学习依赖人工特征提取,深度学习则将特征提取与分类打包进网络。文章重点阐述神经网络的本质是线性回归的叠加,通过TensorFlow Playground实验和Python绘图双重验证。最后解释2012年成为深度学习转折点的原因,并给初学者提供实用建议。
从AI学习路线图说起:CV、NLP、语音识别各归其位
很多初学者面对“人工智能”这个词时,并不清楚它下面到底包含哪些分支。在B站流传的一套华为集团AI深度学习教程中,讲师徐可老师用一张图把AI的知识版图划了清楚:机器学习是AI的子集,深度学习又是机器学习的子集,而深度学习再往下分,主流方向是CV(计算机视觉)、NLP(自然语言处理)和语音识别(Voice Recognition,注意不是虚拟现实的VR)。知识图谱和无监督学习也在图中占有一席之地。
这个分类的意义在于帮学习者建立坐标系。比如课程此前讲过的OpenCV属于传统机器视觉,而深度学习体系下的CV在能力上要更强一些。
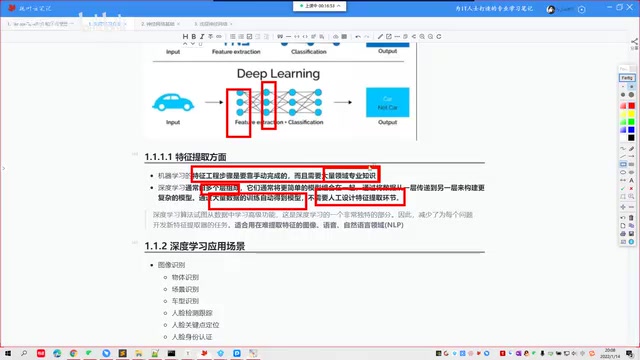
讲师的提醒很实在:完全没有深度学习基础的新同学,直接上手这门课会有难度,最好先从机器学习基础学起。这个建议本身也侧面说明了课程定位——300集从入门到实战,并不是让你跳过地基直接盖楼。
机器学习 vs 深度学习:特征工程是分水岭
两套技术路线最核心的差异,讲师用一张上下对比图讲明白了。
机器学习的流程是:人工做特征提取 → 选择分类或回归算法 → 训练预测。难点卡在第一步——特征提取需要领域专业知识。比如处理金融数据,你得知道每个特征代表什么、能不能被处理、该怎么处理。这不是调包能解决的问题。
深度学习则把特征提取和分类打包进了网络内部。 数据输进去,网络自己完成特征提取和分类,不需要人工设计特征体系。带来的直接好处是:你可以不懂业务背景,也能做出可用的模型。
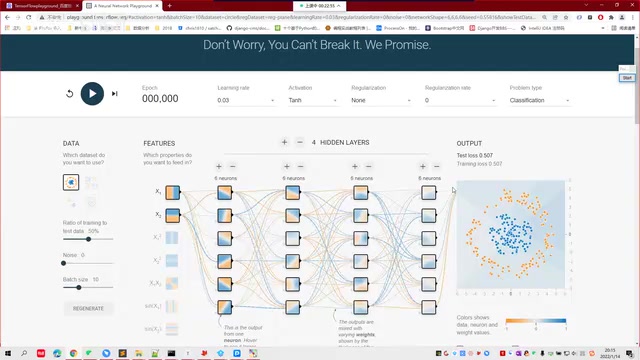
讲师对两者适用场景的总结很实用:数据量少、任务简单,用传统机器学习做数据挖掘就够了;问题复杂、精度要求高、特征难提取的地方,比如语音、图像、自然语言,才轮到深度学习出场。至于缺点,训练耗时长、容易过拟合,讲师也没有回避。
特征工程是指从原始数据中提取、构造、筛选出对模型预测最有用的特征的过程。它通常包括数据清洗、缺失值处理、特征编码(如独热编码)、特征缩放(归一化/标准化)、特征交叉以及降维等步骤。传统机器学习算法的效果高度依赖特征质量,因此领域专家需要反复试验,把业务知识转化为数值特征。深度学习则通过多层非线性变换自动学习特征的层次表示,减少了人工设计特征的负担,但并非完全不需要特征工程——数据预处理、归一化等仍是必要环节。
神经网络:松散模仿大脑,本质却是线性回归
课程花了大量篇幅建立对神经网络的感性认识。人工神经网络(ANN,代码里通常简写为NN)参考了生物神经网络的结构——眼睛接收光信号,视觉神经细胞把它转化为化学信号,信号在交织成网的神经元之间传递,这个过程对应着人脑的思考,也对应着神经网络的计算。
谷歌的TensorFlow Playground是讲师用来做演示的工具,无需翻墙即可访问。你可以在里面看到数据从输入层流入,经过隐藏层每个神经元时线上的权重(W)发生变化,右侧的分类结果实时更新。Tensor就是数据,Flow就是流动——这个框架的命名逻辑一目了然。
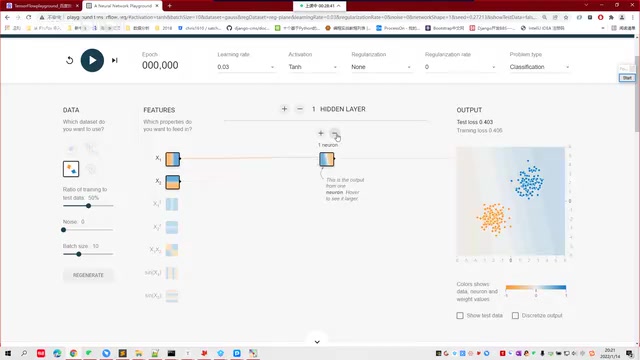
接下来是整堂课最“反直觉”的结论:神经网络的本质是线性回归。 每个神经元做的事情就是WX+B,加一个激活函数处理非线性问题(入门阶段可以先忽略)。网络层数越多,无非是线性方程的叠加越多,模型越复杂。
讲师用Playground做了两组对照实验来印证这个观点:
- 单层六个神经元处理一个嵌套的二分类问题时,分不干净,黄色点里混着蓝色点,因为“神经元不够聪明”;
- 加到三层网络后,同样的任务就能把黄蓝两类基本分开——模型变“聪明”了,但底层机制没变,还是线性计算的堆叠。
随后讲师切到Python环境,把Playground里读到的权重(w1=-0.93,w2=-0.77,b=0.12)代入手工推导的方程,用matplotlib画出直线,结果与Playground中的分界线完全吻合,从侧面验证了“一个神经网络就是一个线性方程”的判断。
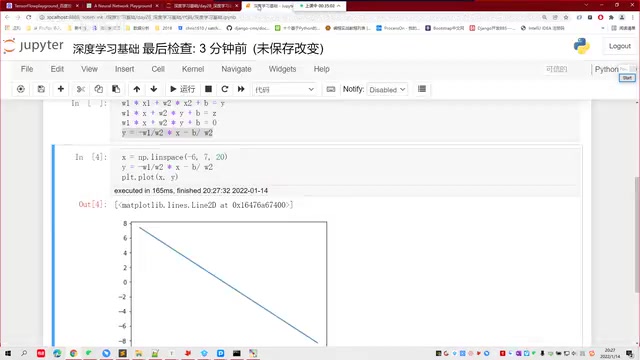
这里有个容易被误解的点,讲师专门纠正了弹幕里的说法:神经元越多不等于越精确。加神经元是解决“网络处理不了”的手段,但不是无脑堆就一定能提升效果。
激活函数是神经网络中每个神经元在完成线性计算(WX+B)之后施加的非线性函数,常见的有Sigmoid、Tanh、ReLU等。如果没有激活函数,多层网络叠加起来仍然等价于一个线性变换,无法拟合复杂函数。讲师在入门阶段建议先忽略激活函数,是为了突出“线性计算是基础”这一核心认知;但在实际应用中,激活函数是网络具备非线性表达能力的关键。
为什么2012年成了深度学习的转折点
课程提到一个行业公认的时间分水岭:2012年之前是传统机器学习的天下,SVM是最火的算法;2012年之后进入大数据时代,数据量上来了,问题也复杂了,传统算法遇到瓶颈——数据再多,表现也提升不上去。
讲师用一个手写数字识别的例子做了量化对比:SVM的准确率到97%~98%就基本封顶;换神经网络,训练次数和数据量给够,很容易到99%,而且算法越先进,达到99%所需的训练轮次越少。
这个对比解释了深度学习崛起的底层逻辑:不是传统算法变差了,而是数据规模和任务复杂度的增长,把两类方法的能力上限差距拉大了。
SVM(支持向量机) 是2012年之前最流行的传统机器学习算法之一,其核心思想是在特征空间中寻找一个最大间隔超平面来分隔不同类别的样本,并通过核函数处理非线性问题。SVM在中小规模数据上表现优异、理论完备,但面对海量数据时计算复杂度高,且需要人工设计合适的特征。2012年AlexNet在ImageNet竞赛中大幅领先,标志着深度学习在大规模数据和高精度任务上的优势开始显现。
给初学者的实用建议
从这堂公开课能提炼出几条对入门者有价值的信息:
- 先补机器学习基础再碰深度学习,否则大量概念会听不懂;
- 没有GPU也能学,入门阶段用普通设备可以跑通,但学到复杂网络时会有不便;
- 善用可视化工具建立直觉,TensorFlow Playground这类工具能让你在不写代码的情况下理解网络在做什么;
- 理解“线性回归是基础”这个认知,后面所有的激活函数、正则化、复杂网络结构,都是在这个基础上叠加的东西。
课程本身覆盖CV、NLP、语音识别、OpenCV、神经网络等模块,讲师把“学完即可就业”写在标题里,但从内容编排看,它更像一条从概念到代码的渐进路线,是否真能直接对标就业,还需要学习者自己用项目来检验。
本文基于B站公开课视频内容整理,视频中讲师为徐可老师,课程标注为华为集团AI深度学习教程。文中技术观点均出自讲师讲解,供学习参考。
TensorFlow Playground 是一个基于浏览器的交互式可视化工具,用户无需编写代码即可调整网络层数、神经元数量、学习率、激活函数等超参数,并实时观察决策边界的变化。它由TensorFlow团队开发,适合初学者建立对神经网络训练过程的直观理解。讲师用它演示权重变化和分类结果,正是为了降低入门门槛,让学习者在动手写代码之前先形成感性认识。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。