神经网络拓扑表达力的构造性边界:从决策边界到输出空间

研究提出以网络输出空间贝蒂数度量拓扑表达力,并给出ReLU网络的构造性架构上界与紧边界猜想。
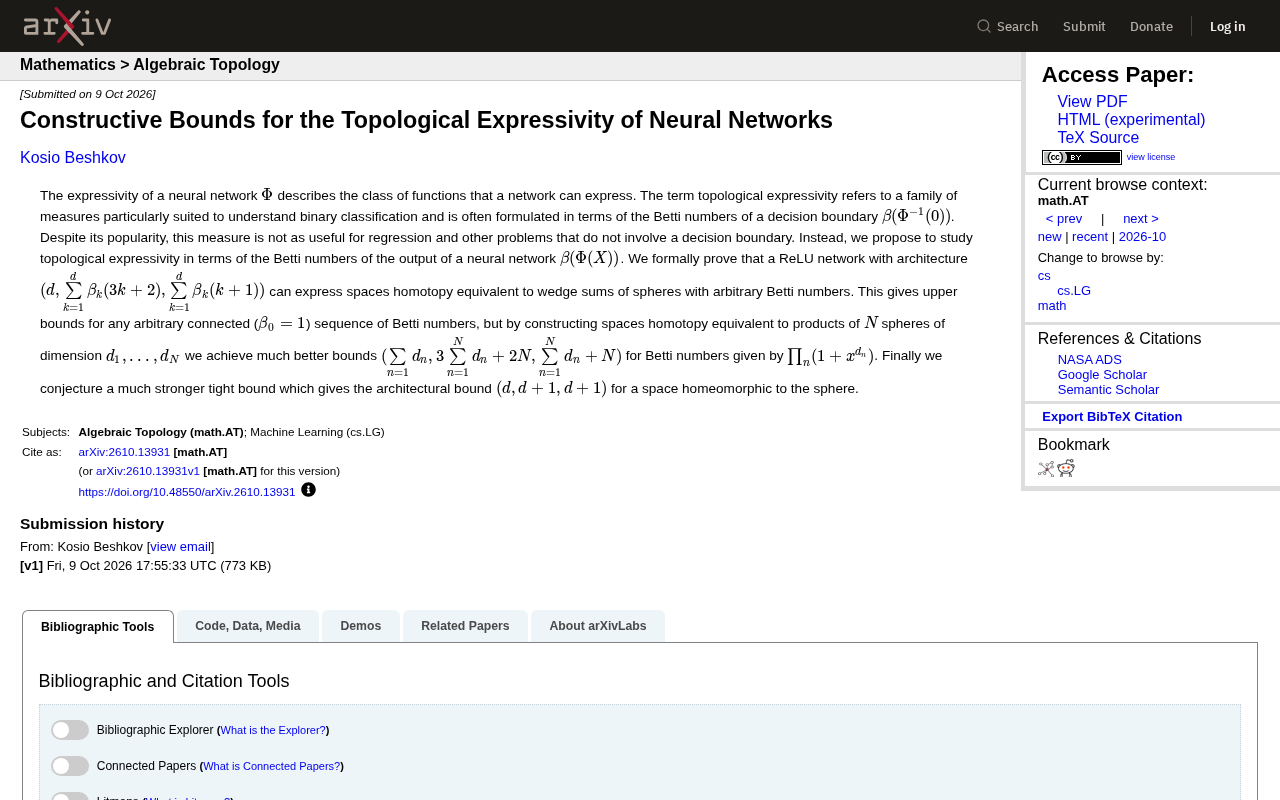
这篇论文重新审视了神经网络拓扑表达力的度量方式。传统方法以决策边界的贝蒂数为核心,仅适用于二分类场景;作者转而研究网络输出空间本身的拓扑复杂度 β(Φ(X)),使度量框架推广至回归等任意任务。论文的核心贡献是构造性的:证明特定宽度的两层隐藏ReLU网络能够表达与球面楔和同伦等价、具任意贝蒂数的空间,并给出明确的架构公式;进一步通过球面乘积构造获得更高效的边界,揭示结构化拓扑复杂度可被网络指数级压缩表达。最后,论文提出了球面同胚空间的极简紧边界猜想 (d, d+1, d+1),为后续研究指明了方向。
为什么拓扑表达力值得重新审视
神经网络的表达力(expressivity)衡量一个网络能够表示的函数类别,是理解深度学习模型能力上限的核心概念之一。在众多度量方式中,拓扑表达力(topological expressivity)尤其适合刻画二分类问题——它通常用决策边界的贝蒂数(Betti numbers)$\beta(\Phi^{-1}(0))$ 来表示。贝蒂数是拓扑学中描述空间"洞"数量的不变量:$\beta_0$ 对应连通分量数,$\beta_1$ 对应一维环路,更高阶的 $\beta_k$ 则对应高维空洞。
这篇研究指出了一个长期被忽视的局限:基于决策边界的度量虽然流行,但对回归问题以及其他不涉及决策边界的任务并不适用。既然没有决策边界,那套以 $\Phi^{-1}(0)$ 为中心的分析框架就失去了着力点。
贝蒂数来自代数拓扑中的同调理论(homology theory),是描述拓扑空间"孔洞"结构的整数序列。直观地说,$\beta_0$ 计数空间中互不相连的"块"的数量,$\beta_1$ 计数一维环路(如圆环中间那个洞),$\beta_2$ 计数被封闭曲面包围的空腔(如球壳内部),以此类推。两个拓扑空间同胚(形状相同)时,它们的所有贝蒂数必然相等,因此贝蒂数是强有力的拓扑不变量。在机器学习语境下,用贝蒂数衡量决策边界的复杂度可以精确描述网络能够分离多少"块"或包围多少"洞"状区域,这是单纯计数线性区域所无法捕捉的几何信息。
换一个视角:研究输出空间的拓扑
作者提出的核心转变在于:不再分析决策边界的拓扑,而是直接研究网络输出的拓扑结构 $\beta(\Phi(X))$。这个视角的优势在于通用性——无论是分类还是回归,网络总会有一个输出空间,因此输出空间的拓扑复杂度成为一个更普适的表达力度量。
这种转变并非仅仅是形式上的替换。它把问题从"网络能切出多复杂的分界面"重新表述为"网络能把输入空间映射成多复杂的几何对象"。对于需要保持或生成复杂几何结构的任务(如流形学习、生成建模),后者显然是更贴切的刻画方式。
构造性上界:用 ReLU 网络表达球面楔和
论文的主要定理给出了一个构造性结果(这意味着不仅证明存在,还给出了具体架构)。作者证明,一个具有如下架构的 ReLU 网络:
$$\left(d,\ \sum_{k=1}^{d} \beta_k(3k+2),\ \sum_{k=1}^{d}\beta_k(k+1)\right)$$
能够表达与球面楔和(wedge sums of spheres)同伦等价的空间,且这些空间可以拥有任意的贝蒂数。这里的三元组分别对应输入维度、第一隐藏层宽度和第二隐藏层宽度。
这一结果为任意连通($\beta_0=1$)的贝蒂数序列提供了明确的架构上界。换言之,给定你希望网络输出达到的拓扑复杂度,这个公式直接告诉你需要多宽的网络就足够了——这正是构造性边界的实用价值所在。
楔和(wedge sum)是拓扑学中组合两个空间的一种基本操作:将两个空间各取一个基点,然后把这两个基点粘合为同一个点。例如,两个圆圈的楔和形如字母"∞",两个球面的楔和则是两个球面共享一个切点。楔和的重要性质是其同调群(进而贝蒂数)等于各因子同调群的直和,这意味着通过取若干不同维度球面的楔和,可以精确"拼装"出任意指定的贝蒂数序列。这正是作者用楔和构造来覆盖任意拓扑复杂度的核心逻辑——它提供了一个模块化的拓扑"积木"系统,使构造性证明变得可行且宽度代价可计算。
乘积结构带来的更紧边界
楔和构造虽然通用,但宽度随贝蒂数线性累加,代价不低。作者进一步通过构造与 $N$ 个球面(维度分别为 $d_1,\dots,d_N$)乘积同伦等价的空间,获得了显著更优的边界:
$$\left(\sum_{n=1}^N d_n,\ 3\sum_{n=1}^N d_n + 2N,\ \sum_{n=1}^N d_n + N\right)$$
此时对应的贝蒂数由多项式 $\prod_n (1+x^{d_n})$ 给出。乘积空间的妙处在于:它用相对较小的架构就能产生指数级丰富的贝蒂数组合——因为乘积的贝蒂数是各因子贝蒂数的张量积展开,一个 $N$ 球面乘积能自然生成 $2^N$ 量级的拓扑特征,而网络宽度仅随 $\sum d_n$ 和 $N$ 线性增长。
这揭示了一个深层直觉:结构化的拓扑复杂度比"散装"的复杂度更容易被神经网络高效表达。通过乘积而非直接堆叠的方式组织目标空间,可以大幅压缩所需的网络容量。
拓扑空间的乘积(product)与楔和在贝蒂数行为上截然不同。根据Künneth公式,乘积空间的贝蒂数由各因子贝蒂数的卷积(即多项式乘法)决定:若空间 $A$ 的贝蒂数生成多项式为 $P_A(x)$,空间 $B$ 为 $P_B(x)$,则 $A\times B$ 对应 $P_A(x)\cdot P_B(x)$。这正是文中 $\prod_n(1+x^{d_n})$ 的来源——每个 $d_n$ 维球面的生成多项式为 $1+x^{d_n}$($\beta_0=\beta_{d_n}=1$,其余为零),$N$ 个球面的乘积则将这些多项式相乘,自然产生 $2^N$ 个非零贝蒂数。这种指数级的拓扑丰富性对应着极为温和的架构代价,是乘积构造在表达力效率上远优于楔和构造的根本原因。
一个更强的紧边界猜想
论文最后提出了一个颇具雄心的猜想:对于与球面同胚的空间,存在更强的紧边界,对应架构为:
$$(d,\ d+1,\ d+1)$$
如果这个猜想成立,意味着表达一个 $d$ 维球面只需要宽度为 $d+1$ 的两层隐藏结构——这是极其节俭的架构。它暗示着 ReLU 网络在表达基础拓扑对象时可能存在远比当前已证上界更优的效率。
从理论意义上看,这个猜想把问题推向了"最优表达"的方向:现有的构造性结果给出了充分条件,而紧边界则试图逼近必要条件。两者之间的差距正是未来研究值得深耕的空间。
对实践与理论的启示
这项工作对深度学习理论社区有几层价值。其一,它拓宽了拓扑表达力的适用范围,使其不再局限于分类任务;其二,构造性证明直接给出了可操作的架构配方,而非抽象的存在性论断;其三,乘积构造揭示了拓扑复杂度与网络容量之间的非平凡关系,为理解"为什么深度网络能高效表示复杂几何"提供了新线索。
当然,作为一篇偏理论的研究,其结论与实际训练出的网络行为之间仍有距离——表达力描述的是"能表示什么",而非"能否被梯度下降学到"。但清晰的架构上界与那个诱人的紧边界猜想,无疑为后续研究树立了明确的目标。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。