识别却不会生成:LLM在文化亲属称谓上的评估盲区

LLM亲属称谓选择题正确率高达90%,但实际生成仅36%,揭示多项选择评估系统性高估模型能力。
一项针对开源大语言模型的研究揭示了多项选择评估与实际生成能力之间的巨大鸿沟。在印地语、泰米尔语和韩语三种非西方语言的亲属称谓任务中,GPT OSS 120B的选择正确率高达90.67%,但生成正确率仅为36.00%;Llama 3.3 70B的差距同样悬殊(77.92% vs 24.24%)。即便明确指定目标语言,各模型生成表现依然低迷且分化严重。研究还发现"父系血缘优势"具有语言特异性——在印地语中明显,在韩语中微弱甚至逆转,反映了不同亲属称谓系统的文化结构差异。研究者由此呼吁在LLM多语言评估中引入生成式测试,以真实反映模型在实际应用场景中的可用性。
一个被选择题掩盖的能力鸿沟
大语言模型(LLM)到底懂不懂不同文化中复杂的亲属称谓?过去的研究大多用多项选择题来考察,把它当作一个"识别"任务。但这篇arXiv新论文提出了一个尖锐的质疑:选对答案,不等于能自己说出来。
研究团队让五个开源权重模型在印地语、泰米尔语和韩语这三种非西方语言中生成亲属称谓,并搭配了一个对照实验——同样的关系,给出四个候选项让模型选择。结果揭示了一道触目惊心的鸿沟。
90% vs 36%:选择与生成的巨大落差
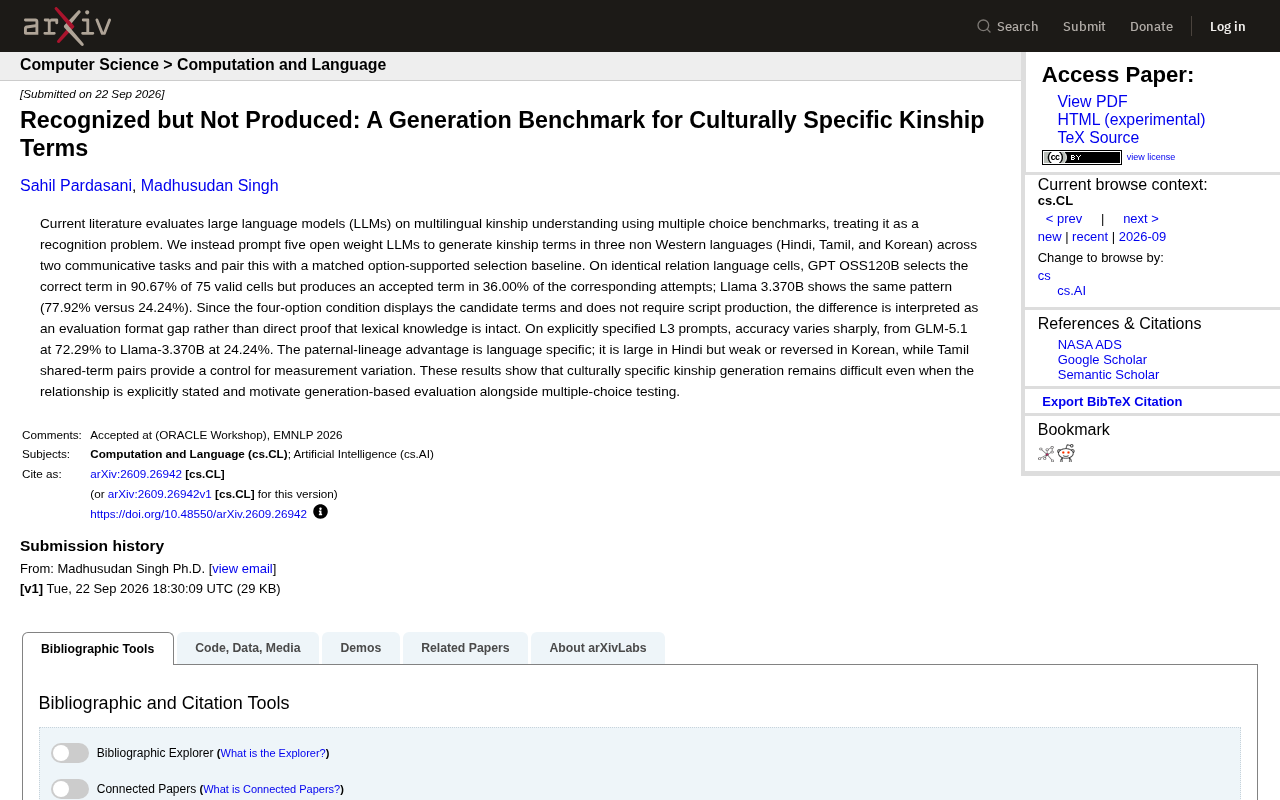
在完全相同的"关系-语言"单元格上,GPT OSS 120B在75个有效单元中有**90.67%能选对正确称谓,但当要求它自己生成时,只有36.00%**的尝试能产出被接受的答案。
Llama 3.3 70B也呈现完全一致的模式:选择正确率77.92%,而生成正确率仅24.24%。
这种落差意味着什么?研究者的解读相当克制。由于四选一的条件直接展示了候选词,且不需要模型自己书写目标文字(script production),因此这种差距应被理解为"评估格式差距(evaluation format gap)",而非直接证明模型的词汇知识完好无损。换句话说,我们无法简单地说"模型其实知道,只是懒得写"——生成任务考察的能力维度确实不同。
这种"评估格式差距"在认知科学中有对应的概念基础:**再认(recognition)与回忆(recall)**是两种不同的记忆提取方式。再认任务(如多项选择)只需要在看到正确答案时识别出它,而回忆任务(如生成)则要求从内部知识中主动检索并输出。经典心理学实验早已证明,人类在再认任务上的表现系统性地优于回忆任务。LLM出现类似分离并不令人意外,但量级之悬殊——差距超过50个百分点——揭示了一个对实际部署影响深远的问题:当用户需要模型直接"写出"一个亲属称谓时,它的可靠性远低于基准测试所呈现的水平。
明确给出关系,模型依然力不从心
研究还设置了一个更有说服力的条件:在提示词中明确指定目标语言(L3 prompts),排除模型"没听懂题"的可能性。
即便如此,各模型表现差异极大——GLM-5.1达到72.29%,而Llama-3.3 70B仅有24.24%。这说明即使关系被清楚地陈述出来,生成文化特定的亲属称谓仍然是一项艰难的任务。这一点尤其重要,因为它排除了"理解偏差",把问题真正定位在了"生成能力"本身。
父系血缘优势的语言特异性
论文一个有趣的发现是关于"父系血缘优势"(paternal-lineage advantage)——即模型是否更擅长父系一侧的称谓。
结果表明这种优势是语言特异的:在印地语中优势明显,但在韩语中却微弱甚至逆转。而泰米尔语中的"共享词对"(shared-term pairs)则被用作对照,帮助控制测量误差带来的干扰。
这一发现提醒我们,亲属称谓系统深植于各自的文化与语言结构中。印地语的父系亲属词汇区分度高,而韩语有着自己独特的敬语和亲属划分逻辑,模型在不同文化间的表现无法一概而论。
理解这一发现需要了解三种语言在亲属系统上的根本差异。印地语属于印欧语系,保留了精细的父系/母系亲属区分词汇(如父亲的兄长"taau"与母亲的兄长"maama"截然不同),词汇系统本身编码了父系优先的文化逻辑。韩语则有一套以说话者性别和相对辈分为核心的敬语亲属体系(如"오빠/형"等),父系与母系的区分逻辑与印地语不同,某些称谓在两侧甚至共享。泰米尔语作为达罗毗荼语系代表,其亲属系统以"交表婚"传统为背景,存在大量同时适用于父系和母系亲属的共享称谓(shared-term pairs),这也是研究者将其用作测量误差控制基准的原因。训练语料中三种语言的文本量和文化知识密度的差异,叠加各自亲属系统的结构复杂性,共同导致了模型表现的语言特异性。
对评估方法论的启示
这项研究最核心的贡献,是对当前LLM多语言能力评估范式的反思。
长期以来,多项选择题因其易于量化、便于自动化评分而成为主流。但本文的数据清楚地表明:多项选择会系统性地高估模型的实际生成能力。一个在选择题上拿90分的模型,真正开口时可能只有36分的水平。
因此,作者主张在多项选择测试之外,引入基于生成的评估(generation-based evaluation)。这对于低资源语言、文化特定知识这类场景尤为关键——因为真实世界的应用需要模型"产出"正确内容,而不仅仅是"认出"正确内容。
对于关注模型在非英语、非西方文化语境下真实可用性的研究者和产品团队来说,这是一个值得警惕的信号:跑分漂亮,未必代表真的能用。
低资源语言(low-resource languages)指训练数据规模有限、NLP工具链不完善的语言,通常与高资源语言(如英语、中文)形成对比。印地语、泰米尔语和韩语在全球互联网语料中占比远小于英语,但三者之间差距同样显著——印地语拥有相对较多的数字化文本,而泰米尔语的网络语料密度则更低。这一背景使得本研究的发现更具警示意义:模型对文化特定词汇的生成能力,不仅受限于语言本身的资源量,还受制于该词汇在语料中出现时是否携带了足够的结构化语境。一个亲属称谓即使多次出现在训练数据中,若总是以被动识别而非主动使用的方式呈现,模型同样难以习得稳定的生成能力。
相关推荐

好莱坞的真正对手:免费内容的降维打击
Skydance 收购华纳和派拉蒙后高喊对标硅谷,但好莱坞真正的对手是 TikTok、Instagram 和 YouTube——它们几乎不为内容付费。本文剖析免费内容大军、硅谷版权侵权文化与 AI 训练数据争议背后的成本结构之战。

KernelAgent:多智能体自动优化GPU内核,跨硬件超越专家基线
Meta 推出的 KernelAgent 是一套多智能体 GPU 内核优化框架,能自动编写并优化内核,在 GPU、TPU、AMD 及 Meta 自研 AI 芯片等异构硬件上超越专家基线。本文解析其设计思路与应用价值。

Alexa Plus一年实测:智能家居之王,为何仍走不出家门?
The Verge播客实测Alexa Plus近一年:语音创建自动化场景体验出色,成为最强智能家居助手,但跨出家门做通用助理却屡屡碰壁。亚马逊500美元新平板欲补个人情境短板,苹果Siri AI也将入场,智能家居之争背后是技术成熟与隐私信任的深层张力。