实测GPT-6 Astra一次生成还原Bad Apple动画能力

用SVG还原Bad Apple,测试GPT-6 Astra跑分背后的真实动画生成能力。
文章记录了一次对GPT-6 Astra的硬核实测:在官方基准跑分亮眼、社区二创热度高涨的背景下,作者选择以经典黑白剪影动画Bad Apple为目标,要求模型一次性生成动画,并强制以SVG矢量代码形式输出,以杜绝直接调用现成素材的可能。Bad Apple以其高帧数、连续形变的特点,对模型时序连贯性和画面稳定性构成严苛考验,而SVG格式要求则进一步验证模型是否真正"理解"画面结构而非检索图像。文章的核心立场是:高跑分不等于实际生成能力,真正有价值的评估应来自具体的、有约束的硬任务,而非单一数字指标。
从跑分神话到实际动手
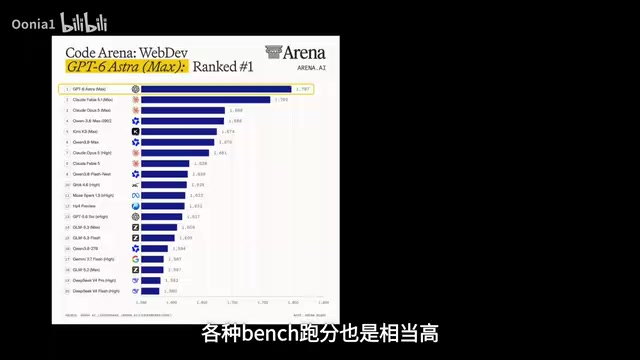
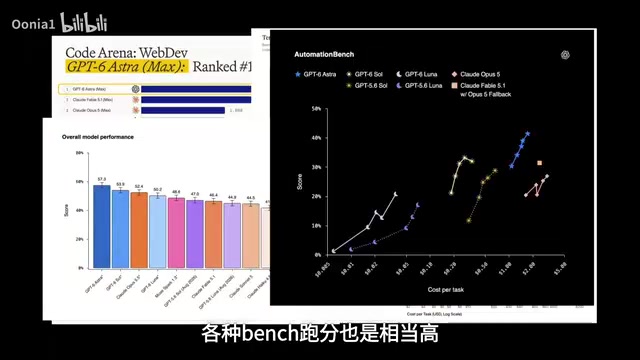
GPT-6 Astra近期在AI社区引发大量讨论,官方宣称其能力接近某些前沿指标,各类基准测试(benchmark)跑分也相当亮眼。围绕它的演示视频和二创内容层出不穷,但跑分高不等于实用能力强,真正的考验往往在具体任务里。
本次实测选择了一个颇具挑战性的目标:让GPT-6 Astra一次性生成动画,尝试还原经典的Bad Apple MV。Bad Apple以其纯剪影、高帧数、连续动作的特点,长期被视为测试渲染与动画连贯性的经典素材。
为什么选Bad Apple做测试
Bad Apple的难点在于它是一段完整的、由剪影构成的动态影像,对生成模型的时序连贯性、画面稳定性提出了很高要求。此前作者本人在游戏活动的拼图/搭建活动中曾手动复刻过Bad Apple,深知这类任务的工作量与细节把控之难。
据称Astra在“一次性生成动画”方面表现突出,这正是本次测试想验证的核心:模型能否在单次生成中保持连续帧的一致性,而不是简单拼接静态图。
Bad Apple!! 是2009年围绕东方Project同人文化诞生的一首歌曲配动画,原版由Masayoshi Minoshima编曲、nomico演唱,动画部分由anira制作,以纯黑白剪影呈现大量东方Project角色的流畅过渡与变形。由于其画面风格极简(仅黑与白)却动作复杂、帧数密集,且在互联网上极具辨识度,它逐渐成为技术圈的"万能基准演示"——从早期的Minecraft红石电路到示波器显示、Game of Life元胞自动机,几乎每种能输出图像的系统都曾被玩家用来跑一遍Bad Apple。这种文化背景使得"能不能跑Bad Apple"本身带有一种对系统极限的测试意味,用它来评估AI生成动画的能力,既有社区共识基础,又有充分的难度保证。
用SVG绘制避免直接扒素材
为了避免模型直接调用或抄袭现成的MV素材,本次测试特别要求它用SVG(矢量图形)的方式来绘制画面。这一约束有双重意义:
- 验证真实生成能力:SVG绘制需要模型理解画面结构并用代码描述,而非检索已有图像资源;
- 考察代码化输出:矢量绘制考验模型将视觉内容转化为结构化代码的能力,更能反映其底层理解水平。
这种方法能更公平地评估模型是“真会画”还是“会找现成的”。
SVG(Scalable Vector Graphics,可缩放矢量图形)是一种基于XML的开放标准格式,用代码描述点、线、曲线和形状,而非存储像素信息。与位图(PNG、JPG)不同,SVG在任意分辨率下都不会失真,且文件内容完全可读、可审计。对AI模型而言,生成SVG意味着需要将视觉意图转化为精确的几何坐标和路径指令(如 <path d="M 0 0 L 100 100"/>),这要求模型对画面结构有真正的"理解",而非依赖图像检索或风格迁移。Bad Apple以大量流动的有机剪影曲线为主,用SVG路径来描绘这些形状的难度远高于简单几何图形,因此将SVG格式作为约束条件,能有效拦截"记忆并复现训练数据中已有图像"的捷径,是一种颇具设计感的测试手段。
高跑分背后的真实能力思考
当前AI模型的宣传常常聚焦于基准测试分数,但分数与实际生成质量之间存在落差。像Bad Apple这样的动画还原任务,比单纯的问答或图像生成更能暴露模型在长序列一致性、细节保真度上的短板。

从社区反应看,围绕Astra的二创和演示已经相当丰富,但真正用严格约束(如禁用现成素材、强制SVG输出)去测试的案例并不多。这类动手实测的价值,正在于给出跑分之外的参考维度。
AI基准测试(Benchmark)通常针对特定子能力设计,例如数学推理(MATH、GSM8K)、代码生成(HumanEval)、知识问答(MMLU)等,这些测试集在模型训练或后期对齐阶段可能被过度优化,导致"刷榜"现象——模型在测试集上的表现远优于真实使用场景,这一问题业界称为"benchmark contamination"(基准污染)或过拟合。像连续动画生成这类开放式、长序列的创意任务,既没有标准答案可供记忆,又对上下文一致性有持续要求,天然能绕开大多数刷榜手段,是衡量模型真实泛化能力的有效补充维度。
小结
GPT-6 Astra是否名副其实,需要更多类似的实际任务来检验。用SVG还原Bad Apple这样的测试,提供了一种绕开素材抄袭、聚焦真实生成能力的思路。对于关注AI生成能力的用户来说,与其看跑分,不如看它在硬骨头任务上的实际表现。
(注:本文基于B站UP主的实测视频整理,具体生成效果与细节以原视频演示为准。)
相关推荐

Agent Gateway 接入 Cloud Trace:AI智能体请求的端到端追踪
Google Cloud 的 Agent Gateway 现已集成 Cloud Trace(预览阶段),可将一次 AI 智能体请求的智能体、网关、工具与 MCP 服务器全部调用收拢到同一条端到端追踪链路,基于 OpenTelemetry 标准实现,帮助开发者精准定位性能瓶颈。
OpenAI遭遇黑客入侵 Altman面临法律风险累积
OpenAI在内部调查中发现系统遭黑客入侵,CEO奥特曼同时面临法律风险累积。本文梳理AI公司数据安全隐患、企业治理争议与合规挑战,分析事件背后的行业启示。

mcp.so 实用指南:一站式发现MCP服务器扩展AI编程能力
mcp.so 是一个发现 MCP 服务器的目录平台,帮助 AI 编程开发者为智能体连接外部工具和服务。本文介绍它的功能、使用方法以及对 AI 工作流的价值。