Sakana Fugu vs GLM 5.2实测:谁能真正挑战顶级AI模型

又一场模型军备竞赛
过去一周,AI社区涌现出两个据说能挑战顶级闭源模型的新选手:一个是来自Sakana AI的Fugu,另一个是来自中国的开源模型GLM 5.2。每周都有新的"霸主"冒出来,追新令人疲惫。本文基于B站UP主杰克在Hermes智能体环境下的实测,帮你厘清这两个模型的真实表现,以及在实际工作流中该如何选择。
值得先说明的是:这两个测试都不是纸面跑分,而是放进真实的Agent工作流(Hermes智能体 + Cloud Code)里,用统一提示词、独立环境进行横向对比。这种"实战"评测比刷榜更能反映模型在生产环境下的可用性。
关于测试环境背景:Hermes是一种面向生产工作流设计的AI智能体框架,其核心设计理念是将复杂任务分解为可编排的技能模块(Skills),每个技能模块可独立绑定最优模型。Cloud Code则是Anthropic推出的面向开发者的代码执行环境,支持模型直接读写文件、运行代码、调用终端命令,是目前业界在真实代码库上进行智能体操作的主流方案之一。将两者结合的评测方式,代表了当前AI Agent落地最典型的技术栈:模型负责规划与生成,工具层负责实际执行,框架层负责状态管理与多步协调。这种架构下,模型的工具调用稳定性、长上下文理解能力和输出格式规范性,远比单轮问答的准确率更能决定系统整体可靠性。
两个选手的定位差异
要理解这次对比,首先得明白两个模型的本质区别。
Fugu本质上不是一个模型,而是一个智能路由(Router)。当你通过API与Fugu对话时,它背后隐藏着一个前沿模型池——Gemini、Opus、ChatGPT、MiniMax等。Fugu经过专门训练,能根据问题类型自动调度最合适的模型。官方将其定义为"一个API背后的多智能体系统"。
智能路由是一种元调度机制,其核心思想是"让最合适的模型处理最擅长的任务"。从技术架构上看,路由层通常由一个轻量级分类模型构成,它分析输入请求的语义特征(如代码、数学推理、创意写作、工具调用等),然后将请求转发至后端模型池中的最优候选。这一思路并不新颖——早在2023年,Martian、RouteLLM等项目就在探索如何用小模型替代大模型完成"路由决策",以降低整体推理成本。路由系统的演进经历了三个阶段:早期依赖人工规则(关键词匹配、任务类型枚举),中期演进为基于嵌入向量相似度的语义路由(通过计算输入与各模型"专长描述"之间的余弦相似度做决策),近期则发展为以轻量级判别模型(如BERT变体或经过蒸馏的小型LLM)驱动的端到端路由——这类模型在大量"任务类型-最优模型"标注数据上微调,能够以毫秒级延迟完成决策。然而,随着路由精准度的提升,分类粒度也随之细化,导致所需标注数据量呈指数级增长,形成"精准度越高、维护成本越高"的内在矛盾。
Fugu代表了最新一代方案:将路由与多智能体编排深度融合,试图在单一API入口后构建一个自适应的模型联邦。然而路由系统的收益需要覆盖额外的往返延迟和令牌开销才划算——而本次实测表明,Fugu在多个任务上尚未达到这一平衡点。路由系统要真正产生价值,需要极低的元调度成本和极高的任务分类精准度,两者缺一不可。
GLM 5.2的定位则截然不同——它是一个开源高性能模型,被称为"开源劳模"。最大卖点在于成本:据称能达到接近甚至超越Opus 4.8的效果,价格却只有六分之一,还支持百万级上下文窗口,支持本地运行。
GLM(General Language Model)系列由清华大学KEG实验室与智谱AI联合研发,其技术路线与GPT系列的自回归(Autoregressive)架构有所不同——早期GLM采用自回归填空(Autoregressive Blank Infilling)训练目标,兼顾了双向理解与生成能力。这一独特的训练目标使模型在理解不完整语境时表现出更强的鲁棒性,但也带来了与主流生态适配的额外工程成本。GLM-4系列起,模型架构向主流Transformer解码器靠拢,并大幅提升了代码和数学推理能力——这一向主流架构的收敛决策,使其更容易复用社区积累的推理优化方案(如量化、投机解码等),也为工具调用能力的对齐奠定了基础。GLM 5.2支持百万级上下文窗口(1M tokens),这得益于其采用的RoPE位置编码扩展技术(如YaRN或类似方案):RoPE(Rotary Position Embedding,旋转位置编码)通过将位置信息编码为查询向量和键向量之间的相对旋转角度,在理论上具备更强的长度外推能力;YaRN等改进方案则进一步通过温度缩放和插值策略,在不重新训练的情况下将有效上下文长度从训练时的范围外推数倍。结合FlashAttention等内存优化方案(将注意力计算的显存占用从O(n²)降低至近似线性),使超长序列的推理在实际硬件上具备可行性。对于需要处理超长代码库或文档的Agent场景,超长上下文是一个关键的实用优势,而非单纯的营销数字。

测试一:工具调用能力
第一关考验模型调用工具的能力——这对Hermes这类智能体至关重要,却常被低估。测试任务是通过Zapier MCP查询Outlook邮箱最新邮件的主题行,三个模型(Fugu、GLM 5.2、Opus 4.8)在各自独立环境中用相同提示词执行。
工具调用协议背景:工具调用(Tool Calling / Function Calling)是现代AI Agent的核心能力之一,其本质是让语言模型以结构化方式输出"我需要调用哪个工具、传入哪些参数",然后由外部执行器完成实际操作并将结果返回给模型。这一能力对稳定性要求极高:模型必须能正确解析工具的JSON Schema定义、生成合法的参数格式,并在工具返回错误时进行合理的错误处理和重试。Function Calling能力的训练通常需要大量"工具调用示范数据"进行监督微调(SFT),并结合强化学习从人类反馈(RLHF)或基于规则的奖励(RLAIF)来提升格式合规率。MCP(Model Context Protocol)是Anthropic于2024年底推出的开放协议标准,旨在统一AI模型与外部工具、数据源之间的接口规范。MCP协议在技术架构上采用JSON-RPC 2.0作为底层通信协议,定义了工具注册(Tool Registration)、能力声明(Capability Declaration)和流式响应(Streaming Response)等标准接口——这意味着符合MCP规范的工具(如Zapier MCP)可以被任何适配了MCP客户端的模型直接调用,无需额外编写胶水代码。然而,该协议仍处于快速演进阶段,其工具描述格式、错误码规范和流式响应支持在不同版本间存在差异——这也部分解释了GLM 5.2在本次测试中首次调用失败的现象。
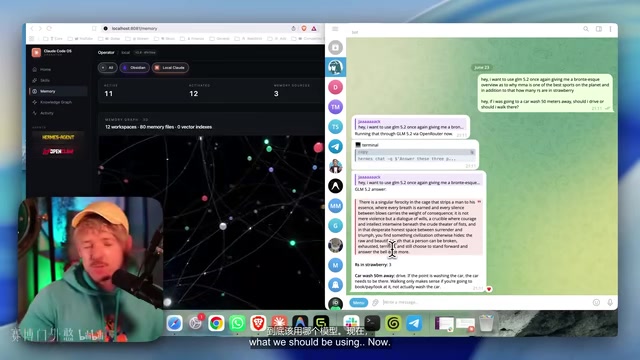
结果颇具反转意味:
- Fugu赢得了这项任务,消耗约23万个令牌,且令牌消耗最少(甚至比Opus 4.8还省)。
- Opus 4.8答对了,但多消耗了约60%的令牌。
- GLM 5.2则失败了——第一次未能正确调用工具,重试到第三次才成功。
这个结果暴露了GLM的明显短板:它的强项在编码,但工具调用的稳定性存疑。GLM 5.2在第一轮测试中的失败,很可能源于其对Zapier MCP这一特定工具协议的适配不够成熟——这类协议适配问题往往不反映模型的底层推理能力,而是反映其在特定工程生态中的集成成熟度。不过从延迟看,GLM反而是三者中最快的(43 vs Opus的154)。这说明GLM并非能力不足,而是在Agent工具协议对接上还不够稳定。
值得注意的是,工具调用失败的成本在Agent工作流中会被放大:一次失败不仅消耗额外令牌(重试意味着重新传入完整上下文),还可能打断整个任务链的执行状态,导致后续步骤无法承接前置结果。因此,工具调用的首次成功率(First-Call Success Rate)是衡量模型在生产环境可靠性的关键指标之一,而非仅看最终是否完成任务。从系统工程角度而言,一个首次成功率95%的模型与85%的模型,在100次任务执行中的失败次数差距高达10次——而每次失败的重试链路往往会消耗原始任务2至3倍的令牌,这一复合效应在高并发场景下会对成本和系统稳定性产生显著影响。更深层的风险在于,Agent工作流中的任务链通常具有有向无环图(DAG)结构,一个节点的失败会阻断其所有下游节点的执行,导致整个图的完成率以非线性方式下降——这意味着在多步骤、强依赖的复杂任务中,工具调用稳定性的权重应远高于其在单轮测试中呈现的表面权重。
测试二:前端网站生成
第二关要求三个模型分别创建一个气泡水品牌的单页网站,视觉需具吸引力,包含三个页面模块。评判标准以美观度为主。
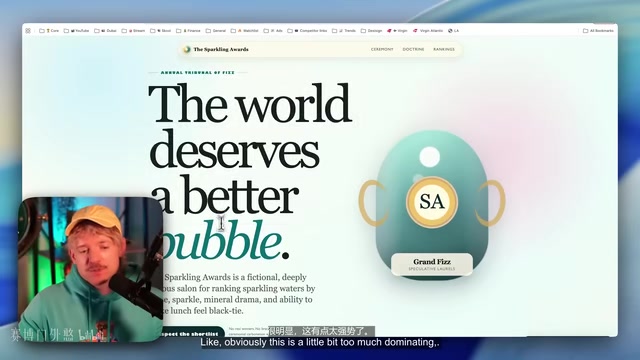
从视觉效果看,GLM 5.2的输出遥遥领先——气泡特效最为出色,被评为本轮赢家。Fugu的作品"还行",但气泡效果沉到了底部,略显刻意。Opus 4.8的版本偏基础,元素过大、比例失调。
更值得关注的是成本对比:
- Fugu Ultra消耗了77.6万个令牌,对于其输出量而言明显偏高,等待时间比Opus 4.8长3至5倍,质量提升却相当有限。它内部共调用了15次API。
- GLM 5.2的令牌数是三者中最少的,速度与Opus基本持平。
令牌经济学背景:令牌是语言模型处理文本的基本单位,大致上英文每个单词约对应1.3个令牌,中文每个汉字约对应1.5至2个令牌(基于BPE或SentencePiece分词算法)。在Agent工作流中,每一轮工具调用都会产生输入令牌(历史上下文 + 工具定义 + 工具返回结果)和输出令牌(模型响应),多轮对话的令牌成本会随对话深度指数级累积——这种现象被称为"上下文膨胀"(Context Inflation)。Fugu内部调用15次API,意味着其路由机制本身就引入了大量额外的元信息传输开销:每次路由决策需要将任务描述、历史上下文和路由元数据同时传递给分类模型,再将转发结果回传,实质上是在每次实际推理之前插入了一次隐性的"准备推理"。这种"推理前的推理"开销在任务链较长时会产生显著的乘数效应:若单次路由引入5%的额外令牌开销,15次API调用意味着累计引入约75%的额外成本,这在很大程度上解释了Fugu 77.6万令牌的异常消耗。以主流定价参考,若输入令牌按$3/百万、输出按$15/百万计算,单次任务数十万令牌的差异可以直接影响每月数百乃至数千美元的实际账单——这对高频Agent应用场景的选型决策有决定性影响。对于日均执行数千次任务的生产系统,令牌成本往往是除GPU算力之外最主要的运营支出,选型时必须将其纳入TCO(总体拥有成本)核算框架。
换句话说,在这项前端生成任务上,GLM 5.2不仅质量最好,成本也最低——在"初始风格概览"层面明显击败了Opus 4.8。而Fugu的路由机制在这里暴露了核心问题:额外引入的延迟和令牌开销,往往抵消了智能调度带来的收益。
测试三:真实代码库改进
难度最高的一关,是将Hermes和Cloud Code智能体操作系统的真实代码交给三个模型,让它们各自改进"记忆标签页"功能,思路完全开放。
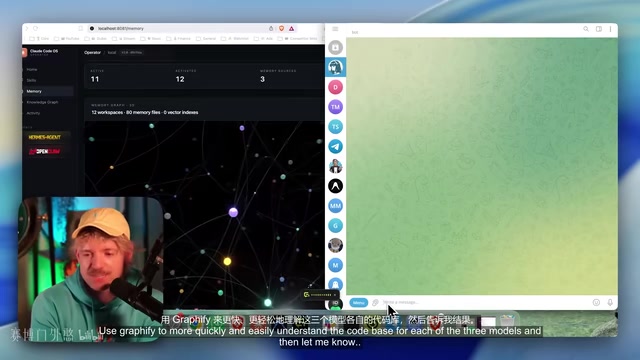
完成时间差异显著:
- Opus 4.8:约3分钟
- GLM 5.2:约6至7分钟
- Fugu Ultra:13至14分钟
从产出质量看,GLM的方案最为出色——它设计了一个"内存健康条",以绿色到黄灰的渐变呈现,兼顾美观与实用。Opus做了个最近活动过滤器,而Fugu的产出与Opus高度相似,却耗费了两倍时间。
这再次印证了核心结论:Fugu本质上只是把多个模型路由在一起,理念上有价值,但引入的延迟代价过高——完成任务的时间常常是Opus的两倍,而GLM的实际速度甚至更具竞争力。在真实代码库任务中,GLM 5.2的百万级上下文窗口也显现出工程价值:能够一次性摄入更大范围的代码上下文,减少因上下文截断导致的理解偏差,这对代码改进类任务尤为关键。
长上下文与代码理解的工程意义:传统上,受限于上下文窗口(如4K、8K、128K tokens),模型在处理大型代码库时不得不采用"滑动窗口"或"分块摘要"等策略,这会导致跨文件依赖关系的理解断层。GLM 5.2的1M token上下文窗口理论上可容纳约75万行代码,使模型能够同时"看到"项目的全局架构与局部实现细节。在代码改进任务中,这意味着模型可以追踪某个变量从定义、传递到最终使用的完整链路,而不是在截断处"猜测"上下文——这种全局感知能力在大型工程项目中往往比单点推理能力更具决定性。然而,超长上下文并不意味着模型能够均匀地"关注"所有内容。现有研究(Nelson Liu等人2023年提出的"Lost in the Middle"现象)系统性地表明:大多数Transformer模型对上下文头部(前几千个token)和尾部(最后几千个token)的信息有更强的注意力偏向,中间段内容的信息检索准确率随上下文长度增加而显著下降。这一现象的根源在于注意力机制的位置偏差(Position Bias):模型在预训练中更频繁地接触较短序列,使得其注意力权重的学习分布对极长序列中间位置的泛化能力不足。对于代码改进任务,这意味着若关键的依赖定义恰好位于百万token上下文的中间段,GLM 5.2的理解准确率可能显著低于其在短序列上的表现——这是1M上下文实际工程价值在更大规模项目中仍需持续验证的核心原因。
谁真的赢了?
必须坦诚:这两个模型都没有真正"干掉"顶级闭源模型。在整体能力上,它们尚未全面超越Claude等前沿模型。但这次测试的真正惊喜来自GLM 5.2。
即便有人坚持认为Opus 4.8更强,这几轮测试也难以给出清晰的支撑。GLM 5.2的表现出乎意料地好,而价格仅为六分之一。从单位令牌换来的性能来看,GLM 5.2的性价比极为突出。 它的短板集中在工具调用的稳定性(尤其是对新兴协议如MCP的适配成熟度),而非核心推理或生成能力。
相比之下,Fugu作为智能路由的理念值得肯定,但实测中它并未成为"终结者"——过高的延迟和令牌开销,让路由带来的收益大打折扣。从行业视角看,当前主流路由方案普遍面临"分类粒度与调度成本的双重困境":粒度越细,分类成本越高;粒度越粗,调度收益越有限。Fugu的实测结果正是这一困境的典型体现。从更深层的系统设计角度看,路由机制的真正价值需要在任务复杂度足够高、后端模型差异足够大的场景下才能体现——只有当某些任务确实需要特定模型的独特能力(如数学推理需要o3、多语言任务需要专项模型),路由带来的质量收益才足以覆盖其引入的延迟与成本开销。对于相对同质化的日常任务,路由引入的额外层级反而成为负担而非赋能。这一结论也为整个路由赛道的产品设计敲响了警钟:路由系统的价值主张,本质上依赖后端模型池的异质性足够高——而随着各主流模型能力趋于均质化,路由的边际收益将持续递减。
在Hermes里如何选型
在Hermes智能体中选择模型,需要在四个维度间权衡:
- 性能:任务完成质量
- 速度:响应延迟
- 隐私:能否本地部署运行
- 成本:单位令牌的开销
推荐的策略是将Hermes变成一个智能"黑盒",根据任务类型自动路由到最合适的模型——而这恰恰是Fugu理论上想做、却执行欠佳的事情。
具体建议如下:
- 复杂推理任务:优先选用GLM或Opus,必要时让两者互相讨论辩证
- 高并发场景:选用DeepSeek广告,性能接近顶级模型但价格极低
- 常用技能模块:在Hermes技能配置中直接指定专属模型,让系统自动匹配
对Agent开发者而言,真正高效的做法是:识别出你80%的操作集中在哪几类常见任务,然后为每类任务分配最擅长它的模型,而不是盲目追逐单一"跑分冠军"。这样既节省时间,也大幅降低成本。这种"任务驱动的模型组合"思路,本质上是将Fugu所追求的自动路由目标,以更低成本的手动规则形式实现——在当前路由技术尚未成熟的阶段,这往往是更务实的工程选择。从实操层面看,建议开发者在选型初期对自身工作流进行任务类型统计(如代码生成占比、工具调用频率、创意生成占比等),以此为依据构建初始路由规则,再通过A/B测试持续优化模型分配策略,最终形成可量化ROI的动态选型体系。值得注意的是,这套手动路由体系本身也需要版本管理:随着各模型能力的快速迭代,上个季度最优的任务-模型映射关系,可能在新版本发布后需要重新校准——建议将模型选型决策记录为可审计的配置文件(而非硬编码逻辑),以降低后续调整的工程成本。
结语
这场"权力更迭"式的模型迭代告诉我们:新模型的价值不在于纸面刷榜,而在于真实工作流中的实际表现。Fugu的路由理念有前景,但落地效果欠佳;GLM 5.2则用六分之一的价格交出了一份令人惊喜的答卷。
对于追求性价比的Agent开发者来说,GLM 5.2值得认真纳入你的模型组合,尤其是在前端生成和代码改进类任务上,它完全具备替代高价闭源模型的潜力。随着MCP等工具协议适配的持续完善,GLM 5.2在工具调用稳定性上的短板也有望在后续版本中得到修复——届时,其综合竞争力将进一步提升。从更宏观的行业趋势看,GLM 5.2的表现也印证了开源模型与闭源模型之间的能力差距正在以超预期的速度收窄:六分之一的价格换来接近顶级闭源模型的性能,这一比价关系若持续演进,将对整个商业AI服务定价体系产生深远冲击——对于预算敏感但性能要求较高的中长尾开发者群体,开源模型的实用价值正在从"可以用"迈向"值得用"的新阶段。
核心要点
核心要点
核心要点
核心要点
核心要点
相关推荐

Felix Rieseberg 个人主页
Felix Rieseberg 个人主页在 Hacker News 引发关注。本文介绍这位 Slack 工程师的技术背景、nativefier 项目的兴衰,以及开发者个人主页作为技术名片的价值。

@ai-sdk/vue 3.0.306 补丁发布 同步 [email protected] 更新
@ai-sdk/vue 3.0.306 发布,与 [email protected] 同步更新。这是 Vercel AI SDK 生态的一次常规补丁发布,无公开 API 变更,Vue 适配层保持与核心包版本对齐。

Gemini 4 Argon API发布:百万级输出Token时代来临
Google 正式发布 Gemini 4 Argon,稀疏 MoE 架构支持最高 100 万输出 token,Vals Index 以 68.90% 登顶,覆盖 API、AI Studio 和 Gemini 应用三端。