实测三元Bonsai 2 9B:速度提升3倍,但生产环境不敢换

Ternary Bonsai 2 9B 虽小又快,却漏掉已确认升级并生成自相矛盾答案,团队最终保留 27B。
团队为降低托管模型成本,测试用 Ternary Bonsai 2 9B 替换生产中的 27B,体积小约三倍、笔记本上预填充快 3.6 倍、生成快 2.4 倍。但回放 1,015 条生产决策后发现:任务 A 中 9B 把 65 条已确认升级里的 15 条降级为 clarify,且给出 0.85–0.9 的高置信度低严重度标签,置信度阈值无法拦截;同时大量案例向 clarify 集中,加权一致率仅 61.2%。任务 B 中 43% 的答案出现「需要干预」与「继续正常」的自相矛盾组合,约束解码无法拦截语义冲突。任务 C 表现较好但样本太少。最终团队决定继续使用 27B,并提出合并输出枚举、9B 初筛加 27B 复核等后续方向。
一次看起来划算的替换
生产环境的分类器跑在一张 RTX 2080 Ti 上,11 GB 显存。高峰期请求经常溢出到托管模型,成本不低。当 PrismML 发布 Ternary Bonsai 2 9B 时,团队看到了一个务实的机会:GGUF 文件只有 2.25 GiB,而正在使用的 27B 是 6.70 GiB,差距接近三倍。
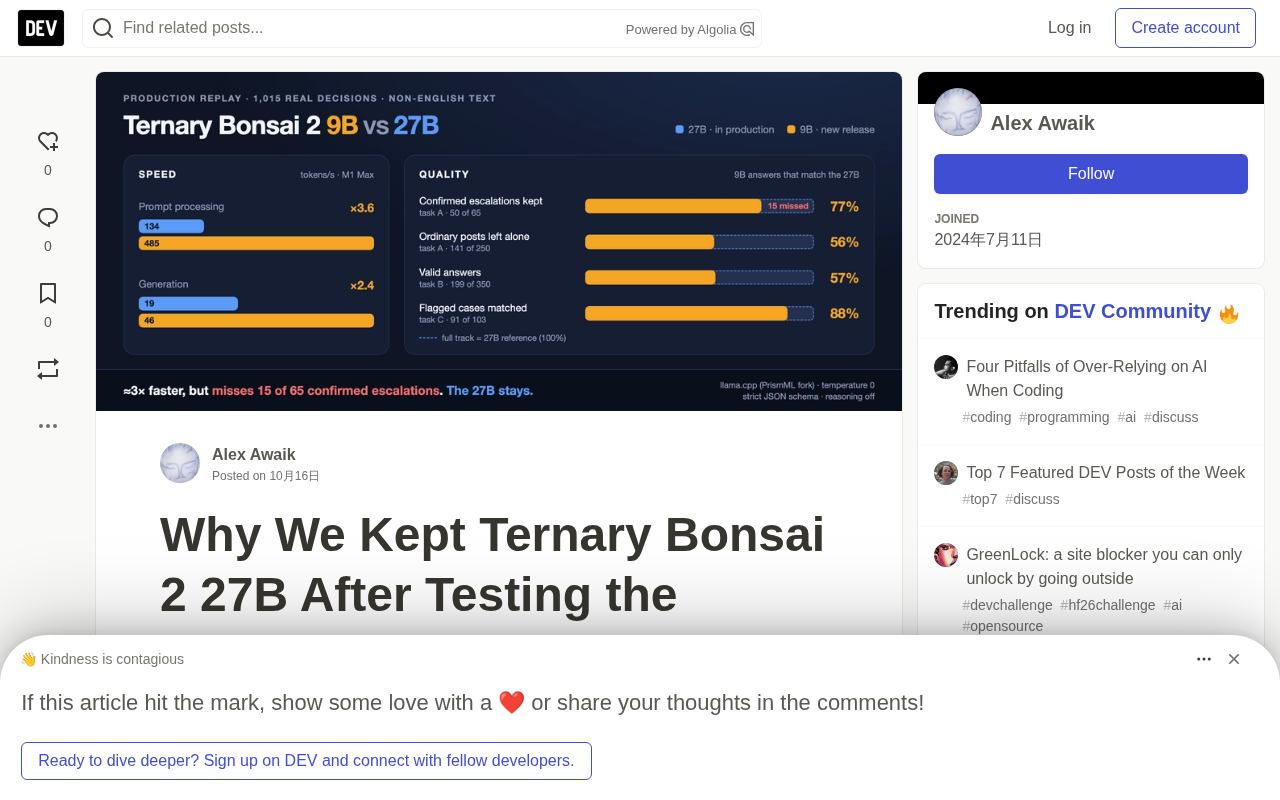
但体积和速度优势,不足以支撑一次直接替换。团队回放了 1,015 条生产决策,在笔记本基准测试中 9B 比 27B 快 2.4–3.6 倍,然而它把 65 条已经被二次模型确认的升级请求中的 15 条降级了。在另一个任务上,43% 的答案违反了应用层规则。这个结果,直接否决了简单替换的方案。
生产环境的真实压力
现有 27B 跑在 llama.cpp 上,使用 PQ2_0 量化权重、两个并行槽位、共享 32k 上下文。推理关闭,响应走严格的 json_schema 解码,温度设为 0。客户端有 8 秒截止时间,网关如果无法在这个预算内分配槽位,就拒绝请求并转由托管模型兜底。
在一个 20 小时的窗口里,系统记录了 9,081 次请求:82% 由本地模型完成,13% 因无法满足截止时间被快速拒绝,4.6% 被客户端取消。最繁忙的一小时里,约 30% 溢出到托管模型。已服务请求的模型时间中位数为 4.3 秒,p95 为 8.1 秒。
应用需要对非正式、非英语的帖子做出三类判断。每个请求包含当前帖子和最多 11 条历史帖子,中位提示长度为 0.7k 到 2.3k token,响应限制在 64–96 token 的 JSON 以内。任务 A 是升级分诊,输出 allow / clarify / escalate 以及严重度子类型和置信度分数,漏掉一次 escalate 是代价最高的错误。任务 B 是干预评估,判断是否需要干预并给出建议动作。任务 C 是多标志检测器,输出六个布尔值。
约束解码(constrained decoding / JSON schema 解码) 指的是在自回归生成过程中,每一步都对模型的输出 logits 施加语法或结构掩码,把不符合目标格式的 token 概率置零,从而保证最终结果一定能被解析器接受。llama.cpp 等运行时通过 JSON schema 或 GBNF 语法实现这一机制。它的关键局限在于:约束只能保证「格式合法」,无法保证「语义自洽」。当 schema 允许某组字段自由组合、而应用真正需要的互斥关系只写在自然语言提示里时,小模型完全可能生成一个可解析却在业务上荒谬的 JSON。这正是任务 B 中「intervention needed: true + continue as normal」得以出现的原因——结构上合法,逻辑上矛盾,只能靠应用层再做一次校验来拦截。
回放测试怎么做的
团队从当前提示版本的生产日志中抽样,刻意保留了稀有结果。任务 A 回放了全部 107 次升级(65 条被确认、42 条被拒绝)、200 条 clarify 和 250 条 allow。任务 B 回放各 175 条“需要干预”和“继续”。任务 C 回放全部 108 条已记录案例。
为了估计生产速率,每个案例按抽样和日志概率加权:weight = (rows in stratum / rows sampled) × (1 / logging probability)。任务 A 的样本代表了约 68k 次生产检查。请求用应用自己的提示构建器重建,使用存储的帖子和线程窗口、相同的 schema、token 限制和温度。在检查的 275 个案例中,提示 token 数与生产完全匹配。
回放在 M1 Max 上进行,27B 使用生产构建 prism-b10709,9B 需要 prism-b10777。由于已有 27B 的日志答案,只在 275 个案例上重跑:一个随机控制子集加上所有任务 A 和 C 的分歧案例。27B 在 275 个生产中复现了 273 个决策,两个边缘差异可能来自 Metal/CUDA 的数值差异。
分层抽样与逆概率加权 是评估稀有事件时常用的统计手段。生产日志里 escalate 这类高代价但低频的结果可能只占百分之几,若按自然比例抽样,回放样本中正例太少,估计方差极大。做法是先按结果分层(stratum),在每个层内以不同比例抽样,再给每个样本赋予权重 weight = (层内总行数 / 层内抽样数) × (1 / 记录概率),使得加权重后的分布重新逼近真实生产分布。日志概率一项用于修正「并非所有请求都被完整记录」带来的偏差。需要警惕的是,加权还原的是期望比例,无法弥补样本量本身的不足——文中任务 C 只有 5 个 none 案例,即使加权也无法可靠估计假阳性率,这正是「一致率尚可但证据太少」的根本原因。
任务 A:更多模糊,更少明确
任务 A 的表现最能说明问题。9B 在所有输出上都是合法 JSON,问题出在里面的决策。
| 生产 27B 决策 | n | 9B 一致 | 9B 差异 |
|---|---|---|---|
escalate(托管模型确认) | 65 | 50 (76.9%) | 15 → clarify |
escalate(托管模型拒绝) | 42 | 34 (81.0%) | 8 → clarify |
clarify | 200 | 184 (92.0%) | 12 → allow,4 → escalate |
allow | 250 | 141 (56.4%) | 109 → clarify |
最要命的是那 15 条被降级的已确认升级。27B 在本地重跑中把它们全部复现为 escalate,其中 12 条带有最严重的明确子类型,3 条是比喻性语言子类型。9B 给这 15 条全部分配了低严重度子类型,自报置信度在 0.85–0.9 之间。也就是说,靠置信度阈值根本拦不住这些错误。
团队自己读了这些案例,约 11–12 条看起来明确为正,3–4 条处于边缘。有些直接陈述了关键信号,有些使用了隐喻或习语。这是非正式审阅,不是专家标注。
更大的转变是向 clarify 集中。按生产量重新加权后,allow 从 27B 的 86.4% 降到 9B 的 49.5%,clarify 从 13.4% 升到 50.1%。加权一致率为 61.2%。9B 从未把升级直接变成 allow,但它把大量两端案例推向了中间。由于澄清在应用中是有成本的,这会影响很大一部分用户。它还使加权升级率翻倍,仅 clarify 层新增的升级就会在日志期内增加约 180 次托管模型审核。
任务 B:合法 JSON 里的自相矛盾
任务 B 暴露了约束解码的边界。在 350 个答案中,有 151 个(43%)返回了“intervention needed: true”同时搭配“continue as normal”。应用直接拒绝这种组合。
| 生产 27B 决策 | n | 9B 一致 | 9B 无效 | 9B 相反 |
|---|---|---|---|---|
| 需要干预 | 175 | 23 (13.1%) | 128 | 24 |
| 继续 | 175 | 148 (84.6%) | 23 | 4 |
JSON schema 允许这种组合,提示词要求模型不要使用它。27B 在控制运行中遵守了这条指令,9B 经常不遵守。约束解码保证了 JSON 可解析,却无法强制执行一个没有写进 schema 的关系。即使只看正向案例中的合法答案,一致性也只有 47 条中的 23 条。重新加权后,约 17% 的任务 B 检查会验证失败并转到托管兜底,反而增加了原本想降低的负载。
量化对模型能力的影响通常不是均匀的。PQ2_0、三元(ternary)等极低位宽方案在权重和激活上引入的误差,对「格式遵循」这类表面能力往往影响较小,因为约束解码和语言先验足以撑住合法输出;但对「多字段之间的逻辑一致性」这类需要深层推理的能力影响更明显。可以这样理解:模型规模下降和量化误差叠加,使 9B 在任务 B 上更容易各自独立地生成每个字段,而不是维护字段之间的约束。团队也意识到这个混淆——他们没跑全精度 Qwen3.5 9B,因此无法区分「是 9B 太小」还是「是三元量化太狠」。要分开这两个效应,需要同一模型的多档量化做对照回放。
任务 C:一致率尚可,但证据太少
任务 C 是三个任务中表现最好的。9B 在 27B 标记为 flagged 或 urgent 的 103 个案例中,有 91 个保持一致(88.3%)。分歧包括五个 flagged 案例降到 none,三个 urgent 案例降到 flagged。
但团队只有五个 none 案例,样本太少,无法估计假阳性。这个任务给出的担忧较少,但证据也同样少得多。
速度快了多少
在 M1 Max 上用 flash attention 跑 llama-bench:
| pp512, tok/s | tg128, tok/s | |
|---|---|---|
27B, prism-b10709 | 134.1 | 19.2 |
27B, prism-b10777 | 142.9 | 19.1 |
9B, prism-b10777 | 484.5 | 45.6 |
对比固定的 27B 构建,9B 在预填充上快 3.6 倍,生成上快 2.4 倍。仅更新运行时几乎没有影响。生产 2080 Ti 上 27B 实测预填充 749 tok/s、生成 42.6 tok/s。按笔记本速度比例推算,检查时间可能从 4.3 秒降到约 1.5–2 秒。但团队没有在 2080 Ti 上实测 9B,这仍是估计。
下一步会试什么
这次测试回答的是 9B 能否用现有提示替换 27B,而不是小模型的最佳表现。提示是为 27B 调优的,两个模型都关闭了推理,也只测试了一个领域的一种语言。同时没有跑全精度 Qwen3.5 9B,因此无法把模型规模效应和三元量化效应分开。
首先值得改的是任务 B 的输出 schema,把布尔值和动作合并成一个枚举,让矛盾组合在结构上不可能出现,然后针对 9B 调优提示并回放相同案例。小的推理预算可能也有帮助,代价是部分速度。
另一个方向是把 9B 作为任务 A 的第一道,把非 allow 的答案交给 27B。在这个样本上,约一半的生产检查可以跳过更大模型,放过约 6% 的 27B clarify 案例,但不放过任何升级。团队没有把这个作为流水线测试过,两个模型同时放在 11 GB 卡上会很紧张,第二跳也会增加延迟。
目前 27B 继续留任。回放生产流量让这个决定变得直接:速度提升是真实的,漏掉的升级也是真实的。任何替换都要过同样的测试,已确认正例不能漏,无效答案不能增加。
级联推理(cascade / 初筛+复核) 是小模型替换大模型时常见的折中架构:用便宜模型处理大部分流量,只把「不确定」或「命中特定类别」的请求送给大模型。设计要点在于选择让谁通过第一跳。文中团队选择了保守策略——9B 的非 allow 输出全部交给 27B,这意味着宁可多跑第二跳,也绝不让第一跳漏掉 escalate。代价是双模型同时驻留 11 GB 显存会很紧张,且每次命中第二跳都会叠加一次推理延迟。另一种思路是反过来:让 9B 只做「高置信度 allow」的放行,其余一律走 27B,模型选择取决于业务对漏报和延迟的相对容忍度。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。