实测Seedance 2.5深度视频:AI复刻多人长镜头动作教程
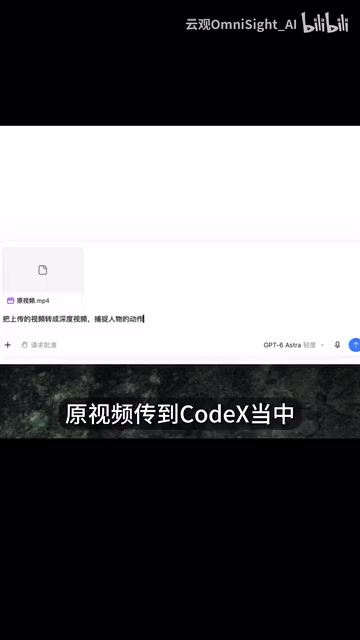
用Seedance 2.5三步工作流:提取深度视频、生成角色素材、Agent合成,在本地GPU上低成本复刻高还原动作视频。
本文介绍了基于Seedance 2.5的AI视频重制工作流,核心思路是将复杂的动作视频生成拆解为三个模块化步骤:首先通过Codex对原始视频进行深度估算,提取保留空间结构与运动轨迹的深度视频,作为动作骨架;其次利用图片生成功能准备主角三视图和背景图,为后续合成提供视觉素材;最后切换至Agent模式,将三类素材统一上传并由AI自动完成合成,输出动作还原度高、画面风格可定制的新视频。该方案支持本地GPU渲染,降低云端算力依赖,尤其适合舞蹈复刻、多人群像等需要精确动作控制的场景,但对硬件性能和素材质量有一定要求。
当AI开始还原真实动作
用AI生成一段动作流畅、还原度极高的长镜头视频,曾经是需要大量后期与动作捕捉设备才能实现的效果。而现在,借助 Seedance 2.5 的深度视频(Depth Video)玩法,普通创作者在家用电脑上就能把一段真实视频转换成可控的AI动画素材。
这套方案的核心思路很直接:先从原始视频中提取「深度信息」和人物动作,再用AI替换主角与背景,从而实现动作一致、画面全新的视频重制。整个过程既保留了原视频中角色的运动轨迹,又能自由更换视觉呈现,这也是它能复刻多人动作长镜头的关键所在。
第一步:用 Codex 提取深度视频
流程的起点是把原始视频上传到 Codex,并明确指令:将上传的视频转换成深度视频,捕捉人物的动作。
这里所谓的「深度视频」,本质上是一段记录了画面中物体远近关系与运动姿态的数据。它剥离了原视频的色彩、材质等表层信息,只保留骨架式的空间与动作结构。这样做的好处是,后续AI生成时可以严格遵循原有动作,而不受原画面风格的束缚。
执行过程中,Codex 会提示需要安装一个深度估算(Depth Estimation)工具。安装完成后,系统就能调用电脑本地的 GPU 进行渲染。本地渲染意味着不必依赖云端算力,对拥有独立显卡的用户来说,既节省成本又保护素材隐私。生成完成的深度视频需要先保存备用,作为下一步的关键输入。
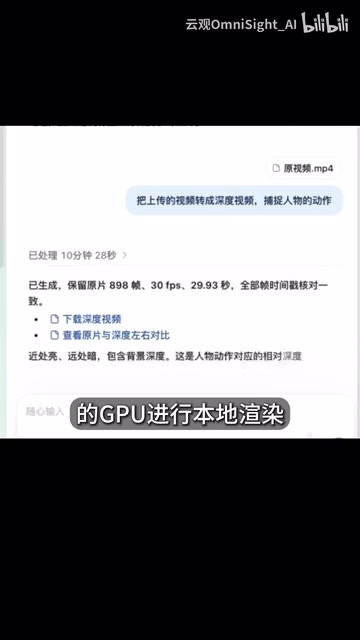
深度估算(Depth Estimation)是计算机视觉领域的经典任务,目标是从2D图像或视频帧中推断每个像素距离摄像机的相对远近,生成所谓的「深度图」。深度图通常以灰度表示:越近的物体越亮(白色),越远的物体越暗(黑色)。当这一技术应用于视频时,每一帧都会生成一张深度图,连续播放便构成深度视频。主流的深度估算方法分为两类:一是依赖双目摄像头或激光雷达等硬件传感器直接测量;二是纯软件的单目深度估算(Monocular Depth Estimation),通过神经网络从单张图像学习场景的深度线索,如透视关系、遮挡、纹理梯度等。Codex 此处调用的正是后者,代表性模型包括 MiDaS、Depth Anything 等开源方案,可在消费级 GPU 上本地运行。正因如此,深度视频本质上是一种对原始视频的「语义压缩」:颜色、纹理等视觉细节被抛弃,空间结构与运动轨迹被保留,为后续 AI 重新赋予外观提供了精确的几何约束。
第二步:生成主角与背景素材
有了深度视频这一「动作骨架」,接下来要准备的是「皮肤」——也就是视频中的主角人物和背景。
作者使用了工具中的图片生成功能(视频里称为「小圆圈」功能)来分别生成主角人物的三视图和背景图。三视图(正面、侧面等多角度)的意义在于让AI充分理解角色的立体外形,从而在动态镜头中保持角色一致性,避免出现换个角度就「变脸」的穿帮问题。
背景图则决定了整段视频的场景氛围。把动作、角色、场景三者拆分处理,正是这套工作流灵活性的来源:同一段深度视频可以搭配不同角色和背景,快速产出多个风格迥异的版本。
三视图(通常指正视图、侧视图、背视图,有时也包含四十五度角视图)起源于工业设计与动画行业,是角色设定中的标准交付物,用于确保团队成员在不同场景下绘制同一角色时保持外形一致。在AI视频生成语境下,三视图的作用是向模型提供角色的「全身立体参考」,使其在推断遮挡部位、处理镜头旋转时不必凭空猜测。如果只提供单张正面照,AI在侧面或背面镜头中往往会产生幻觉性错误,例如服装纹样错位、面部特征变形。将三视图与深度视频结合后,模型可以将深度图中的骨架信息与角色的三维外形对齐,从而在整段视频中保持更稳定的角色一致性——这也是该工作流相比「单图驱动」方案在长镜头上表现更优的核心原因。
第三步:切换 Agent 模式一键合成
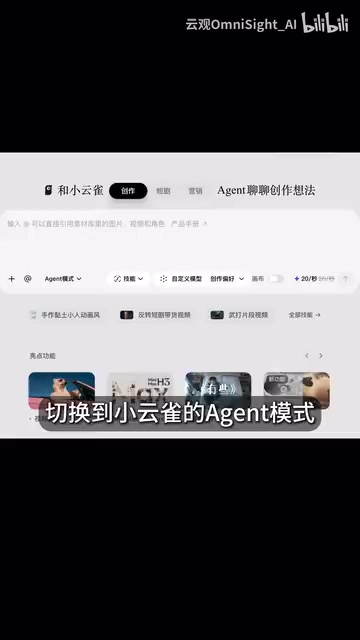
素材齐备后,切换到「小圆圈」的 Agent 模式,把深度视频、主角人物三视图和背景图同时上传,再输入设计好的提示词。
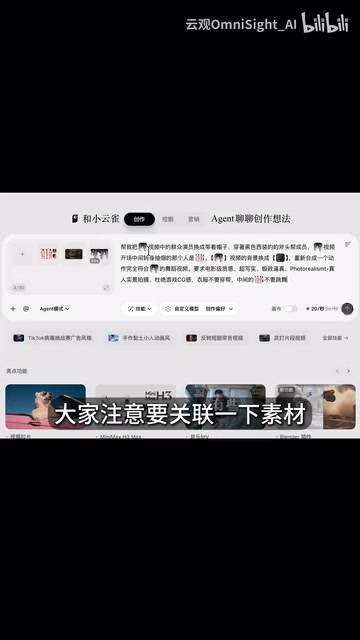
作者特别提醒了两个操作要点:一是可以参考他提供的提示词母版,降低试错成本;二是务必关联好各项素材,确保 Agent 能正确识别深度视频对应的动作、三视图对应的角色以及背景图对应的场景。这一步的素材关联是成败的关键,关联错误会直接导致生成结果混乱。
完成设置后,把生成任务交给 Agent 自动执行即可。Agent 会综合动作数据、角色外形和场景信息,输出一段动作还原度高、画面全新的AI视频。
这套工作流的价值与局限
从整体设计看,Seedance 2.5 深度视频玩法体现了当前AI视频创作的一个重要趋势:把复杂任务拆解为「动作提取—素材生成—智能合成」的模块化流程,再由 Agent 串联执行。相比过去一句提示词生成整段视频的黑箱模式,这种可控性更强的分步方案更适合需要精确还原动作的专业场景,比如舞蹈复刻、多人群像、连贯长镜头等。
本地 GPU 渲染是另一个亮点,它降低了对云端订阅的依赖。不过也要看到,这一步对硬件有一定门槛,没有高性能显卡的用户体验可能大打折扣。
需要提醒的是,本文流程基于单一UP主的实测演示整理,具体参数、工具版本和最终效果会因素材质量、提示词设计和硬件条件而有明显差异。想上手的创作者建议先用短片段试跑,确认流程跑通后再处理复杂的多人长镜头素材。
相关推荐
警惕"GPT代充"骗局:ChatGPT会员充值的安全隐患解析
网络上流传的"GPT-6 Astra稳定升级""ChatGPT会员充值教程"暗藏风险。本文解析第三方代充、信用卡、App内购等方式的安全隐患,提醒用户警惕账号被盗与资金风险,选择官方合规渠道。
GPT-6 Astra实测Blender:3D设计将迎变革还是虚火?
GPT-6 Astra发布后引爆Blender,UP主肥虫实测AI一句话生成3D资产的真实能力:远看惊艳近看崩塌,AI真正降维打击的是重复劳动。附3D设计师转型方向与Blender被引爆的深层原因分析。
警惕第三方ChatGPT代充陷阱:账号安全风险深度解析
第三方ChatGPT代充服务宣称无需境外信用卡即可开通Plus、Pro会员,但要求交出账号登录凭证存在严重安全风险。本文深度解析代充运作模式与隐患,并提供合规订阅替代方案。