实测TimesFM 3.0、Chronos-2、Toto 2.0:时序大模型跑不赢简单基线
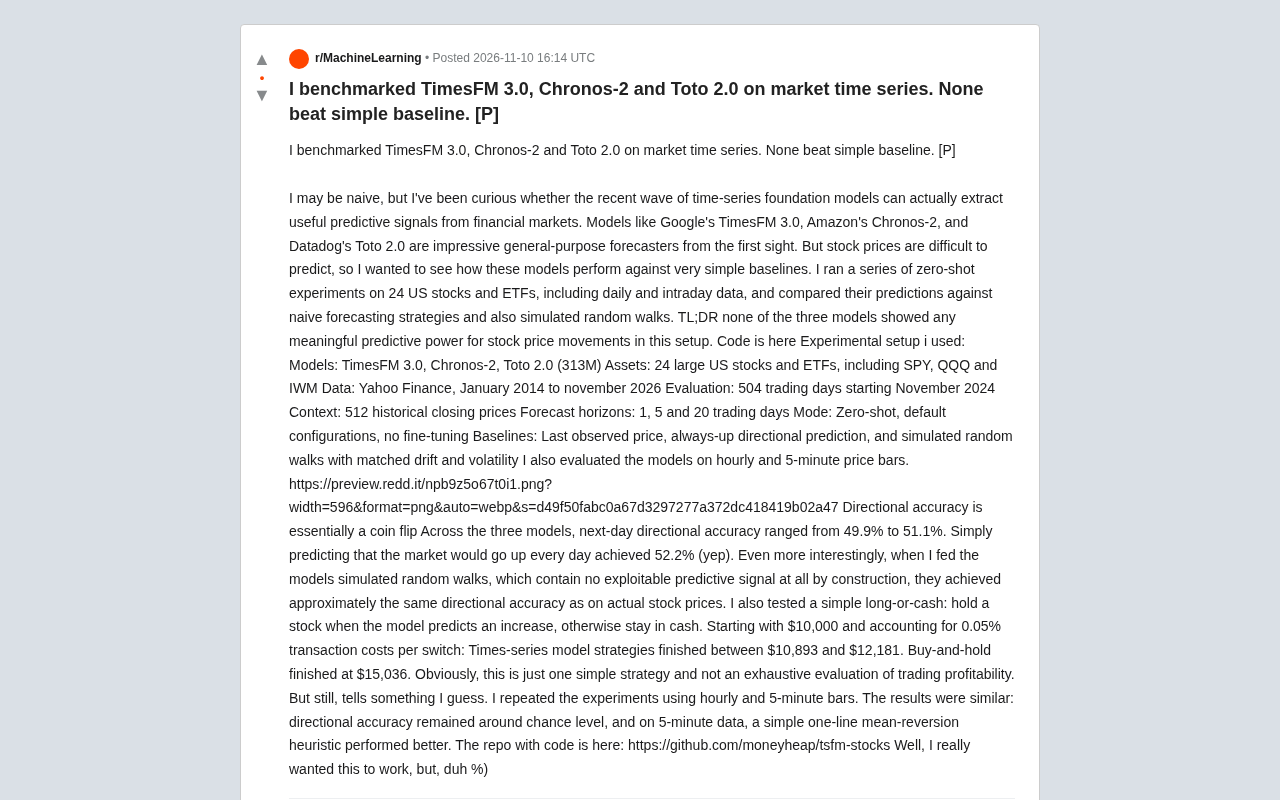
零样本实测显示,三大时序基础模型在股票预测上不及简单基线。
开发者对TimesFM 3.0、Chronos-2和Toto 2.0进行零样本股票预测实测,覆盖24只美股及ETF的日线、小时线和5分钟数据。结果显示,三个模型的次日方向准确率仅49.9%-51.1%,与随机猜测无异,而始终预测上涨的朴素策略达到52.2%。更关键的是,模型在模拟随机游走数据上的表现与真实股价几乎一致,说明其未提取到真实预测信号。简单多空策略最终资产10893-12181美元,跑输买入持有的15036美元。作者指出,金融数据信噪比极低、非平稳性强,时序基础模型在通用场景的优势难以迁移,简单基线在金融市场往往就是最强对手。
一位开发者对近期热门的时序基础模型进行了零样本实测,结论令人意外:在股票价格预测任务上,Google的TimesFM 3.0、Amazon的Chronos-2和Datadog的Toto 2.0都没有表现出优于简单基线的预测能力。
实验设计:零样本挑战市场数据
测试覆盖24只美国大型股票和ETF,包括SPY、QQQ和IWM,数据来自Yahoo Finance,时间跨度为2014年1月至2026年11月。评估窗口为2024年11月起的504个交易日,使用512个历史收盘价作为上下文,预测1天、5天和20天三个时间跨度。
所有模型均在零样本模式下运行,使用默认配置,未进行任何微调。对比基线包括:最后观测价格、始终预测上涨的方向策略,以及匹配漂移和波动率的模拟随机游走。实验还扩展到小时线和5分钟K线数据。
代码已开源在GitHub仓库moneyheap/tsfm-stocks中。
零样本(Zero-shot)学习指模型在未经任何特定任务数据微调的情况下,直接对全新输入进行预测。对于时序基础模型,这意味着模型完全依赖预训练阶段学到的通用时序模式,而非针对股票数据调整参数。零样本评估的优势在于能干净地衡量模型的泛化能力——如果模型在预训练中确实学到了可迁移的时序规律,那么零样本表现就应优于朴素基线;反之,若零样本表现与随机猜测无异,则说明预训练知识无法迁移到该领域。这也解释了为何实验特意强调“使用默认配置、未进行任何微调”:任何微调都可能引入数据泄漏或过拟合,从而模糊对模型固有能力的判断。
方向准确率:与抛硬币无异
三个模型的次日方向准确率介于49.9%到51.1%之间。而一个最朴素的策略——每天都预测市场上涨——却达到了52.2%的准确率。
更具揭示性的发现是:当研究者将模拟随机游走数据输入模型时,这些数据在构造上不包含任何可利用的预测信号,模型的表现却与在真实股价上的准确率大致相同。这意味着模型输出的方向判断与价格序列中是否存在真实信号几乎无关。
在小时线和5分钟线上重复实验后,结果类似:方向准确率仍在随机水平附近。而在5分钟数据上,一个简单的一行均值回归启发式策略反而表现更好。
随机游走(Random Walk) 是金融学中描述资产价格变动的经典模型,其核心假设是价格的下一次变动与历史无关,且方向不可预测。在随机游走假设下,最佳预测就是当前价格(即“最后观测价格”基线),而方向准确率应趋近于50%。实验中将模拟随机游走数据输入模型,正是为了构造一个“已知无信号”的对照组:如果模型在随机游走上的方向准确率与在真实股价上几乎一致,就说明模型输出的方向判断并非基于可预测的市场规律,而是对序列统计特征的拟合,甚至可能只是对序列自相关或波动率聚集的机械反应。这一对照设计是判断时序模型是否真正“学到信号”的关键实验手段。
模拟交易:模型策略跑输买入持有
研究者还测试了一个简单的多空切换策略:模型预测上涨时持有股票,否则持有现金。初始资金10000美元,每次切换按0.05%计算交易成本。
时序模型策略的最终资产在10893美元到12181美元之间,而简单的买入持有策略最终达到15036美元。差距明显。
作者也承认,这只是一个简单策略,并非对交易盈利能力的穷尽评估,但结果仍能说明一些问题。
为什么时序基础模型在金融数据上失灵?
这个实验揭示了一个核心矛盾:时序基础模型在通用预测任务上表现亮眼,但金融价格序列的信噪比极低。模型在随机游走上表现出的"预测能力"与在真实股价上几乎一致,说明它们可能只是在拟合序列的统计特征,而非提取真实的市场信号。
另一个值得关注的细节是,零样本模式下模型无法利用市场特有的结构性信息,如交易量、宏观事件或市场情绪。即便进行微调,金融数据的非平稳性也会让模型训练面临严峻的过拟合风险。
信噪比(Signal-to-Noise Ratio) 指数据中可预测信号与随机噪声的功率之比。金融价格序列的信噪比极低,意味着每日价格变动中绝大部分是难以预测的随机波动,真正可被模型捕捉的系统性信号微乎其微。时序基础模型在流量预测、需求规划等任务上表现优异,是因为这些场景的信噪比较高,周期性和趋势结构清晰且稳定。而在金融数据中,微弱的信号容易被噪声淹没,模型即使学到了一些统计规律,也难以转化为稳定的方向预测优势。此外,非平稳性(Non-stationarity) 意味着金融数据的统计分布随时间变化,模型在训练集上学到的模式可能在未来失效,这进一步加剧了过拟合风险,使得微调也难以带来可靠提升。
对AI预测能力的理性审视
这项测试并非否定时序基础模型的价值。TimesFM、Chronos和Toto在设计上面向的是通用时序预测场景,如流量预测、需求规划和传感器数据分析,这些场景通常具有更清晰的周期性和趋势结构。
但在金融市场这个公认的高噪声、低信噪比环境中,简单基线往往就是最强的对手。对于想要将时序大模型直接应用于量化交易的开发者来说,这项实验提供了一个必要的现实检验:在默认配置和零样本条件下,模型尚未展现出超越朴素方法的预测优势。
相关推荐
七年蜕变:初代折叠屏与现在差距有多大
从初代折叠屏到最新产品,七年时间带来了哪些改变?折痕变浅、亮度提升、机身更薄、软件迁移更顺畅,折叠屏是否已经跨越从发烧友到普通用户的鸿沟?本文基于视频对比分析展开讨论。
人类何时开始吃盐?一段跨越万年的盐史
人类何时开始吃盐?从11000年前农业兴起时的加盐实践,到古代海水蒸发、岩盐开采,再到盐贸易、盐税与甘地食盐长征,本文梳理盐在人类文明中的关键角色。
微软Paza研究:非洲语言语音识别如何突破架构与数据瓶颈
微软Paza研究系统评估53个语音模型在39种非洲语言上的表现,揭示架构选择比预训练覆盖更关键、200-300小时为实用数据门槛,以及语言类型学对识别性能的深层影响。