十分钟搞懂AI大模型:Token、向量与Transformer原理
从Token、向量化到Transformer,拆解大模型训练与推理全链路。
文章基于B站UP主孤炮科技的视频,系统梳理了大模型从训练到推理的完整技术链路。首先回顾ChatGPT引爆生成式AI产业转向的背景,区分决策式AI与生成式AI。接着解释大模型逐词输出的原理——根据上下文预测下一个Token。然后详述预训练、微调与推理三阶段:预训练用无监督学习在海量Token上构建基座模型,微调用监督学习让模型学会对话。文章还剖析了概率表导致幻觉的机制,以及向量化如何让模型捕捉语义相似性,最后深入Transformer自注意力机制如何理解上下文指代关系,并指出GPT-3包含96层Transformer。
AI大模型已经渗透到日常对话、内容创作和代码生成等场景,但大多数人对它的工作原理仍停留在“黑箱”认知。B站UP主孤炮科技联合创始人Mike用一期十分钟的视频,从Token、向量化到Transformer注意力机制,拆解了大模型从训练到推理的完整链路。本文基于该视频内容,结合技术细节做进一步梳理。
从ChatGPT爆发看生成式AI的产业转向
2022年11月30日,OpenAI发布ChatGPT,不到两个月日活用户突破一亿,打破了TikTok此前保持的九个月增长纪录,成为历史上增长最快的应用。这一产品直接加速了AI行业从决策式AI向生成式AI的演化,国内外企业迅速涌入大模型赛道。据视频中引用的数据,短短两年时间内国内63%的企业都在做大模型应用,盘古、通义、文心、混元、讯飞星火等通用基座模型构成了产业底座,应用层则覆盖教育、汽车、金融等行业。
对话类产品在ChatGPT之后迅速铺开:国外的Anthropic Claude、微软Bing AI、谷歌Bard,国内的文心一言、通义千问广告、腾讯元宝等,形成了密集的产品矩阵。理解这一产业变局的前提,是区分两种AI范式——决策式AI基于历史数据做判断和预测,例如用房价数据训练模型预判涨跌,常见于智能推荐和辅助决策;生成式AI则是在学习归纳已有数据后进行模仿和创造,生成全新内容。后者更接近人类理想中的智能形态,也因此被视为AI能力的新里程碑。
大模型为什么“一个字一个字往外蹦”
初次使用ChatGPT的人常会注意到,回答是一个词一个词地流式输出,像是有人在实时打字。这种表现并非产品设计上的“高级感”,而是由模型原理决定的:大模型本质上是在根据上下文推理下一个文字是什么。
以豆包模型为例,生成内容时逐词或逐词组返回信息,再由前端拼接展示。更具体地说,给LLM一个句子“今天的天气很”,模型会基于上下文推断下一个字是“好”;随后这个字被重新丢回上下文语境,继续生成“晴朗”“气温”“适中”等后续内容。通过这种不断迭代的预测过程,短句逐步扩展为长文本。这就是从表层现象理解大模型文本生成的基本原理。
预训练、微调与推理:大模型的三阶段流程
理解大模型需要先建立宏观框架:从训练到推理,整个流程包括预训练、微调和推理三个阶段。
预训练:无监督学习构建基座模型
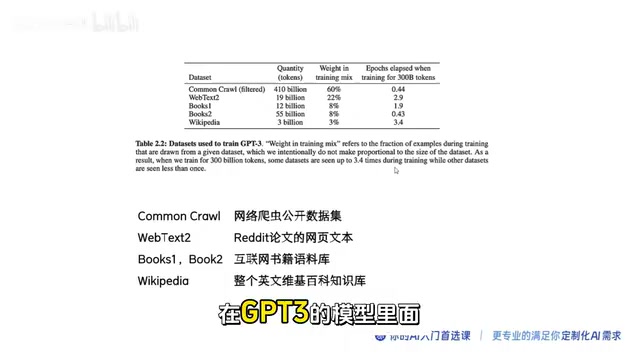
预训练采用无监督学习,基于海量知识库进行自主学习。以GPT-3为例,其语料库覆盖书籍、新闻文章、科学论文、维基百科、社交媒体帖子等,官方公布的数据中标注了各语料库的Token数量,其中Common Crawl网络爬虫数据、论文文本、互联网书籍语料库和维基百科知识库均有明确统计,整体训练使用了3000亿Token。
Token是模型处理和理解文本的基本单元。模型将用户输入的文本分割成Token,再基于Token进行计算和推理。你可能没注意到,Token的切分并不严格对应英文单词边界——例如“Tokenization”会被拆为“Token”和“ization”两个Token,“Newer”会被拆成“New”和“er”,单词前的空格通常与单词一起构成一个Token。不同模型使用的分词器不同,同一句话在不同模型中的Token化结果可能存在差异,因为分词算法可能按字符、符号、单词或半词切分,也可能将经常同时出现的字符组合视为一个单元。
文本在训练前会先转为Token ID,因为计算机无法直接存储文字,任何字符最终都要用数字表示。模型推理计算时基于Token的唯一ID进行一系列转化,通过Token文本与ID的映射关系完成处理。
无监督学习与监督学习的差异可以用一个直观例子说明:监督学习中训练数据既有特征又有标签,比如知道猫叫Tom、老鼠叫Jerry,模型学习特征与标签之间的对应关系后,面对只有特征的新数据也能判断标签;无监督学习则是在未标注数据中寻找隐藏结构,模型不知道哪只是Tom、哪只是Jerry,但能通过机器学习识别出猫的特征属于同一类型、老鼠的特征属于另一类型,完成聚类。预训练的结果是得到一个基座模型,它能根据上下文预测下一个Token,例如输入“湖南的省会是”会生成“长沙”,但基座模型并不擅长对话。
Tokenization(分词)算法是理解Token切分的关键。常见分词方法包括BPE(Byte Pair Encoding)、WordPiece和SentencePiece等。BPE从字符级开始,反复合并出现频率最高的相邻字符对,最终形成子词词表,能平衡词表大小与未登录词问题;WordPiece类似但基于似然概率选择合并;SentencePiece则直接将原始文本视为字符序列处理,不依赖预分词。不同模型选择不同分词器,导致同一文本的Token数量和ID映射不同,这会影响模型的上下文窗口利用率和推理成本。
微调:监督学习让模型学会对话
要让基座模型达到ChatGPT式的对话效果,需要进一步微调。微调是在已有基座模型上做进一步训练,改变模型内部参数,使其更适合特定任务。这一阶段模型不再从海量文本中学习,而是从人类提供的高质量对话数据中学习,相当于既给了问题又给了参考回答,属于监督微调。微调后的模型在对话类问题上表现明显更好。
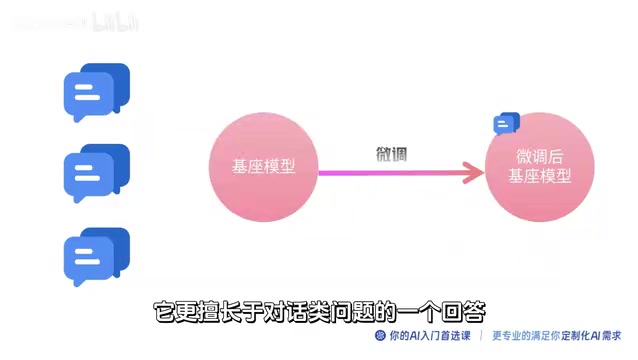
为进一步提升能力,还可以让微调后的模型进行强化学习——在环境中采取行动并获得结果反馈,从反馈中持续学习,从而在特定情况下采取最佳行动。经过预训练和微调,模型即可与用户进行正常对话,输出内容的质量已相当可观。例如模型能生成“长沙是一个充满活力的城市,历史文化与现代都市风情相结合”这类回答,本质上是大模型基于大量文本训练后得到的推理结果。
RLHF(基于人类反馈的强化学习) 是微调之后进一步提升模型对齐能力的关键技术,ChatGPT的成功很大程度上归功于它。RLHF通常分三步:首先收集人类对模型输出的偏好排序数据,训练一个奖励模型来模拟人类评价;然后以微调后的模型为策略,用强化学习算法(如PPO)优化策略,使其生成的回答获得更高奖励;同时加入KL散度约束,防止模型偏离原始语言模型太远。RLHF让模型不仅“会说话”,还能更符合人类意图和价值观。
概率表与幻觉:大模型为什么会“一本正经胡说八道”
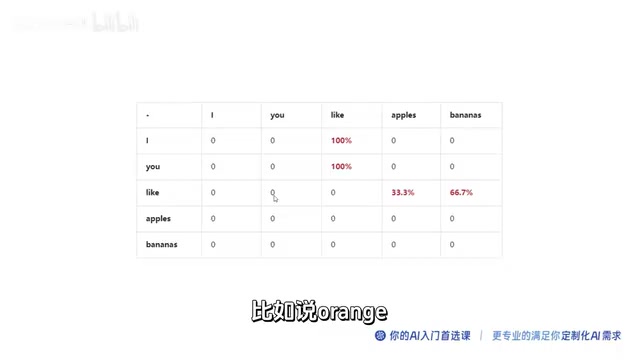
大模型生成文本的本质是概率问题。以“I like bananas还是apples”为例,下一个词的选择取决于预训练过程中学到的概率模型,假设bananas概率为80%,生成的文本就是“I like bananas”。
这个概率如何得到?可以用一个简化例子说明:取三组训练数据,转化为Token后,训练任务是预测跟随其他Token的Token。简单方法是获取训练集中所有连续的Token对,构建概率表。例如在“I like apples”“I like bananas”等数据中,“like”被“apples”跟随一次、被“bananas”跟随两次,则apples跟随like的概率约为33.3%,bananas约为66.7%。实际大模型训练使用海量文本,不会出现这种样本稀疏的漏洞。
早期大模型“一本正经胡说八道”的幻觉问题正源于此:模型本身无法理解文本在人类世界中的含义,只能根据上下文概率生成内容。生成的文本在语法格式上满足需求,但与当前历史背景和问题的相关性如何,模型无法判断。随着训练参数增多,模型能力增强,这类低级问题会逐渐减少。
向量化:让模型理解“此苹果非彼苹果”
人类语言语义丰富,模型如何知道Apples和Bananas都是水果,并在“吃”的语境下联想和替换Orange?这涉及向量嵌入。
Token ID只是单个整数,信息表达能力有限。以man和woman为例,两者都描述人类但性别相反,若只用单个数字表示,距离大小无法同时承载“同属人类”和“性别相反”这两层信息。向量化将Token ID转化为一串数字,带来两个好处:一是高维向量能表示更丰富的语法和语义信息,相似词在向量空间中的坐标距离更近,无关词距离更远,模型可通过数学计算捕捉词与词之间的复杂关系;二是向量既有方向又有大小,可在空间中表示对象间关系。GPT-3的向量长度达到12288,信息容量远超单个数字。
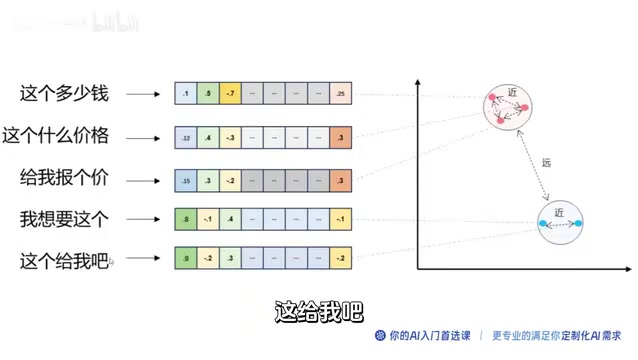
向量化表示的另一个特点是相似度可度量:通过余弦相似度衡量向量夹角,或通过欧几里得距离衡量空间直线距离。在三维示意中,水果类坐标彼此接近,动物类坐标彼此接近。实际应用中,“这个多少钱”“什么价格”“给我报个价”属于问价格的问题,向量坐标相似度高;“我想要这个”和“这个给我吧”相似度也高;而这两类问题之间距离较远。这就解决了文本相似度判断问题。
余弦相似度与欧几里得距离是衡量向量相似度的两种常用度量。余弦相似度计算两个向量夹角的余弦值,取值范围在-1到1之间,值越接近1表示方向越一致,它只关注方向而不受向量长度影响,适合比较文本语义;欧几里得距离计算向量空间中的直线距离,值越小表示越相似,但受向量模长影响。实际应用中常对向量做归一化后再用余弦相似度,使两者等价。选择哪种度量取决于具体任务和向量是否归一化。
Transformer与自注意力:理解上下文的关键
向量化仍未解决所有问题。例如“我在京东上买了最新款苹果”和“我在京东上买了阿克苏的苹果”,两个“苹果”指代不同物体,但大模型能像人一样理解文本含义并生成符合语义的回答,关键在于Transformer。
Transformer由论文《Attention is All You Need》于2017年提出,迅速成为自然语言处理领域的主流架构,广泛应用于机器翻译、文本生成等任务。其核心创新是自注意力机制,使模型在处理序列数据时能有效捕捉序列内各元素之间的关系,不受位置远近限制。
以“The animal didn't cross the street because it was too tired”为例,句中的“it”可能指animal也可能指street,Transformer通过注意力机制计算每个词与其他词的相关性权重,识别出“it”指代的是animal,并将animal的隐藏状态写入it所在的向量空间。GPT-3的向量长度有12288,用一万多维表示一个单词的上下文信息绰绰有余。注意力权重越高,说明两个词之间的相关性越强,模型据此专注输入中最重要的部分。
Transformer并非单层结构,而是可能包含数十层甚至更多,每层有自己的注意力机制,关注点不同:有的关注动词,有的关注修饰词,有的关注情感。层数越多,对文本内容的理解越深刻。这些层并非串行计算,而是并行处理。GPT-3包含96层Transformer,前几层关注句子语法和歧义消解,后续层致力于对整个段落做高层次理解——例如阅读短篇小说时跟踪性别、年龄、关系、位置、个性和目标等信息。96层LLM的目标是输出包含所有必要信息的最终词隐藏状态,从而精准预测下一个词。
自注意力机制的计算过程可以拆解为查询(Query)、键(Key)和值(Value)三个向量。对序列中每个Token,模型用其向量分别乘以三个可学习矩阵得到Q、K、V;然后用当前Token的Q与所有Token的K做点积并除以缩放因子(通常为维度的平方根),经Softmax归一化得到注意力权重;最后以权重对V加权求和,得到该Token的新表示。这一过程使每个Token都能聚合全局上下文信息,且可并行计算,突破了RNN的顺序处理瓶颈。
小结
从Token化、向量嵌入到Transformer多层注意力,大模型的文本生成链条可以概括为:预训练在海量文本上学习下一个Token的概率,微调让基座模型学会对话,强化学习进一步提升能力,推理时逐词生成并拼接输出。理解这条链路,有助于解释大模型为何产生幻觉、为何输出与预期有偏差,也为进一步调教和优化模型提供了认知基础。
相关推荐

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。

Salesforce 3.75亿美元收购Rune,AI物流技术补强国防业务
Salesforce 据报道以 3.75 亿美元收购国防科技初创公司 Rune,这家 AI 物流公司的技术将用于补强 Salesforce 的 Missionforce 国防平台,也延续了 Salesforce 近期的并购节奏。

Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。