视频与图像模型的爆发时刻:更强模型与Agent工作流如何改变创作
视频与图像AI正因模型、工具、Agent工作流与场景认知四因素同步成熟而迎来主流普及临界点。
一条科技从业者推文点出了视觉生成AI爆发的四个核心驱动力:模型能力大幅跃升、工具门槛持续降低、Agent化工作流实现多步骤自动协作,以及用户对适用场景的认知趋于清晰。文章认为,这四块拼图罕见地同时成熟,标志着视觉AI从早期尝鲜走向主流采用的临界点。对创作者而言,这是积累经验的入场时机;对企业而言,则是重审内容生产流程的节点。与此同时,文章也保持了理性克制,指出版权争议、深度伪造风险、长视频连贯性瓶颈和生成成本等挑战依然存在,能力边界的清醒认知与把握机遇同等重要。
一条推文背后的信号
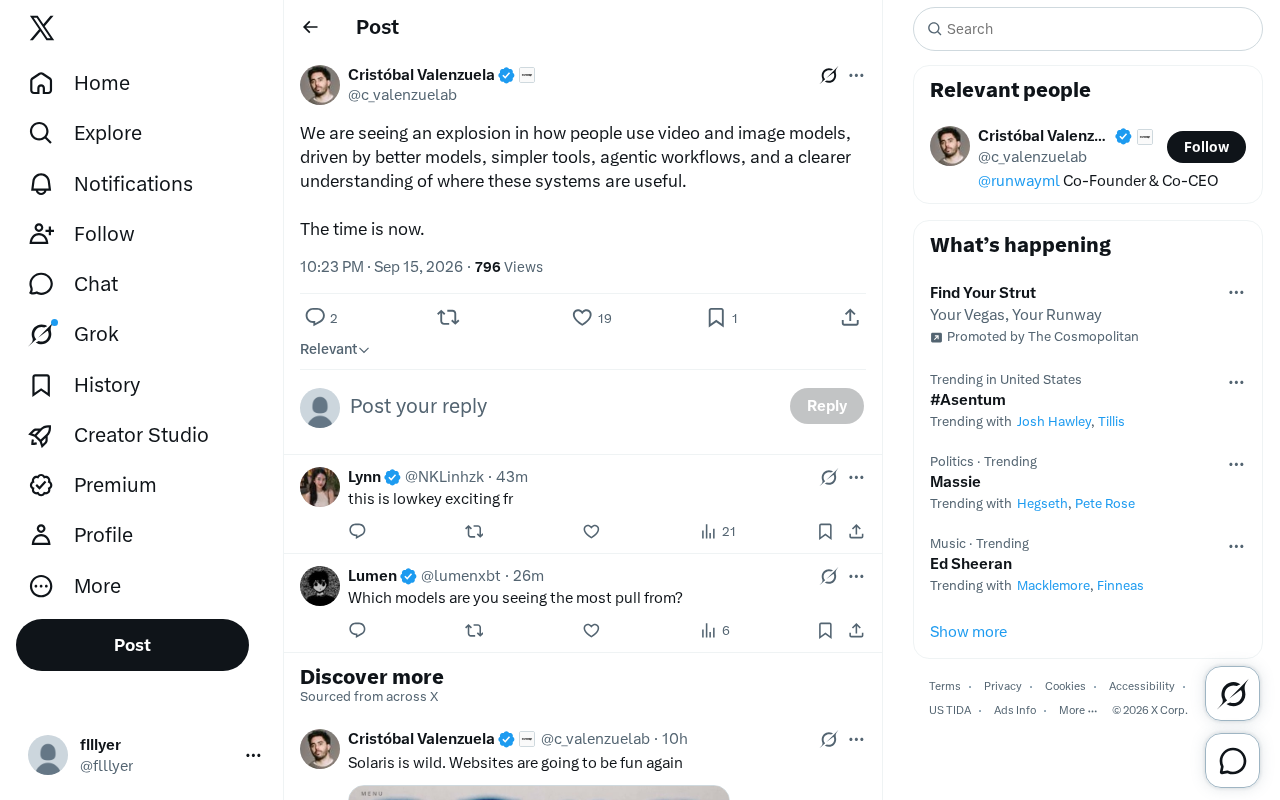
一条来自科技从业者的推文近期引发关注:"我们正见证人们使用视频和图像模型的方式出现爆发式增长,这背后是更强的模型、更简单的工具、Agent化的工作流,以及对这些系统适用场景更清晰的理解共同推动的。时机就在当下。"
这段话虽然简短,却精准点出了当前生成式AI在视觉领域的几个核心驱动力。它不是空泛的乐观,而是把"为什么现在"拆解成了具体的技术与生态变量。本文尝试基于这条观点,展开分析视频与图像模型正在经历的这场变革。
四个驱动因素,缺一不可
原文提到的爆发并非单一因素造就,而是四条力量同时成熟的结果。
更强的模型
过去几年,图像生成从模糊、扭曲的实验品,进化到能产出接近专业摄影质量的成品。视频模型的进步更为迅速——从只能生成几秒钟画面抖动的片段,到能保持时间连贯性、物理合理性和角色一致性的输出。模型能力的跃升,直接把"能不能用"的问题变成了"怎么用得更好"。
更简单的工具
模型再强,如果只有工程师能调用,也难以形成规模化使用。降低门槛的工具层——从网页界面到一键式生成应用——让不具备技术背景的创作者也能上手。工具的简化,把AI视觉能力从实验室推向了普通用户的桌面。
Agent化工作流
原文特别强调了"agentic workflows"(Agent化工作流)。这意味着生成不再是一次性的单点操作,而是由AI代理串联多个步骤:理解需求、生成草稿、自我评估、迭代优化。这种自动化的多步骤协作,让复杂的创作任务可以被拆解和自动执行,大幅提升了产出效率与质量。
Agent化工作流的核心技术基础是将大型语言模型或多模态模型作为"规划器",配合工具调用(Tool Use)和记忆模块,使AI能够将一个高层目标自动拆解为若干子任务并依次执行。以视频生成为例,一个典型的Agentic流程可能包括:解析用户的文字描述、自动生成分镜脚本、调用图像模型逐帧生成关键画面、通过视频插帧模型补全中间帧、最后调用音频模型匹配背景音乐——整个链条无需人工介入每个环节。这与传统"提示词输入→单次输出"的范式有本质区别。目前推动这一方向的代表性框架包括LangGraph、AutoGen以及各大模型厂商自研的Agent编排工具。Agent化工作流的成熟,意味着创作者可以用自然语言描述意图,让系统自主完成原本需要多个专业工种协作的任务。
更清晰的场景认知
第四个因素常被忽视,却至关重要:人们越来越清楚这些系统"适合做什么"。早期用户往往对AI抱有不切实际的期待,或找不到真正的落地场景。随着实践积累,营销素材、原型设计、内容创作、广告制作等高价值场景逐渐明确,需求与能力开始精准匹配。
"时机就在当下"意味着什么
原文用"The time is now"作结,传递的是一种从业者的判断:技术、工具、方法论和市场认知这四块拼图,此刻恰好同时到位。
这种"同时成熟"的窗口期在技术史上并不常见。它往往标志着一个领域从早期尝鲜走向主流采用的临界点。对创作者而言,这是入场学习和积累经验的好时机;对企业而言,这是重新审视内容生产流程、评估AI能否降本增效的节点。
值得保持的理性视角
需要说明的是,原文是一条观点性的推文,反映的是特定视角下的乐观判断,缺乏具体数据或案例支撑。爆发式增长的说法虽有直观依据,但不同行业、不同应用的成熟度差异仍然巨大。
视频与图像模型也面临现实挑战:版权与训练数据争议、内容真实性与深度伪造风险、长视频的连贯性瓶颈、以及生成成本等问题都尚未完全解决。因此,在把握机遇的同时,理解这些系统的能力边界同样重要——这恰好也呼应了原文所说的"对适用场景更清晰的理解"。
深度伪造(Deepfake)是视觉生成AI面临的最具代表性的社会性风险之一。它指利用生成模型将真实人物的面部或声音替换到另一段视频中,制造出以假乱真的内容。随着视频生成质量的提升,这类内容的制作门槛大幅下降,已在政治舆论操纵、金融诈骗和非自愿色情内容等场景中造成实际危害。目前业界和学界的应对方向主要有两类:一是内容溯源技术,如C2PA(Coalition for Content Provenance and Authenticity)标准,通过在媒体文件中嵌入加密的来源元数据来标记AI生成内容;二是AI生成内容检测模型,通过识别特征性伪影来辅助判断。然而这两类手段目前均有明显局限,技术层面的"矛"与"盾"博弈仍在持续,这也是各国监管机构加速制定AI内容治理规则的重要背景。
结语
这条推文之所以值得展开,是因为它把一个宏观趋势浓缩成了可分析的因素组合。模型能力、工具易用性、Agent化流程和场景认知,四者共振,正在把视觉生成AI推向一个新的普及阶段。对于关注这一领域的人来说,与其争论"是不是泡沫",不如认真思考在自己的工作与创作中,哪些环节已经可以被这些工具真实赋能。
相关推荐
Vercel智能体进化史:从翻车到翻倍的文件系统实战
Vercel首席软件官Andrew复盘数据科学智能体D0从多智能体架构翻车到文件系统Agent评分翻倍的全过程,揭示Claude Code式文件系统、技能沉淀的关键作用,并解析新开源Agent框架EVE的设计理念。
企业级AI Agent实战:低代码与硬核框架双线打法解析
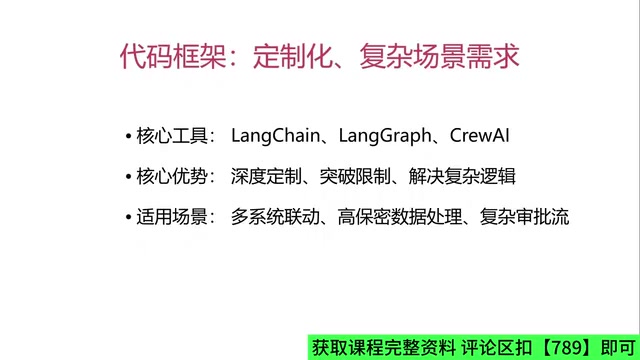
解析企业级 AI Agent 实战课程框架:低代码平台(Coze/Dify/n8n)与代码框架(LangChain/LangGraph/CrewAI)双线并行,涵盖 MCP 协议、九大智能岗位与四大实战项目,助你构建能落地的企业数字员工。
OpenSpec实战:用SDD规范驱动开发驯服AI写代码
AI写代码前30分钟开挂后3小时救火?本文解析OpenSpec如何通过SDD规范驱动开发,让AI写的代码可追踪、可验证、可交付,并对比OpenSpec与SpecHit的选型场景。