受够了给AI编程代理当保姆?这个开源工具让它们自检

开发者开源Agent Config,让编程代理在声称完成前先自检,以降低人工验收成本。
文章介绍了一位开发者因不堪忍受为AI编程代理反复验收而创建的开源项目Agent Config。该项目的核心痛点是:代理常声称"完成"却未跑测试、未修复bug或漏检文件,导致验收成本转移到人身上,且每个新项目都要重复交代规范。Agent Config是一套MIT开源、无付费层的配置集合,为Claude Code等多款工具提供技能、规则、工作流与质量检查,设计上强调先分析代码库再动手、全流程串联、多视角审查、项目记忆与按需加载。作者最看重可独立使用的production validator,专门验证"完成"声明。同时他警惕复杂度与token消耗,坦言仍在摸索哪些复杂度真正有用。
AI写代码越来越强,但"写完就交差"的毛病一点没改。跑没跑测试?修没修对?检查没检查那个文件?一位开发者受够了这种反复验收的循环,干脆做了一套开源配置,让代理在说"完成了"之前先自己过一遍关。
为什么"完成"两个字越来越不可信
原帖作者的话很直白:模型写代码的能力已经好得离谱,但他仍然要花大量时间确认代理是否真的照做了。常见的三种翻车场景被他一一点名——回复"Done!"但测试根本没跑;回复"Fixed!"但同一个bug原地复活;回复"Everything looks good!"唯独漏掉了那个没被检查的文件。
这件事的痛点不在于模型能力,而在于验收成本转移到了人身上。每换一个新项目,还要把同样的代码规范、测试要求、工作流程重新讲一遍。作者把这套重复劳动称为"babysitting"(看孩子式盯梢),这个比喻相当准确:代理干活,人负责兜底,而兜底往往比干活更累。
Agent Config 是什么:一套给代理"立规矩"的开源配置
作者把这些需求收敛成了一个项目——Agent Config,定位是"你的AI工程系统",MIT协议开源、无付费层。它不是一个新的编程模型,而是一层套在Claude Code和其他多款编程工具外面的技能、规则、工作流与质量检查集合。
从作者列出的能力看,设计思路可以拆成几块。先看再动手:代理在改代码之前先分析代码库,避免盲改。全流程工作流:从规划、实现、测试到审查串成一条线,而不是让代理一步跳到写代码。多视角审查:分别从bug、安全、测试和代码质量四个角度切入,而不是笼统地"审一下"。记忆与项目上下文:把之前的决策存下来,不用每次都重新发现一遍。按需加载:技能和规则根据当前任务加载,而不是把所有东西一股脑塞进上下文。此外还支持多家编程工具,避免整套配置被单一供应商锁死。
其中作者本人最看重的是production validator(生产环境验证器)。它可以单独使用,专门检验代理那句"完成"到底站不站得住。这其实点出了整套方案的核心价值:把"验收"这个动作从人手里部分接管过去,变成代理交付流程里的固定环节。
Claude Code 是 Anthropic 推出的命令行编程代理工具,它能在终端中直接读取代码库、执行命令、修改文件,并以自然语言与开发者交互。与传统的代码补全插件不同,Claude Code 属于"代理式"工具:它自主规划步骤、调用工具链、完成多文件改动。这类工具的能力上限很高,但也正因如此,它的"完成声明"需要被外部验证——代理可以声称任务完成,却未必真的运行了测试或检查了所有相关文件。Agent Config 这类配置层正是作用于 Claude Code 的规则与技能注入机制之上,通过预设的工作流和质量关卡来约束代理行为。理解这一点,就能明白为什么作者强调它是"套在工具外面的一层",而非替代模型本身。
按需加载(lazy loading) 是代理工程中的一个关键设计模式。编程代理的上下文窗口有限,如果把所有代码规范、测试要求、项目约定一次性塞进提示词,会挤占真正有用的代码和任务信息,导致模型注意力分散、成本上升。按需加载的思路是:将规则和技能拆分为独立模块,根据当前任务类型(如"写测试""安全审查""重构")动态注入相关部分。这既降低了单次调用的 token 开销,也减少了规则之间的相互干扰。作者在文中提到"技能和规则根据当前任务加载,而不是把所有东西一股脑塞进上下文",正是这一模式的体现。它也是对抗上下文膨胀的直接手段,与作者对复杂度的警惕一脉相承。
多代理不等于好结果:作者自己的克制
值得留意的是作者对复杂度的警惕。他明确写道,正在努力让这套东西不要变成"烧token的怪兽"——更多代理、更多规则、更多上下文,并不会自动带来更好的结果。项目规模已经超出了他最初的设想,他也坦言还在摸索哪里加复杂度是真的有用、哪里纯粹是添乱。
这种自我怀疑在开源项目介绍里不常见,但对使用者是个有用的提醒:上下文膨胀本身是一种成本。按需加载技能、按任务类型注入规则,本质上就是在对抗把什么规则都往里堆的冲动。如果读者打算自建类似方案,这条经验可能比功能清单更值得借鉴。
上下文膨胀(context bloat) 指的是代理的提示词或对话历史中堆积了过多无关信息,导致模型性能下降、推理成本上升的现象。在编程代理场景中,常见诱因包括:把整个代码库摘要塞进上下文、叠加多层规则、保留冗长的历史对话、以及引入多个子代理各自携带独立上下文。上下文膨胀不仅烧钱,还会让模型在关键决策上"分心"——重要规则被淹没在噪声中。业界的一般应对策略包括:按需加载、摘要压缩历史、将长期记忆外置为可检索的存储、以及限制子代理的数量和职责范围。作者坦言项目规模已超出最初设想,并努力避免变成"烧 token 的怪兽",说明他意识到复杂度并非线性收益,每增加一层规则都需要证明其边际价值。
信任问题:你验收代理,还是代理验收自己
原帖结尾抛回给社区两个问题:你会无条件相信代理说"任务完成"吗,还是已经自己搭了一套检查?如果你已经在用类似配置,真正起作用的又是什么?
这两个问题没有标准答案,但它标出了AI编程工具当前的一道分水岭。当模型写代码的能力不再是瓶颈,工程上的重心就会转向如何验证代理的产出。Agent Config给出的答案是把检查流程内建到代理的工作流里,让"自检"成为默认动作而非事后补救。这个方向是否能推广,取决于验证器本身够不够狠——一个只会说"看起来不错"的验证器,和没有验证器差别不大。
对正在重度使用Claude Code或类似工具的开发者来说,这个项目提供了一个可参考的起点:与其每次口头叮嘱,不如把规范写成代理必须走的关卡。至于关卡设多严、规则配多少,作者自己都还在试,这大概也是现阶段AI编程工作流的常态。
相关推荐
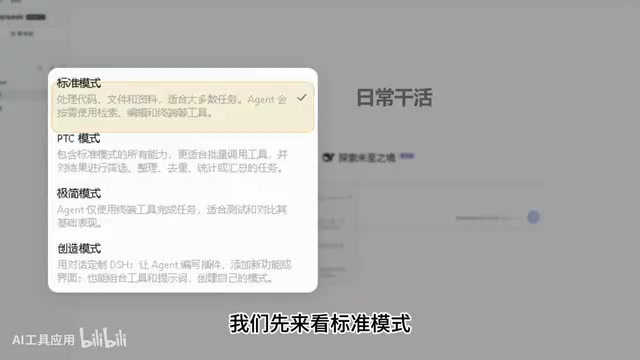
DeepSeek Harness保姆级教程:桌面端安装与插件开发实战
DeepSeek Harness 桌面端保姆级教程:从官网安装、工作区配置、三档权限设置,到标准/PTC/极简/创造四种模式拆解,并演示通过 DSH Market 插件市场安装插件、用创造模式接入豆包 API 做出生图插件的完整流程。
零成本AI超级员工系统实测:Agent自动化办公全链路拆解
拆解B站热传的零成本AI超级员工系统:Agent智能体、数字人口播、地图获客、AI客服法务等模块实测分析,揭示免费背后的算力门槛、数据合规风险与真实适用场景。
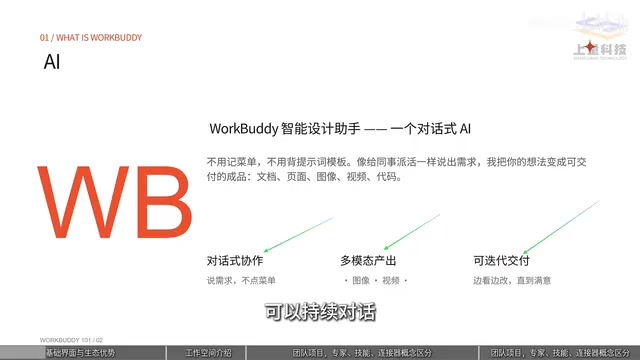
WorkBuddy智能体自动化实战:从零搭建AI工作流
WorkBuddy智能体教程精讲:解析腾讯WorkBuddy的界面布局、专家/技能/MCP连接器三大核心概念,以及助理、项目、定时任务和资料库的协作用法,附AI漫剧工作流实战思路。