手机本地运行无审查AI:LFM3模型实测与指南

Liquid AI 的 LFM3 1.7B 开源无审查多模态模型可在手机本地运行,无需高端 GPU。
文章介绍了一款仅 1.7B 参数的开源多模态模型 LFM3,由 Liquid AI 推出,可在手机或低端电脑上本地运行,无需昂贵显卡或云服务器。作者认为无审查和本地运行能带来零限制、零数据外流的体验。iPhone 用户可通过 On Device LLM 应用、Android 用户通过 Layla 应用,从 Hugging Face 下载 Atomic Chat 的 GGUF 版本。实测在 iPhone 16 Pro Max 上生成速度约 26 tokens/秒,iPhone 11 及以上机型均可运行。文章同时指出,1.7B 小模型能力有限,适合作为私有轻量助手,难以全面替代大型云端模型。
无审查AI模型的人气正在快速攀升,但一直有个门槛:本地运行往往需要强力GPU。现在这个局面正在改变。据YouTube创作者介绍,Liquid AI推出的LFM3系列中有一个仅1.7B参数的小模型,可以直接在手机或低端电脑上运行,无需昂贵显卡、无需云服务器,甚至不需要联网。
为什么无审查与本地运行值得关注
所谓“无审查AI”,指的是模型不会对用户的请求做出拒绝式回应。视频作者认为,ChatGPT、Claude、Gemini、Grok等主流模型在信息输出上存在种种限制,其中不少限制在他看来过于宽泛,影响正常使用。
本地运行带来的另一个好处是隐私。作者强调,使用云端模型意味着数据被发送到大型公司的服务器,此前已有诉讼证明这些数据会被存储。而在本地运行时,数据不会离开设备,离线也能使用,没有数据外泄的顾虑。
这两点结合,构成了无审查本地AI的核心吸引力:零限制、零数据外流、随时可用。
LFM3 1.7B:小体积的多模态模型
作者重点介绍的模型是LFM3 1.7B,属于Liquid AI发布的LFM3系列。该系列为多模态开源模型,可以处理图像、视频和音频输入,也支持语音交互。
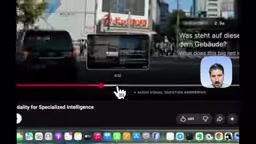
从视频演示看,模型能识别街景中的建筑并回答相关问题,也具备作为智能体执行任务的能力。开源意味着用户可以免费下载和使用。作者特别提到,该模型对硬件要求很低:带统一内存的低端电脑或6GB显存的GPU就能跑得很好,而手机同样胜任。
GGUF 格式:GGUF(GPT-Generated Unified Format)是 llama.cpp 项目推出的一种模型文件格式,专为在消费级硬件上高效运行大语言模型而设计。它支持将模型权重以不同精度(如 Q4_K_M、Q5_K_M 等)量化存储,从而大幅压缩模型体积、降低内存占用,同时尽量保持输出质量。GGUF 文件通常包含模型权重、分词器配置和元数据,可被多种推理框架(如 llama.cpp、Ollama、LM Studio)直接加载。文中提到的“Atomic Chat LFM3 1.7B uncensored GGUF”即指由 Atomic Chat 社区微调并转换为 GGUF 格式的无审查版本,方便在手机端应用(如 On Device LLM)中直接下载和运行。
统一内存:统一内存(Unified Memory)是苹果 M 系列芯片及部分移动 SoC 采用的内存架构,CPU 和 GPU 共享同一块物理内存池,无需在两者之间复制数据。这种设计对本地运行大模型尤为有利:模型权重只需加载一次,CPU 和 GPU 均可直接访问,减少了数据传输开销和显存瓶颈。因此,配备统一内存的低端电脑(如 8GB 内存的 MacBook Air)也能运行 1.7B 级别的模型,而传统独立显卡方案则要求显存足够容纳模型权重。文中“带统一内存的低端电脑”即指此类设备。
iPhone与Android的部署步骤
iPhone端的操作流程比较直接。首先在App Store搜索并安装“On Device LLM”应用。打开应用后,先选择一个任意模型完成初始设置,然后进入模型选择界面,通过“Search online for Hugging Face”搜索“Atomic Chat LFM3 1.7B uncensored GGUF”并下载。下载完成后回到助手界面,选择该模型即可开始对话。
Android用户则需要使用另一款名为Layla的应用,后续步骤与iPhone基本一致。作者在视频里提到,Atomic Chat虽然也有自己的应用,但与该模型配合时无法正常工作,因此他改用On Device LLM完成演示。
应用内还提供了其他可本地运行的模型选项,例如Qwen 3 1.7B和Qwen 3 4B,用户可以根据设备性能自行选择。
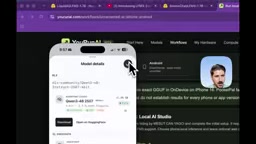
Hugging Face:Hugging Face 是一个面向机器学习模型和数据集的开源社区平台,托管了数十万个预训练模型,涵盖文本、图像、音频等多种模态。用户可以通过平台搜索、下载模型文件,并查看模型卡(Model Card)了解其用途、许可证和限制。文中 On Device LLM 应用内置的“Search online for Hugging Face”功能,允许用户直接在应用内检索 Hugging Face 上的 GGUF 模型并下载到本地,省去了手动传输文件的步骤。Atomic Chat 发布的 LFM3 1.7B uncensored 版本即托管于该平台。
实际性能与使用体验
作者在iPhone 16 Pro Max上测试该模型,得到约26 tokens每秒的生成速度,描述为“相当快”。他认为iPhone 11及以上的机型都能较好地运行这个模型。
除了文本对话,该应用还支持上传图片并向模型提问,使用方式与ChatGPT类似。作者表示,自己过去经常把不希望外传的数据发给ChatGPT,对此感到不满,而本地无审查模型正好解决了这个痛点,他计划日常在手机上使用。
需要注意,视频中展示的性能数据来自单一设备和单一模型配置,不同手机的实际表现会有差异。想要复现的用户可以访问作者提到的指南页面,按步骤操作。
编辑观点
本地小模型能在手机上流畅运行,反映出一个明确趋势:模型压缩与端侧推理的进步,正在把过去需要云端算力才能完成的任务下放到个人设备。对隐私敏感或有特殊内容需求的用户来说,这提供了一种新的选择。
但也要看到,1.7B级别的模型在知识深度和推理能力上无法与大型云端模型相比,无审查也意味着输出质量完全由用户自行判断。把它当作一个私有、离线、不受限的轻量助手是合理的,期待它全面替代主流模型则不现实。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。