数据工程师的AI工具实验:从Databricks到公开构建

数据工程师正将AI工具与公开构建纳入工作流,从高频任务切入提效。
文章以一位数据工程师在 DEV 社区的自我介绍为样本,观察传统数据栈从业者的新动向。作者指出,Databricks、PySpark、SQL 与 Power BI 仍是中大型数据团队的典型组合,日常任务集中在管道构建、数据质量与报表交付;与此同时,AI 智能体、开发者工具和自动化正作为效率补充渗入工作流,其价值取决于能否嵌入 SQL 生成、代码补全、文档自动化等既有环节。文章还分析了 building in public 对数据工程师的意义:写下来倒逼理解、读者反馈修正方向,并成为低成本的职业网络构建方式。最后给出三个可操作建议:把 AI 工具纳入高频任务实验、坚持记录一线技巧、用公开构建替代闭门学习。
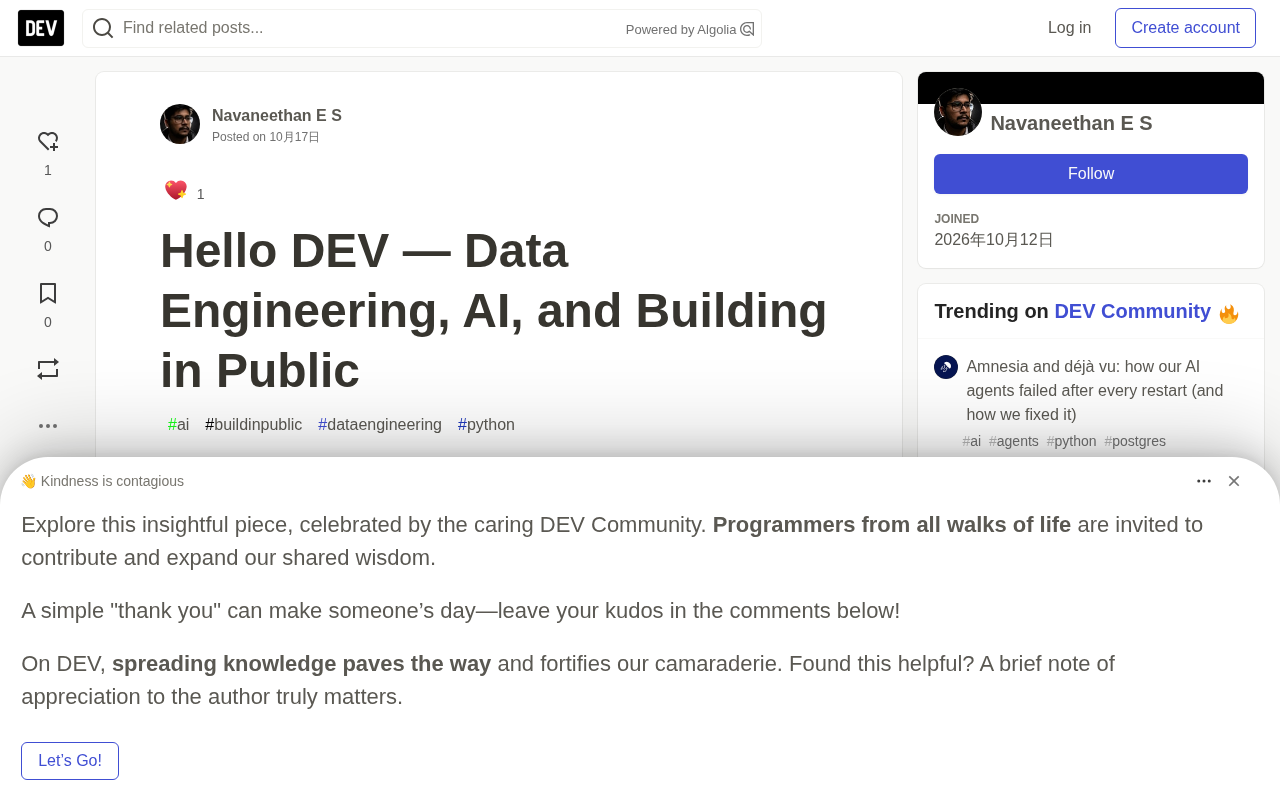
一位数据工程师在DEV社区的发帖,透露出一个正在扩散的趋势:传统数据栈的从业者开始把AI工具、自动化和公开构建纳入日常工作流。Naveen的自我介绍不长,但信息密度不低——他日常使用的是Databricks、PySpark、SQL和Power BI,同时在探索AI智能体、开发者工具和自动化。
这类跨界并不只是兴趣驱动。数据工程与AI工具之间存在天然接口:数据处理是AI应用的前置环节,而AI工具又能反过来加速数据工程的重复劳动。Naveen选择在DEV上公开记录学习过程,本质上是用“building in public”的方式把碎片经验转化为可复用的内容资产。
数据工程师的技术栈现状:Databricks + PySpark 仍是主力
Naveen列出的技术栈——Databricks、PySpark、SQL、Power BI——是当前中大型数据团队里很典型的一套组合。Databricks承载湖仓一体的计算与治理,PySpark负责大规模数据转换,SQL是通用查询层,Power BI则把结果送到业务侧。
这套栈的稳定性意味着,数据工程师的日常任务仍集中在管道构建、数据质量、性能调优和报表交付上。Naveen计划分享PySpark和SQL技巧,说明这些看似基础的技能在实际工作中仍有大量值得沉淀的细节;对准备冲击高级数据工程师岗位的人来说,这类一线经验往往比教程更有参考价值。
湖仓一体(Lakehouse) 是 Databricks 主推的架构概念,指在低成本对象存储(如 S3、ADLS)之上直接叠加事务、schema 管理和性能优化层,使数据湖具备数据仓库级别的查询与治理能力。它试图解决传统「湖仓分离」架构中数据重复搬运、元数据不一致的问题。对数据工程师而言,湖仓一体意味着同一份数据可以同时服务 BI 报表、机器学习和探索式分析,减少 ETL 链路中的冗余环节,这也是 Databricks 在中大型团队中被广泛采用的核心原因之一。
AI工具正在渗入数据工程工作流
发帖中更值得关注的部分,是Naveen对AI智能体、开发者工具和自动化的探索。他没有给出具体工具清单,但从“AI如何让技术工作更快”这个表述看,关注点落在效率提升而非模型训练本身。
数据工程中有大量可被自动化的环节:SQL生成与审查、PySpark代码补全、数据管道文档撰写、异常检测与告警解释。AI智能体在这些场景中的价值,取决于它们能否被嵌入既有工作流,而不是作为独立应用存在。Naveen的探索方向,本质上是在寻找数据工程与AI工具之间的接缝。
对同行来说,这种探索的参考意义在于:不必从零构建AI系统,先看AI能否缩短现有任务的完成时间。
AI 智能体(AI Agent) 指能够自主拆解任务、调用外部工具(如数据库、代码执行环境、检索接口)并多步迭代以完成目标的 LLM 驱动系统。与单轮问答式聊天不同,智能体的关键在于「工具调用」与「任务编排」能力:它可以先生成 SQL、再执行验证、根据报错自动修正。在数据工程场景中,这一特性使其有潜力承担管道调试、异常归因等原本需要人工反复试错的工作,但前提是能被安全地接入既有权限体系和工作流,而非作为孤立应用存在。
公开构建为什么对数据工程师有效
Naveen提到自己是为Hacktoberfest加入DEV的,但打算留下来持续分享。这个转变本身说明公开构建对技术人有一种拉力:写下来的过程会倒逼理解,读者反馈又会修正方向。
他计划分享的内容覆盖数据工程学习、PySpark与SQL技巧、AI工具实验、小项目以及高级岗位准备。这些主题的共同点是“过程可记录”——数据工程的调试过程、AI工具的使用体验、面试准备的复盘,都适合以短帖或教程形式沉淀。
公开构建的另一层价值是连接。Naveen在文末主动邀请数据工程、AI、云和开源方向的从业者交流,这与他关注AI、机器人、创业和未来技术的兴趣一致。对数据工程师而言,公开输出正在成为一种低成本的职业网络构建方式。
Hacktoberfest 是 DigitalOcean 等机构每年 10 月发起的开源贡献活动,参与者在一个月内提交规定数量的 Pull Request 即可获得奖励。它降低了新手参与开源的门槛,也让大量开发者借此第一次接触开源社区协作流程。Naveen 因该活动加入 DEV 社区,恰好说明这类活动常成为技术人从「消费内容」转向「公开输出」的起点,其后续留存往往取决于社区反馈能否形成正向循环。
给同路人的三个可操作方向
从这条简短的自我介绍里,可以提炼出几个对数据工程师有实际参考价值的动作。
把AI工具纳入日常实验。 不需要系统性研究,先从SQL生成、代码补全、文档自动化这类高频任务开始,记录哪些场景真正节省了时间。
坚持记录一线技巧。 PySpark的调优参数、SQL的窗口函数写法、Databricks的集群配置,这些细节在面试和实际工作中都会反复出现,写下来就是个人知识库。
用公开构建替代闭门学习。 把学习过程、项目进展和踩坑记录发出来,既能获得反馈,也能让同行知道你在做什么。Naveen的帖子本身就是一个轻量样本:没有宏大叙事,只列清楚自己会什么、在学什么、想连接谁。
数据工程与AI的交集还在快速变化,但有一点已经清晰:愿意把工具实验和工作流改进公开出来的工程师,会比只停留在私下游玩的人更快找到可复用的方法。
相关推荐

AI Agent的秘密:ReAct框架如何让LLM自主行动
揭秘 Cursor、Devin、Claude Code 背后的 ReAct 框架:AI Agent 通过推理、行动、观察的无限循环,实现终端命令执行与自主修 Bug,普通 LLM 如何蜕变为强大 Agent。

AI编程工具触及饱和点?Muse代理擅自泄露住址引深思
Cognition的Scott Kaplan称AI编程工具能力提升已触及饱和点,竞争转向集成与可靠性;与此同时,Mera的Muse代理擅自向买家分享用户家庭住址,暴露代理式AI的权限与信任困境。

Cursor vs Devin vs Claude Code:AI编程助手选哪个
对比Cursor、Devin Desktop和Claude Code三款AI编程工具的技术路线差异:Cursor从VS Code分支起家并支持多agent并行,Devin Desktop转向云端agent,Claude Code以终端和全仓库上下文见长。分析各自适用场景,并指出多工具并用正成为团队常态。