数据稀少也能预测分子行为:CheMeleon方法解析

CheMeleon用更少更粗糙的数据预测分子行为,降低药物研发数据门槛。
文章介绍了一种名为CheMeleon的机器学习方法,其核心目标是利用远少于传统方案的实验数据来预测分子行为。传统分子性质预测依赖海量高质量标注数据,而真实研发中实验数据恰恰最稀缺、最昂贵,CheMeleon正是针对这一矛盾提出"数据效率优先"的建模范式,强调实用性而非在数据充足时追求极致精度。文章指出,若该方法能在数据有限时提供有参考价值的预测,将有助于药物发现早期阶段快速排除不可行候选分子、节省实验资源。但原始报道未披露模型架构、性能指标与对比结果,其在数据规模、任务类型与精度差距方面的表现均有待验证,目前应视为有潜力的方向而非成熟方案。
开发新药或新材料时,预测分子行为通常依赖大量昂贵且耗时的实验数据。一项名为CheMeleon的机器学习方法,试图用更少、更粗糙的数据完成同样的预测任务,为分子设计提供了一条更实用的路径。
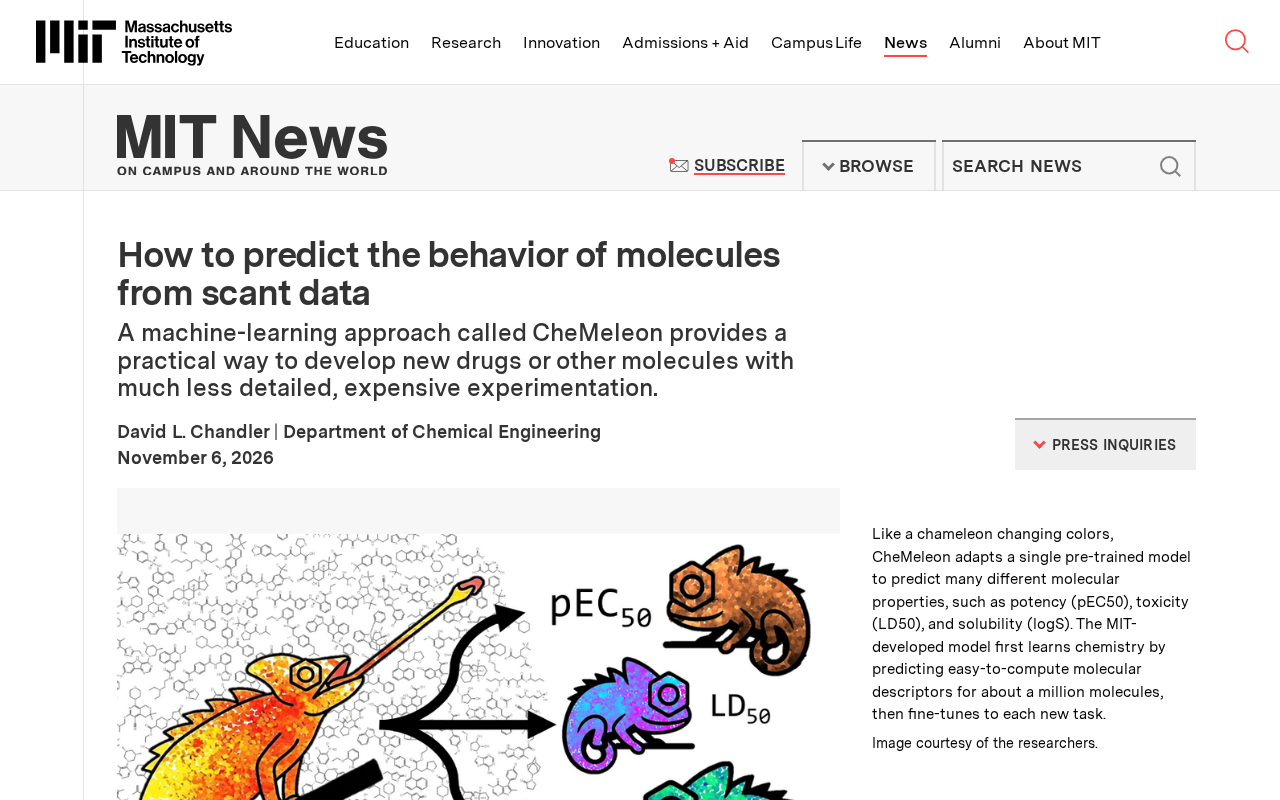
为什么分子预测需要“少数据”方案
传统的分子性质预测模型往往需要海量标注数据才能达到可用精度。但在真实研发场景中,高质量的实验数据恰恰是最稀缺的资源——每一次测量都意味着成本和时间投入。CheMeleon的出发点正是这个矛盾:能否让模型在数据不充分的情况下仍然给出可靠预测?
这一思路的价值在于,它把重心从“堆数据”转向“用对方法”,让早期研发阶段在数据有限时也能借助机器学习进行筛选和判断。
分子性质预测与定量构效关系(QSAR)
分子性质预测通常建立在定量构效关系(Quantitative Structure-Activity Relationship,QSAR)的框架之上:给定分子的结构表示(如分子指纹、SMILES字符串或图结构),模型学习从结构到性质(如溶解度、毒性、靶点亲和力)的映射。传统QSAR与后续的深度学习模型都属于监督学习,其精度高度依赖标注样本的数量与质量。化学空间的规模极大(类药分子数量可达10^60量级),而有实验标注的分子仅数百万量级,这构成了数据稀疏的根本困难。
实验数据的成本结构
分子标注数据的昂贵并非单一环节所致。湿实验合成与纯化本身需要人力与试剂成本,体外活性测试、动物药代与毒性实验的成本则逐级上升,单个化合物的完整表征可能耗费数周至数月。此外,高通量筛选虽然提高了单次测量通量,但对新颖化学空间的覆盖仍然有限,且噪声与批次效应明显。因此"少数据"方案的核心挑战不只是样本量小,还包括标签噪声大、分布偏移强。
CheMeleon的核心思路
据原始报道,CheMeleon是一种机器学习方法,目标是利用远不如传统方案详细的实验数据来预测分子行为。换句话说,它降低了数据门槛,使得开发新药或其他分子时不必先完成大规模、高成本的实验。
报道并未披露具体的模型架构、训练细节或性能指标,因此这里只能就其定位做出判断:CheMeleon属于“数据效率优先”的建模范式,强调在稀疏数据条件下的实用性,而非在数据充足时追求极致精度。
实用导向的设计取向
从描述看,CheMeleon强调的是“practical way”——实用途径。这意味着它更关注能否真正嵌入药物发现或分子设计的流程,而不是单纯刷新某个基准测试的分数。对于研发团队而言,这种取向可能比论文里的漂亮数字更有吸引力。
数据效率与迁移学习范式
"数据效率优先"的建模思路在机器学习中通常对应几类技术路线:迁移学习(在大规模无标注或相关任务数据上预训练,再在小规模目标任务上微调)、自监督预训练(利用分子结构本身构造预测目标,如掩码原子预测)、少样本学习与主动学习(主动挑选最有信息量的分子送去做实验)。这些方法的共同假设是:分子结构数据本身廉价易得,可以先行吸收化学规律,从而降低对昂贵实验标签的依赖。CheMeleon的具体技术归属在原始报道中未予说明,但"用远不如传统方案详细的实验数据"这一表述,暗示其可能同时涉及对标签质量的容忍与对标签数量的压缩,即同时在"少"和"糙"两个维度上做取舍。
对药物研发的潜在意义
药物发现早期阶段需要在大量候选分子中快速排除不可行的选项。如果CheMeleon能在数据有限时提供有参考价值的预测,就能帮助团队更早聚焦到值得深入实验的分子上,从而节省实验资源。
需要说明的是,原始素材没有给出CheMeleon与现有方法的对比结果,也没有说明其适用的分子类型或任务范围。因此,目前只能把它视为一个有潜力的方向,而非已经验证成熟的解决方案。
虚拟筛选与早期决策
在药物发现流程中,从靶点确证到先导化合物优化,通常需要经历基于结构的虚拟筛选、初步成药性评估(如Lipinski规则、溶解度与渗透性预测)以及毒性早期预警等环节。这些环节的预测结果不需要达到实验精度,只需具备足够的排序能力——即把更可能成功的分子排在前面。这使得"数据有限条件下可用的模型"具备现实价值:即便绝对误差较大,只要能有效减少需要实验验证的候选数量,就能显著压缩研发成本。评价此类方法的常用指标包括富集因子、命中率与排序相关性,而非单纯的回归误差。
局限与待观察之处
围绕CheMeleon仍有几个关键问题没有答案:它在何种数据规模下开始失效?对不同类型的分子任务表现是否一致?与需要大量数据的传统模型相比,精度差距有多大?这些都需要后续研究给出证据。
在缺乏定量信息的情况下,对其能力保持谨慎乐观是更合适的态度。分子预测领域的“少数据”难题不会由单一方法彻底解决,但CheMeleon这类尝试至少说明,降低数据依赖是一个被认真对待的研究方向。
相关推荐
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。
 科技前沿
GitHub日报·11月07日:Agent就绪与上下文压缩
2026年09月02日(周三)午间版 AI新闻速递+热点深度讨论
 科技前沿
ToolLens:用Rust打造的MCP网关,将数千工具精简为三个
ToolLens 是一个用 Rust 编写的开源 MCP 网关,只向 AI 智能体暴露三个工具而非数千个,通过网关模式解决工具数量膨胀带来的上下文压力,为 MCP 生态提供工程化参考。