双语语言模型捕捉二语阅读中的跨语言影响

匹配读者母语的双语模型能更准预测二语阅读时间,效应集中于晚期指标。
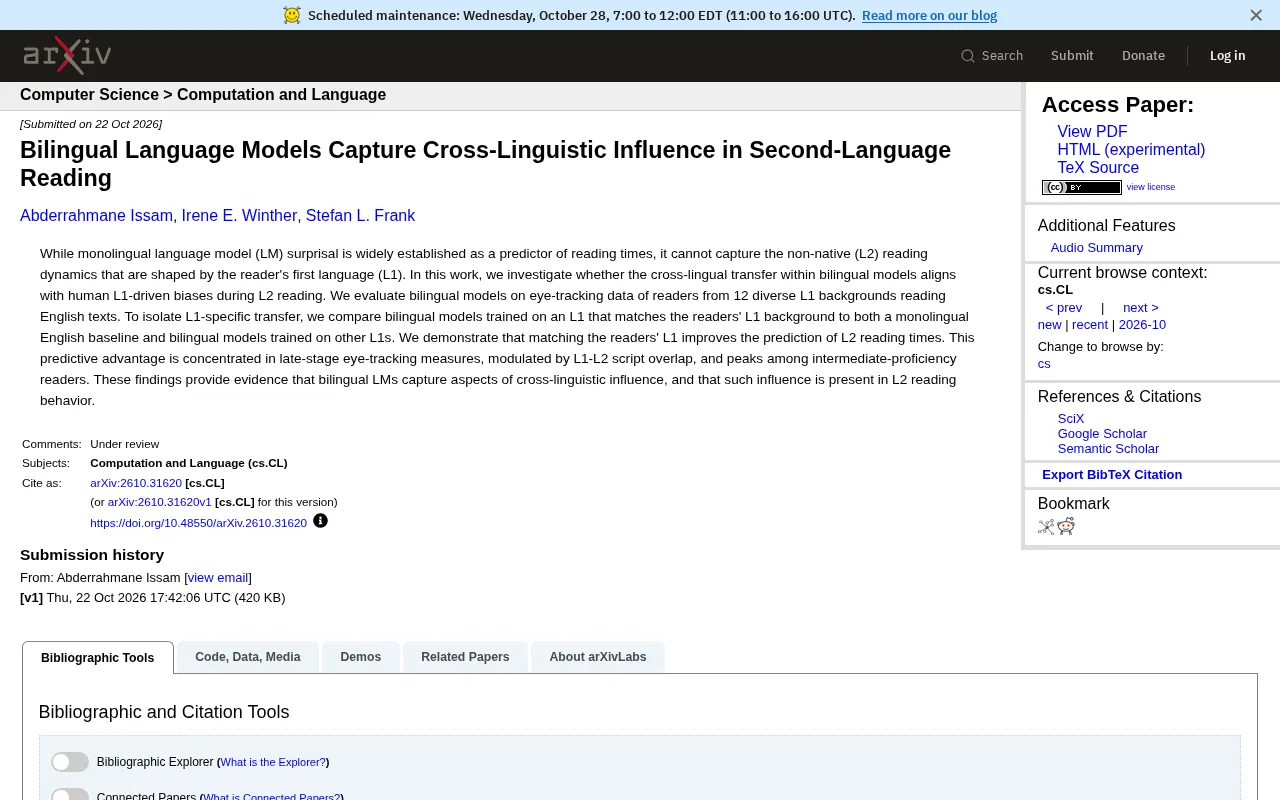
研究比较了双语语言模型与单语模型在二语阅读时间预测上的表现。受试者来自 12 种母语背景,统一阅读英语文本。研究者设置匹配 L1、单语基线和错配 L1 三类预测器,通过多对照组设计分离母语特异性迁移效应。结果显示:匹配读者母语的双语模型预测更准,但优势集中在反映语义整合与重分析的晚期眼动指标;效应受 L1-L2 书写系统重叠度调节,并在中级熟练度读者中达到峰值。研究为双语模型捕捉跨语言影响提供了行为层面证据,但衡量的是预测力而非加工机制。
为什么 monolingual 模型不够用?
阅读时间预测一直是计算心理语言学的经典任务。过去十几年里,单语语言模型的 surprisal(意外度)被反复验证为阅读时间的有效预测因子——词越出乎意料,读者停顿越久。但这套框架有一个隐含假设:读者是母语者。
当读者使用第二语言(L2)阅读时,情况会复杂得多。母语(L1)的词汇、句法乃至书写系统都会对 L2 加工产生跨语言影响(cross-linguistic influence)。单语模型对此无能为力,因为它只建模了目标语言的统计规律,看不到读者头脑中另一套语言系统在暗中发力。
据该研究指出,此前的阅读时间预测工作“广泛建立在单语模型基础上”,却“无法捕捉由读者 L1 塑造的非母语阅读动态”。这构成了本研究的出发点:双语模型内部的跨语言迁移,是否与人类 L2 阅读中由 L1 驱动的偏差对齐?
surprisal(意外度) 是信息论中的概念,指一个词在给定上下文中出现的负对数概率:越不可能出现的词,surprisal 越高。在计算心理语言学中,它被用作“加工难度”的操作化指标——语言模型对某个词的预测概率越低,理论上读者加工该词所需的认知资源就越多。这一指标之所以能预测阅读时间,是因为它隐含地刻画了读者对语言的统计预期;但正因如此,surprisal 完全取决于所用量词模型的质量与训练数据。单语模型只在目标语言语料上训练,其 surprisal 反映的是单语者的统计预期,无法体现双语者头脑中两套语言系统交互产生的预期偏差。
实验设计:用 12 种母语背景的眼动数据做交叉验证
研究团队的做法相当直接:拿双语模型在眼动数据上的预测表现做比较。受试者来自 12 种不同的 L1 背景,阅读的文本统一为英语。
关键设计在于“匹配”与“不匹配”的对照。为了分离出 L1 特异性的迁移效应,研究者设置了三类预测器:
- 匹配组:双语模型训练时使用的 L1 与读者母语背景一致;
- 单语基线:纯英语单语模型;
- 错配组:双语模型训练时使用的 L1 与读者母语背景不一致。
如果匹配组能稳定优于另外两者,就说明模型确实捕捉到了与读者母语相关的某种信号,而不只是英语本身的统计规律在起作用。这种多对照组的设计,比单纯比较“双语 vs 单语”更能排除混淆因素。
三个核心发现
匹配 L1 确实提升预测,但效应集中在晚期指标
结果证实了假设:当模型的训练 L1 与读者母语一致时,对 L2 阅读时间的预测更准。但这个优势并非均匀分布——它“集中在晚期眼动指标上”。
晚期指标通常反映整合与重分析过程,比如回视、二次注视时长等;而早期指标更多反映词汇通达的自动化程度。这一分布模式暗示,跨语言影响主要作用于语义整合和句法重分析阶段,而非最初的词汇识别。换句话说,母语的影子在读者“回味”句子时才更明显。
眼动研究通常把注视指标分为早期指标与晚期指标。早期指标包括首次注视时长(first fixation duration)和首次通过时间(first-pass time),主要反映词汇识别与初始句法分析等相对自动化的过程;晚期指标包括回视时间(regression time)、二次通过时间(second-pass time)和总注视时间(total fixation time),反映的是当读者遇到理解困难后重新阅读、整合语义和进行句法重分析的过程。两类指标对语言操纵的敏感度不同,因此“效应出现在晚期而非早期”本身就是一个有理论意义的分布模式,常用于推断某种因素作用于加工的哪个阶段。
效应受书写系统重叠度调节
研究还发现,匹配 L1 带来的预测优势“受 L1-L2 书写系统重叠度调节”。这符合直觉:母语与英语共用拉丁字母的读者(如西班牙语、德语母语者),其迁移模式与使用西里尔字母、汉字或阿拉伯字母的读者应当不同。书写系统的共享程度决定了哪些层面的语言知识可以直接迁移,哪些需要重新学习。
这一调节效应的存在,也反过来支持了模型捕捉到的不是某种笼统的“外语难度”,而是具体的、与母语结构相关的信号。
中级水平读者受益最明显
最耐人寻味的发现是效应“在中等熟练度读者中达到峰值”。
可以用一个倒 U 形来理解:初学者对 L2 的自动化程度太低,阅读行为更多被普遍的加工困难主导,母语迁移的信号被淹没;高级学习者的 L2 加工已接近母语者,L1 的影响被稀释。恰恰是中级读者,既具备足够的 L2 流畅度让眼动数据反映出精细的加工差异,又尚未摆脱母语系统的深层塑造,因此跨语言影响的痕迹最清晰。
熟练度(proficiency) 在二语习得研究中通常通过标准化语言测试(如词汇量测试、完形填空或 CEFR 等级评定)来测量,用以划分初、中、高级学习者。熟练度之所以是关键调节变量,是因为它同时影响两个方向:一方面,L2 自动化程度随熟练度提高而上升,使眼动数据能够更精细地反映加工差异;另一方面,L1 系统的影响并不会随熟练度线性衰减,而是在中级阶段与正在发展的 L2 系统并存竞争。倒 U 形假设正是这两个方向的叠加结果,也与二语习得中关于“跨语言影响在发展中阶段最活跃”的理论预期一致。
这项研究意味着什么
从方法论上看,它给阅读时间预测研究提了个醒:用单语 surprisal 建模 L2 阅读者,等于系统性地忽略了一个已知存在的方差来源。对于以 L2 读者为对象的研究,双语模型的 surprisal 可能是更合适的预测器。
从理论上看,这些结果为“双语模型捕捉了跨语言影响的某些方面”提供了行为层面的证据,并进一步说明这种影响“存在于 L2 阅读行为之中”。模型内部的语言迁移与人类读者的母语偏差之间存在可测量的对齐,这为用计算模型检验语言迁移假说打开了空间。
局限也很清楚:研究衡量的是预测力而非机制解释,模型“对齐”人类行为不等于模型“像”人类一样加工语言。书写系统重叠度与熟练度的交互细节,也需要更多 L1 组合的数据来刻画。
常见问题
双语模型的 surprisal 能替代单语模型做阅读预测吗?
对于 L2 读者,匹配其 L1 的双语模型预测更准,尤其在晚期眼动指标上。对母语读者,单语基线仍是合理的起点。
为什么效应集中在晚期指标?
晚期指标反映整合与重分析,恰是母语知识最容易介入的阶段;早期词汇通达更依赖自动化识别,受 L1 影响相对小。
哪些读者最值得用双语模型建模?
中级熟练度、且母语与目标语书写系统存在部分重叠的读者,跨语言影响的信号最强。
相关推荐

私钥设为4?CA机构低级错误致TLS体系裸奔
CA机构eMudra将私钥设为数字4等极小值,导致TLS证书可被暴力破解。Computerphile视频演示了从提取公钥到伪造证书的完整过程,并探讨了PKI信任链的脆弱性。

Gen如何用ChatGPT Work把数据变决策
OpenAI用户案例中,企业领导者Gen分享用ChatGPT Work将数据转化为决策的实践:产品上线几小时内即可判断集成与引导流程是否有效,决策迭代从上百次试错变为快速反馈闭环。

ChatGPT与Claude深度对比:编程强但研究弱,如何弥补?
用户考虑从ChatGPT转向Claude,发现Claude编程更强但研究较浅。本文分析两者差异,并提供让Claude研究更深入的实用技巧,帮助您做出明智选择。