思科让27岁工程师用无限AI Token重写98%代码,能成吗?

思科两人团队用无限Token重构98%遗留代码,但决定成败的是自动裁判而非Token。
思科总裁Jeetu Patel向Fortune透露,一名27岁工程师和一名同伴获得无限量AI Token,目标是在24个月内重构公司98%的遗留代码,并用四周证明可行性。舆论聚焦于"无限Token",但文章指出真正的瓶颈是"裁判"——即能自动判断AI生成代码是否正确的测试、编译和linter。文章核查了公开信息中的关键缺失(如"重写"与"重构"的动词差异),回顾了Joel Spolsky的反重写经典论述和Hyrum定律,并以Airbnb、Google、Amazon三次成功的大规模AI迁移为例,说明它们都是行为不变的迁移而非从零重写。文章提出四段流水线(冻结行为、切片迁移、智能体循环、影子验证)作为可行框架,并列出评审瓶颈、长尾、未记录行为、安全和跨团队协调五个Token无法解决的陷阱。
思科总裁Jeetu Patel向Fortune透露,他给了一位27岁工程师无限量的AI Token,目标是在24个月内重构公司98%的遗留代码,而团队只有两个人,且只有四周时间证明可行性。消息一出,舆论聚焦在"无限Token"上,但真正决定成败的,从来不是Token。
事实核查:我们到底知道什么
据Fortune 10月30日发布的采访,这位工程师于2025年随思科收购其实时翻译创业公司Easydubs加入。Patel称他此前"被埋在组织里做无关紧要的事",两人在思科旧金山办公室聊过后,工程师提出两个人就能重写思科的遗留代码。Patel的回应是:"你可以放开手脚干。"
但关键信息大量缺失:没有预算、没有指定模型或编程工具、没有说明涉及哪些代码、哪些语言、多少行。更你可能没注意到动词的差异——工程师说的是"重写(rewrite)",目标写的是"重构(refactor)"。重构保持行为不变、只改结构;重写则是扔掉旧代码从头再来。两者是完全不同的工作。
这也不是思科第一次做AI编程。此前思科与OpenAI合作,Codex将缺陷修复吞吐量提升最高15倍,每月节省超过1500个工程小时;与Sonar为期三个月的试点关闭了约2.7万个技术债务问题。工具链是真实的,问题在于规模。
为什么工程师对"重写"心有余悸
2000年,Joel Spolsky写道,从零重写代码是软件公司能犯的最糟糕的战略错误。他的例子是Netscape:扔掉浏览器代码重来,从版本4到版本6 beta隔了将近三年,市场丢了。
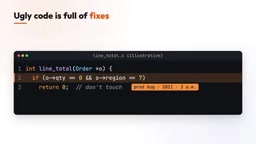
旧代码之所以难替换,是因为丑陋的旧代码里塞满了修复。第400行那个奇怪的检查?那是2011年凌晨三点某人在生产环境发现的bug,除此之外没有任何地方记录过。删掉代码,就删掉了教训。
还有Hyrum定律:用户足够多时,系统的每一个可观察行为都会被某人依赖——不只是文档承诺的部分,还包括错误信息的格式、结果的顺序、调用的耗时。改掉一个保持相等元素顺序的排序,某份报表就会悄悄重排。新代码可以更干净,却仍然弄坏客户。
Michael Feathers给出了多数工程师采用的定义:遗留代码就是没有测试的代码。这才是真问题。如果没有任何东西检查旧代码的行为,就没有东西能告诉你新代码行为一致。
Hyrum定律(又称Hyrum's Law)由Google工程师Hyrum Wright提出,其核心是:当一个API拥有足够多的用户时,无论你在文档中承诺了什么,系统的所有可观察行为都会成为事实上的契约——因为总会有用户依赖这些行为。这里的"可观察行为"不仅包括返回值,还包括错误信息的文本、异常的抛出时机、结果的排序、函数的执行耗时、甚至日志的格式。这意味着,任何看似无害的内部改动,只要改变了这些未文档化的行为,就可能破坏下游系统。在AI重写遗留代码的场景中,Hyrum定律是最大的隐形陷阱:新代码可以逻辑上完全等价,却因为一个错误信息的措辞变化或一次多余的网络调用而让某个客户的生产环境崩溃,而测试往往覆盖不到这些细节。
三次成功的AI大规模迁移
大规模AI迁移已有公开的成功案例,且带数字。
Airbnb将约3500个测试文件从Enzyme迁移到React Testing Library。人工估算需要一年半,实际六周完成。首次批量运行四小时内让75%的文件通过internet,再调优四天达到97%,最后3%由工程师手工修复,又花约一周。
Google发表了一篇关于39次迁移的论文,涉及595处代码变更,模型撰写了约74%的变更代码,工程师估计总时间减半。
Amazon将数万个Java应用升级到Java 17。Andy Jassy称一次升级从约50个开发者日缩短到几小时,开发者未经编辑直接提交了79%的生成变更。
这些案例的共同点:每个都有明确目标(旧框架进、新框架出),每个都有自动检查(测试通过、构建编译、linter满意)。而且没有一个是从头重写——它们都是迁移:行为相同,换新框架。
被忽略的关键:裁判比模型更重要
每一次胜利都有一个不是人的裁判:一台机器,每天免费数千次地判断"这个变更是正确的"。模型从来不是瓶颈,裁判才是。
这改变了你对"无限Token"的解读。Token让尝试变便宜。Airbnb对多数文件重试最多10次,最难的50到100次——这正是无限Token买来的东西:可以反复失败而无人计数。但失败一千次只有在有东西告诉你哪次是对的时才有帮助。
算笔账:假设模型对某个难文件十次里对一次。如果机器检查每次尝试,20次尝试约有88%的通过概率;没有检查,20次尝试只是给你20个看起来都合理的答案。
对于测试迁移,裁判很简单:跑测试。对于没有测试的遗留代码,裁判还不存在。所以任何AI重写的第零步不是写新代码,而是建造裁判。
Golden Master(黄金大师)是一种黑盒测试技术,由Michael Feathers在《修改代码的艺术》中推广,用于为缺乏测试的遗留代码建立行为基线。具体做法是:用大量真实或随机生成的输入调用旧代码,把每一次输出(包括返回值、异常、甚至日志)序列化保存到文件并提交到版本库。此后,任何新版本的代码在相同输入下只要产生一个字符的差异,构建就会失败。Golden Master的哲学是"不判断行为对错,只判断行为是否改变"——它把"正确"定义为"与旧代码一致",从而绕开了缺乏规格说明的问题。对于AI重写任务,Golden Master是理想的自动裁判:生成成本低(AI擅长批量生成输入),判定确定性强(逐字节比较),且能捕获Hyrum定律所描述的未文档化行为。
两个人如何真正尝试:四段流水线
第一段,冻结行为。 动手之前写特征测试:用真实输入运行旧代码,记录它今天的行为——包括bug。这些记录成为"正确"的定义。比如一个40行的价格格式化函数,用10000条记录输入调用它,把每个输出存进文件并提交。此后任何新版本改动一个字符的输出都会让构建失败。这个文件叫golden master。AI恰恰擅长这部分:读旧代码、生成成千上万的输入用例。
第二段,切片。 不替换整个系统,而用绞杀者模式(Strangler fig pattern):在前面放一个路由器,把一个模块迁到新代码并把流量导过去,其余继续跑旧代码。切片坏了就路由回来。
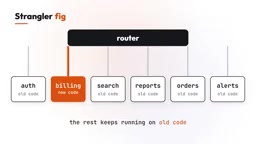
第三段,智能体循环。 对每个切片,模型写新版本,机器检查:能编译吗?特征测试通过吗?Lint?类型?安全扫描?任何失败连同错误直接回给模型重试。人类只看通过的东西。
第四段,在生产中证明。 测试永远覆盖不全,所以让新代码跑影子模式:真实流量同时发给两个版本,用户拿到旧答案,diff工具比较两者。只有输出连续数周一致,才切换流量。
四段是:冻结、切片、循环、影子。大部分Token花在第一和第三段。
绞杀者模式(Strangler Fig Pattern)由Martin Fowler提出,名字来源于热带雨林中绞杀榕的生长方式:榕树种子落在宿主树上,根系逐渐包裹并最终取代宿主。在软件迁移中,该模式的做法是在旧系统前面放置一个路由层(如API网关),将流量逐步从旧模块切换到新模块,每次只迁移一个切片,旧系统其余部分继续运行。如果新切片出现故障,只需将路由切回旧实现即可回滚。这种模式与"大爆炸式重写"形成鲜明对比:后者要求一次性替换整个系统,风险集中且不可逆;绞杀者模式则允许渐进式验证,将失败的影响范围限制在单个切片内。对于AI驱动的重写,绞杀者模式提供了天然的实验边界——每个切片可以独立拥有特征测试和影子验证,从而让"两个人重构98%代码"的目标在工程上变得可分解、可度量。
钱解决不了的五个陷阱
陷阱一,评审。 生成的代码越多,人类的PR就越多。Sonar关于思科的文章称之为"生产力悖论":AI变快了,评审者却淹没了。两个人不可能逐行读完这种规模的重写。要么裁判足够可信以跳过大部分评审,要么评审成为瓶颈。
陷阱二,长尾。 Airbnb从0到75%只用四小时,最后3%花了一周人工。容易的代码先走,而98%的目标意味着硬骨头才是真正的工作。
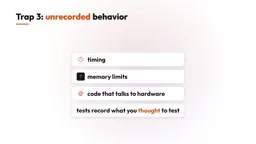
陷阱三,没人记录过的行为。 时序、内存限制、与硬件对话的代码。Hyrum定律再次生效:特征测试只记录你想到要测的东西。
陷阱四,安全。 新代码意味着新bug,其中一些是测试从不检查的那类。
陷阱五,人。 这种规模的重写触及每个拥有旧代码的团队。两个工程师能写,但数百个所有者必须信任它、部署它、为它半夜被叫醒。这是协调问题,不是Token问题。
到底能不能成?
诚实的判断是:以切片方式重构思科大部分代码、由机器做检查——可信,流水线每一段都在某处规模化验证过。两个人两年从零重写98%——没有任何公开证据接近这个程度。两人团队是值得关注的变量。
什么能改变看法?如果证明显示大部分代码都有了可用的裁判,且影子模式几乎没发现差异,那两个人加无限Token真的可能跑赢百人迁移团队。那才是真正的新闻。
四周的证明应该展示什么?不是写了多少行代码——行数现在很便宜。三个数字:目标代码中有多少比例拥有可用的裁判、多少切片通过影子模式、每千行需要多少人工评审小时。
对每个开发者来说,这个故事的真正教训是:稀缺技能不是写代码,而是构建证明代码正确的东西——测试、测试台、diff。AI没有让这份工作贬值,而是让它更值钱。
冻结行为,切片系统,让智能体循环,在影子中证明,Token驱动循环——裁判决定一切。今天就能偷走的一个习惯:在让AI重写任何东西之前,先写出那个能抓住它出错的测试。
相关推荐

beacon.sh:为AI编程助手装上自我进化记忆
beacon.sh 是一款开源、可自我进化的 AI 编程代理记忆层,支持 Claude Code、Cursor、Codex 等 20 多个 harness,把代理会话转化为复利式知识层,解决跨工具记忆断层问题。

Xmind 2027发布:思维导图进化为AI思考伙伴
Xmind 2027 在 Product Hunt 发布,主打「AI 思考伙伴」定位。新增 Xmind Agent 支持基于本地文档与导图做研究,并通过 MCP 将导图上下文接入 ChatGPT、Claude 等 AI 工作流。本文解析其产品逻辑、差异化优势与待验证的问题。

UnleashX:像雇人一样雇佣AI员工,对话直接交付成果
UnleashX在Product Hunt上线,主打像雇人一样雇佣AI员工:选角色、连CRM和工具、设规则,端到端执行工作流,人类仅在必要时介入。本文分析其产品定位、配置逻辑与人机协作边界。