Simon Willison用GPT-5.5构建Datasette限流插件对抗AI爬虫

Datasette发布IP限流插件应对AI爬虫滥用问题
Datasette创始人Simon Willison借助OpenAI Codex开发了datasette-ip-rate-limit插件,解决网站被AI爬虫大量请求轰炸的问题。该插件采用基于IP的速率限制策略,支持通配符路径匹配、静态资源豁免、可配置的限流规则和内存管理,体现了针对性防御、渐进式惩罚的设计哲学,是AI爬虫时代轻量有效的防御方案。
爬虫泛滥催生限流需求
Datasette 创始人 Simon Willison 近日发布了一个新的开源插件 datasette-ip-rate-limit 0.1a0,专门解决 datasette.io 网站被行为不端的爬虫大量请求轰炸的问题。值得一提的是,这个插件借助 OpenAI 的 Codex(基于 GPT-5.5 xhigh 模型)协助构建完成。
Datasette 是 Simon Willison 于 2017 年创建的开源数据探索和发布工具,它能将 SQLite 数据库文件即时转化为可交互的 Web API 和浏览界面。用户无需编写后端代码,只需提供一个 SQLite 文件,Datasette 就能自动生成带有过滤、排序、分页、SQL 查询等功能的完整 Web 应用。这种设计使其成为数据新闻、开放数据发布和快速原型开发的热门选择。Datasette 采用插件架构,开发者可以通过 Python 插件扩展其功能,从认证、缓存到自定义可视化,形成了丰富的生态系统。正因为 Datasette 天然面向公开数据发布,其暴露的 API 端点极易成为爬虫的目标。
这件事折射出当前 Web 生态中两个重要趋势:一是 AI 爬虫对网站资源的消耗日益严重,二是开发者正在用 AI 工具快速构建防御性基础设施。
灵活的配置化限流方案
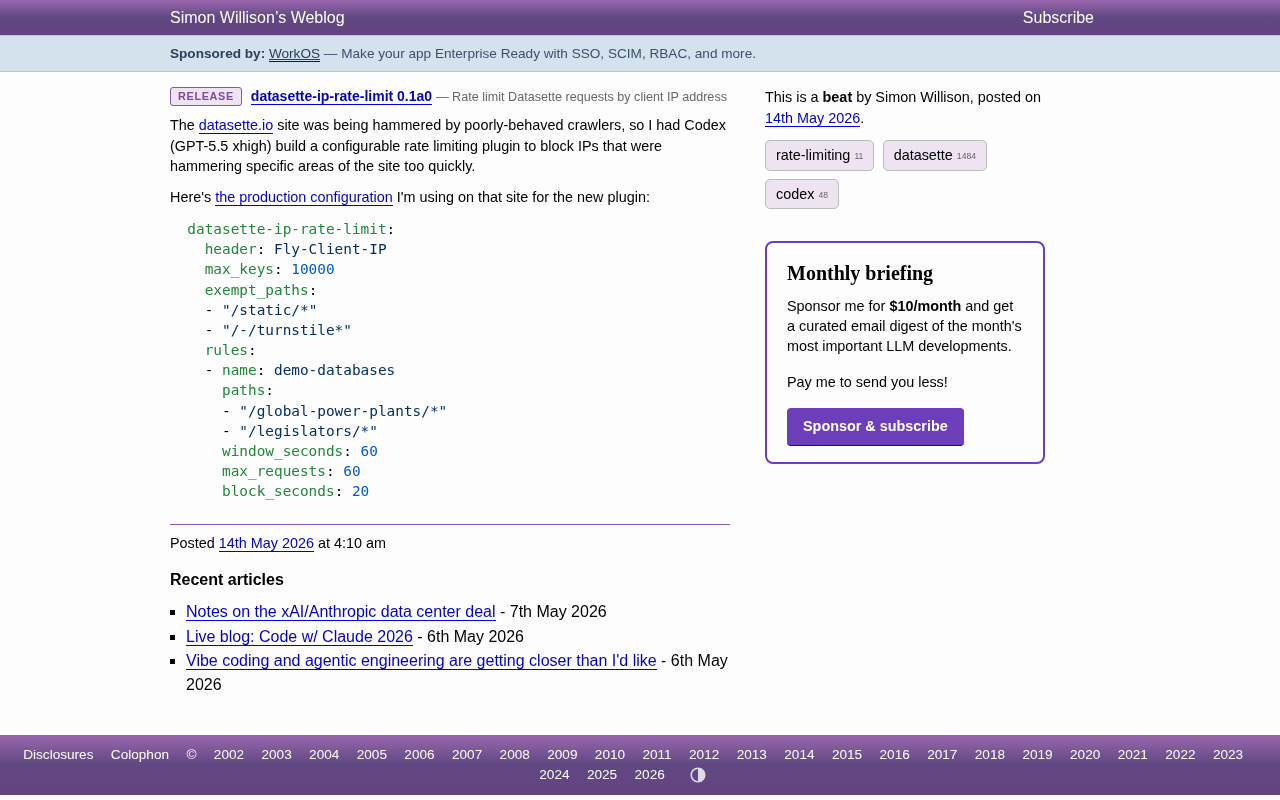
datasette-ip-rate-limit 采用基于 IP 的速率限制策略,支持高度可配置的规则系统。基于 IP 的速率限制通常采用滑动窗口或令牌桶算法实现。滑动窗口算法记录每个 IP 在指定时间窗口内的请求次数,超过阈值则拒绝后续请求;令牌桶算法则为每个 IP 维护一个以固定速率补充的令牌池,每次请求消耗一个令牌,令牌耗尽则触发限流。datasette-ip-rate-limit 使用内存存储来追踪 IP 状态,这意味着它是进程级别的限流,重启后状态会丢失。对于更大规模的部署,通常需要借助 Redis 等外部存储实现分布式限流。从 Simon 公开的生产环境配置来看,插件的设计思路相当清晰。
核心配置参数
- header:指定从哪个 HTTP 头获取客户端真实 IP(示例中使用
Fly-Client-IP,因为站点部署在 Fly.io 上)。Fly.io 是一个边缘计算平台,能将应用容器部署到全球多个数据中心,使应用在物理上更接近用户。当请求经过 Fly.io 的反向代理层时,原始客户端 IP 会被封装到Fly-Client-IP这个自定义 HTTP 头中。这是反向代理架构中的常见模式——由于服务器直接看到的连接来源是代理服务器而非真实客户端,因此需要通过特定的 HTTP 头传递原始 IP。不同平台使用不同的头名称,如 Cloudflare 使用CF-Connecting-IP,通用标准则是X-Forwarded-For。插件通过 header 配置项支持自定义头名称,正是为了适配不同的部署环境。 - max_keys:最大追踪 IP 数量,设为 10000,用于控制内存占用
- exempt_paths:豁免路径列表,静态资源和验证码相关路径不受限制
- rules:具体的限流规则,支持多条规则并行生效
生产环境规则解析
Simon 针对 datasette.io 上的公开演示数据库(如 global-power-plants 和 legislators)配置了如下规则:
- 时间窗口:60 秒
- 最大请求数:60 次(相当于每秒 1 次的平均速率)
- 封禁时长:20 秒
这是一个相当宽松的配置——正常用户几乎不可能触发限制,但自动化爬虫在短时间内遍历带有多参数组合的表页面时,很容易超过这个阈值。封禁时长仅 20 秒,也体现了「惩罚但不过度」的设计哲学。
技术亮点与设计考量
路径匹配的通配符支持
插件支持通配符路径匹配(如 /global-power-plants/*),管理员可以针对特定数据库或表设置不同的限流策略,而不是一刀切地限制所有请求。这对 Datasette 这类数据探索工具尤为重要——某些公开数据集天然更容易成为爬虫目标。
静态资源豁免
配置中明确将 /static/* 和 /-/turnstile* 路径排除在限流之外。前者是 CSS、JS 等静态资源,本身就应该走 CDN 缓存;后者是 Cloudflare Turnstile 验证码的相关端点。Cloudflare Turnstile 是 Cloudflare 推出的免费人机验证替代方案,旨在取代传统的 CAPTCHA(如 reCAPTCHA)。与要求用户识别图片或输入扭曲文字不同,Turnstile 通过浏览器环境检测、行为分析等非侵入式手段判断访问者是否为真人,大多数情况下用户甚至感知不到验证过程的存在。它通过在页面中嵌入 JavaScript 挑战脚本,与 Cloudflare 后端通信完成验证。这也解释了为什么 /-/turnstile* 路径必须被豁免——如果限流阻断了验证脚本的通信,反而会让本应保护网站的人机验证机制失效,形成安全悖论。
内存管理策略
max_keys: 10000 的设置意味着插件最多同时追踪 10000 个不同 IP 的请求状态。这是内存与安全性之间的经典权衡——数字太小可能导致活跃 IP 的追踪记录被过早淘汰,太大则会消耗过多内存。max_keys 参数本质上是对内存中 LRU(最近最少使用)缓存大小的限制,当追踪的 IP 数量达到上限时,最久未活跃的 IP 记录会被淘汰,这意味着一个长时间沉默后突然恢复高频请求的爬虫 IP 可能会绕过限流,但对于绝大多数持续性爬取场景,这一机制已经足够有效。
AI辅助开发的实践案例
这个项目的另一个看点在于开发方式。Simon 明确提到使用了 Codex(GPT-5.5 xhigh) 来构建这个插件。OpenAI Codex 是 OpenAI 于 2025 年推出的云端 AI 编码代理,它能在沙箱环境中自主完成代码编写、测试和调试等软件工程任务。与 ChatGPT 中的对话式编码辅助不同,Codex 更接近一个异步工作的 AI 软件工程师——开发者提交任务描述后,Codex 会在后台独立完成代码实现并提交结果。GPT-5.5 xhigh 是其背后的推理模型配置,其中 xhigh 指的是计算预算等级,意味着模型在生成代码时会投入更多的推理计算资源,以换取更高质量的输出。这种分级计算策略让开发者可以根据任务复杂度选择合适的资源投入。
作为 Datasette 的核心维护者,Simon 对自己项目的插件体系了如指掌,但仍然选择借助 AI 编码工具来加速开发。这说明即使是经验丰富的开发者,在面对明确需求时,AI 编码助手也能显著提升生产力。从需求描述到可用插件的交付,AI 辅助开发正在大幅缩短「从问题到解决方案」的周期。
AI爬虫时代的防御策略
随着各类 AI 公司加大网页数据抓取力度,越来越多的网站运营者面临类似困境。这些 AI 爬虫与传统搜索引擎爬虫有着本质区别——搜索引擎爬虫通常遵守 robots.txt 协议并控制抓取频率,而许多 AI 训练数据爬虫则倾向于无视这些约定,以极高的并发量快速抓取整站内容。对于 Datasette 这类提供结构化数据 API 的服务来说,情况更为严峻:爬虫可以通过组合不同的查询参数生成海量请求,每个请求都会触发数据库查询,消耗的服务器资源远超静态页面的抓取。
datasette-ip-rate-limit 提供了一个轻量但有效的应对方案,其设计思路值得借鉴:
- 针对性防御:不是限制所有流量,而是针对最容易被滥用的路径单独设置规则
- 渐进式惩罚:短时间封禁而非永久拉黑,降低误伤正常用户的风险
- 可观测性:通过命名规则(如
public-demo-multi-parameter-table-pages),方便日志分析和策略调优
对于使用 Datasette 部署数据服务的开发者来说,这个插件填补了一个重要的安全缺口。而对于更广泛的 Web 开发社区,它也是一个值得参考的 IP 限流实现范例。
相关推荐
 产品体验
程序员桌面布局指南:打造让你「回到家」的高效工作空间
探索程序员如何打造高效舒适的桌面布局。从多显示器配置到人体工学设计,解析技术工作者的桌面哲学,帮助你构建提升专注力与生产力的个人工作空间。
 产品体验
Qoder vs Cursor实测对比:同样20美金谁更强?
实测对比Qoder和Cursor两款AI IDE,从Agent自主修复能力、人工沟通次数、架构决策等维度评测。Qoder仅需2次沟通完成任务,Cursor需8次。详细分析两者差异,帮你选择最适合的AI编程工具。
 产品体验
Cursor云Agent演示:打通软件开发全链路瓶颈
深度解析Cursor云Agent最新Demo,展示如何通过云端虚拟机、自动测试产物和全链路控制平面,系统性消除软件开发生命周期中的人类瓶颈,让Agent自主运行、人按需介入。