Simon Willison用tree-sitter为vibe-coded工具建标签云
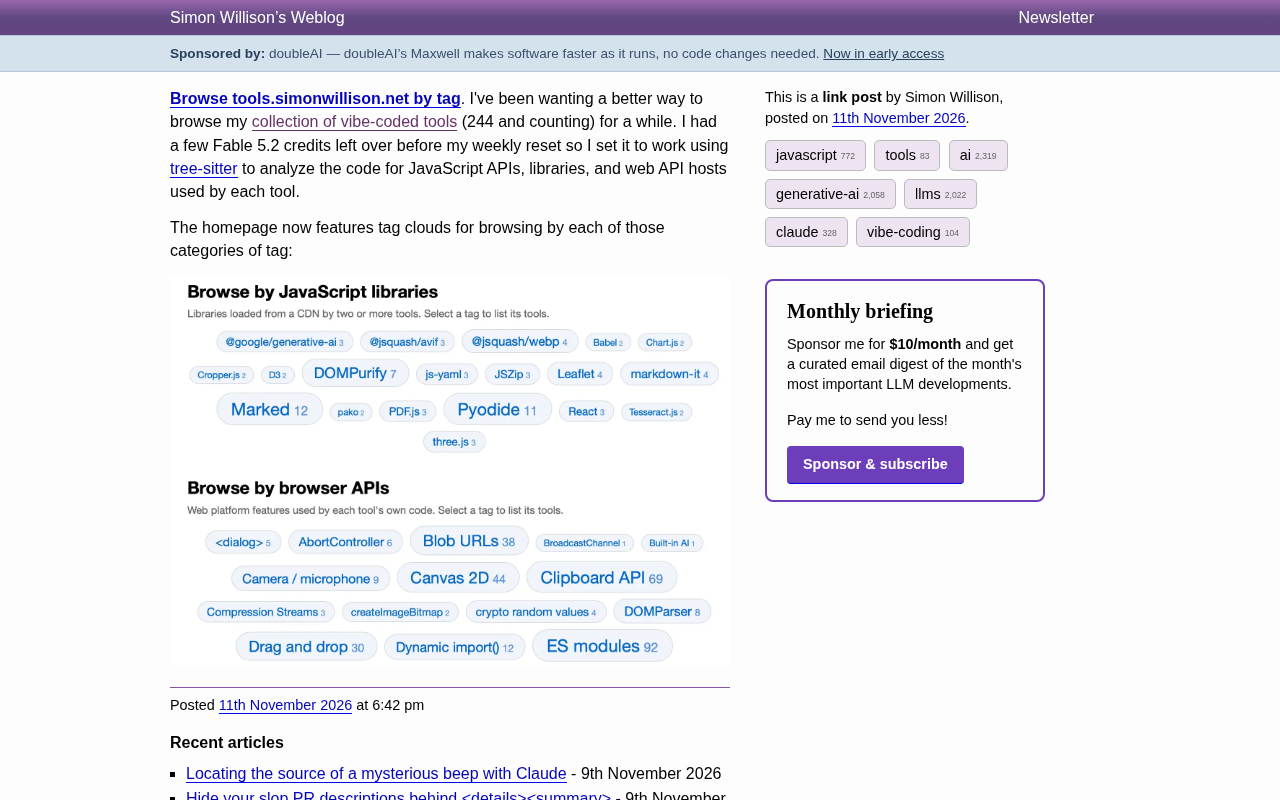
Simon Willison 用 tree-sitter 静态分析 244 个 vibe-coded 工具,自动生成标签云导航。
Simon Willison 的个人工具网站已积累 244 个 AI 辅助写出的 vibe-coded 小工具,作者本人也难以快速定位特定功能。他借助 tree-sitter 对每个工具的代码做静态分析,提取 JavaScript 库、浏览器 API 和 Web API 主机三类标签,并在首页以标签云展示,字号随使用该标签的工具数量变化,点击即可筛选。库标签只统计从 CDN 加载且被两个以上工具使用的库;浏览器 API 标签反映工具自身代码用到的平台特性。该方案展示了 AI 辅助开发工作流的延伸:用代码分析工具链自动理解和组织大量快速生成的代码,比人工维护分类更可持续。
一个更大的问题:如何管理自己写的几百个小工具
Simon Willison 的 tools.simonwillison.net 网站收集了他用 AI 辅助写出的“vibe-coded”小工具,数量已经达到 244 个并且还在增长。这些工具大多短小精悍,各自解决一个具体问题,但时间一长,连作者本人也很难快速找到某个特定功能。
他最近在博客中提到,一直想为这批工具做一个更好的浏览方式。趁着手头还剩一些 Fable 5.2 的额度,他让 AI 助手用 tree-sitter 来分析每个工具的代码,提取其中使用的 JavaScript API、第三方库以及浏览器 Web API,然后自动生成标签。
标签体系是怎么构建的
这个方案的关键在于用 tree-sitter 做静态代码分析。tree-sitter 是一个增量解析器,能够为源代码生成语法树,从而识别出代码中调用了哪些库、使用了哪些浏览器 API。对每个工具,分析过程会产出三类标签:
- JavaScript 库:从 CDN 加载且被两个或更多工具使用的库,比如 marked、Pyodide、DOMPurify、Leaflet、three.js 等。
- 浏览器 API:工具自身代码里用到的 Web 平台特性,比如 Canvas 2D、Clipboard API、Blob URLs、ES modules、拖拽事件等。
- Web API 主机:工具请求的外部服务域名(原文首段提及,标签云截图只展示了前两类)。
这种基于代码事实自动打标的方式,比人工维护标签更可靠,也更能反映工具实际依赖的技术栈。随着新工具加入,标签可以持续更新。
tree-sitter 的增量解析机制:tree-sitter 与传统正则表达式或一次性解析器不同,它会为源码构建具体的语法树,并且在文件被编辑后只重新解析受影响的部分。这种增量特性使它能高效处理大量文件,同时保留语法层级信息——例如可以精确定位“某个函数内部调用了哪些浏览器 API”,而不只是做文本匹配。此外,tree-sitter 提供多语言语法支持,并有 Python 绑定(py-tree-sitter),便于在脚本中遍历 AST、提取函数调用名和对象属性。对 JavaScript 而言,它能区分全局对象访问、成员表达式和字符串字面量中的 CDN 地址,因此适合用来生成“代码实际依赖了什么”的结构化标签,而不是依赖人工声明的元数据。
CDN 加载与库使用统计:原文中“从 CDN 加载且被两个或更多工具使用”这一筛选条件,本质上是在识别通过 <script src="https://cdn..."> 或动态 import() 引入的第三方库。限定“两个以上工具使用”可以过滤掉偶然引入或一次性试验的依赖,让标签云只展示真正具有复用价值的库。这种统计方式也意味着:如果一个库被工具内联打包或自行实现,就不会出现在标签中。因此标签云反映的是“可外部识别的共享技术栈”,而非所有可能的依赖。对读者理解标签云的含义很重要——它是一份基于代码事实的近似统计,而不是绝对完整的依赖清单。
标签云作为导航入口
首页现在用标签云展示这些标签,标签字号大小与使用该标签的工具数量挂钩。点击任意标签,就能列出带有该标签的所有工具。
从截图可以看到,标签云分成两个区块:“按 JavaScript 库浏览”和“按浏览器 API 浏览”。每个区块的说明文字写得很清楚——库标签统计的是从 CDN 加载且被两个以上工具使用的库;浏览器 API 标签统计的是每个工具自身代码中使用的平台特性。
这种设计让浏览者可以按技术兴趣探索工具集合。比如想找使用了 Pyodide 的工具,或者想看看哪些工具用到了 Canvas 2D,直接点击对应标签即可。对作者自己来说,这也是一种回顾技术选型分布的方式。
标签云的信息可视化逻辑:标签云通过字号大小编码工具数量,属于一种轻量级的信息可视化。它的优势是让高频标签在视觉上突出,用户无需阅读列表就能感知技术栈分布;局限是字号与数量之间不是线性映射,精确数量仍需点击查看。原文中标签分区块展示(JavaScript 库与浏览器 API),实际上是对标签做了维度切分,避免不同语义的标签混在一起。这种“先分类、再按频次缩放”的做法,适合导航规模不大(数百个条目)的个人工具集合,也能让作者快速发现哪些库或 API 正在成为自己的常用工具。
对 vibe-coding 工作流的启示
Simon Willison 是 vibe-coding 概念的积极实践者,他的工具集合本身就是一个持续增长的样本库。这次用 tree-sitter 自动分析代码生成标签,展示了 AI 辅助开发的一个延伸方向:当 AI 帮你快速写出大量代码后,同样可以用工具链来自动理解和组织这些代码。
从技术角度看,tree-sitter 的语法树分析不依赖运行时,能够快速处理整个代码库。对于以单文件 HTML 或小型 JavaScript 项目为主的工具集合来说,这种静态分析方式成本低、覆盖全。对于同样在积累个人工具库的开发者,这个思路值得借鉴——用代码分析自动生成元数据,比手动维护分类更可持续。
静态分析在个人项目中的适用边界:tree-sitter 的静态分析不执行代码,因此能安全、快速地处理整个代码库,但它只能看到语法层面显式出现的调用和导入。如果工具通过字符串拼接动态加载库、在运行时从配置中读取 API 名称,或者依赖服务端返回的脚本,静态分析就可能遗漏。对于以单文件 HTML 或小型 JavaScript 项目为主的工具集合,这种遗漏通常影响不大;但随着项目复杂度上升,可能需要结合运行时探测或手动标注来补全。理解这一边界,有助于判断自动打标结果在什么范围内可信、在什么情况下需要人工复核。
值得关注的细节
标签云里出现的库和 API 名称本身也透露了这批工具的技术特征:Pyodide 的出现说明有不少工具在浏览器里跑 Python;Canvas 2D 和 Clipboard API 的高频使用反映了这些工具偏向交互式和实用型;DOMPurify 和 markdown-it 的出现则暗示不少工具涉及 Markdown 渲染和 HTML 净化。
这些标签不仅是导航工具,也是一份关于“vibe-coded 工具通常依赖什么”的间接统计。对于想了解当前轻量级 AI 辅助开发技术栈的人来说,这个标签云提供了一个真实的观察窗口。
相关推荐

AI时代为何必须掌握Git:从版本控制到Agent协作
Git和GitHub有什么区别?AI Agent写代码后如何用Issue、分支和Pull Request管理改动?本文基于NetworkChuck的Git教程,梳理从git init到冲突处理的完整流程,并分析AI时代版本控制为何成为必备技能。
OpenAI 6.2 Astra实测翻车:跑分惊艳,为何开发者却说难用?
OpenAI 6.2 Astra 跑分全面领先且价格更低,但早期测试者反馈其在长任务中频繁卡死、输出难以解析、资源管理失控。本文梳理实测中的真实体验与官方数据之间的落差,并分析这对开发者选型的意义。
GTA VI咖啡系统细节曝光:热咖啡竟能泼人?
Vergecast播客揭秘GTA VI咖啡系统:玩家可在公寓冲泡、自动贩卖机购买、餐厅点单,甚至将热咖啡泼向他人。这种对日常交互的细致还原延续了荒野大镖客2的沉浸感设计,引发对游戏细节与玩法平衡的讨论。