SimRig:为具身AI打造统一实验层,告别重复造轮子

具身智能开发者的共同痛点
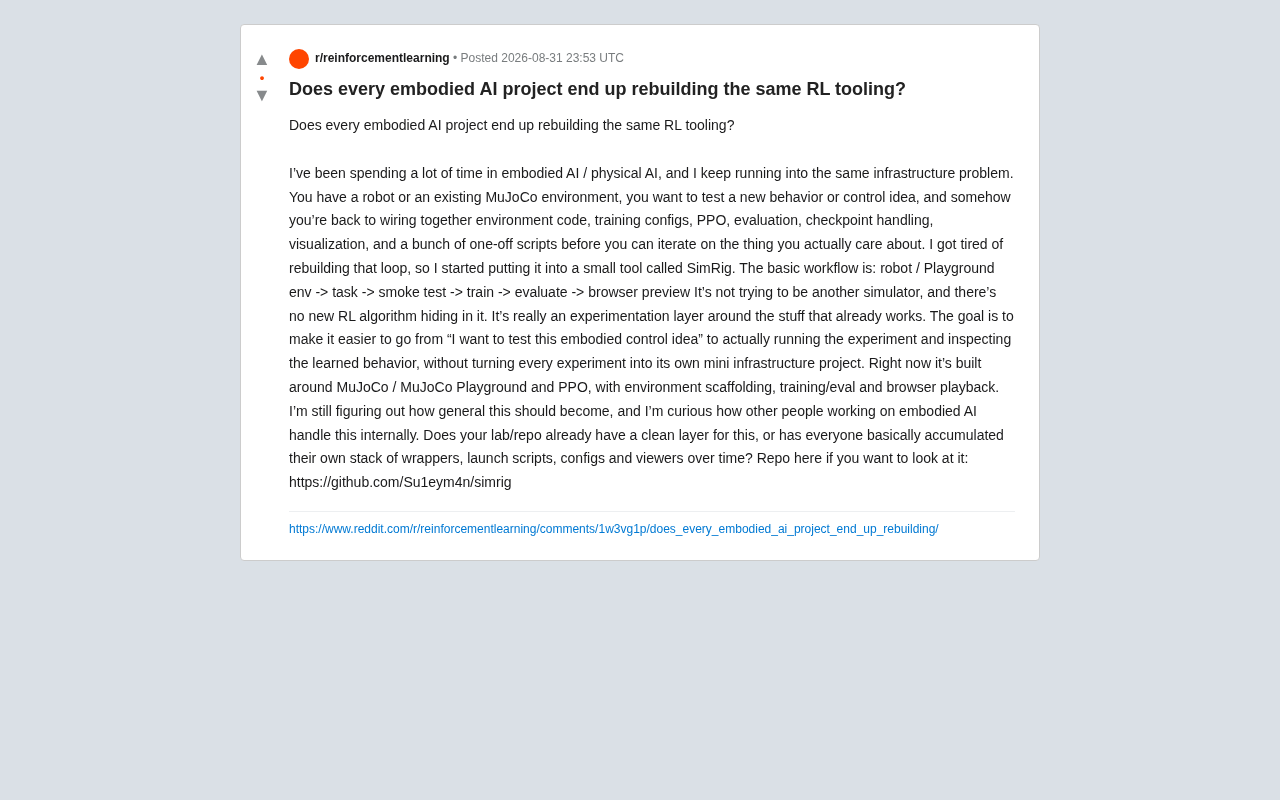
在具身AI(Embodied AI)与物理AI(Physical AI)领域深耕的开发者,几乎都遭遇过同一个令人疲惫的场景:你手头有一个机器人,或者一套现成的 MuJoCo 环境,只是想测试一个新的控制策略或行为想法,结果却发现自己又回到了原点——重新拼接环境代码、编写训练配置、接入 PPO 算法、处理评估流程、管理检查点(checkpoint)、搭建可视化界面,还有一堆一次性的脚本。
具身AI(Embodied AI)是指将人工智能嵌入到具有物理实体的系统中——如机器人、自动驾驶车辆或智能无人机——使其能够感知、理解并与真实物理世界进行交互。与纯粹在数字环境中运行的AI不同,具身AI需要处理重力、摩擦、碰撞等物理约束,这使得其研发复杂度呈指数级增长。这一概念的学术根基可以追溯到MIT人工智能实验室的Rodney Brooks在1990年代提出的"情境化智能"(Situated Intelligence)理论——他认为真正的智能不能脱离物理身体和环境而存在,必须通过与世界的持续交互来涌现。Brooks为此设计了著名的包容架构(Subsumption Architecture),彻底抛弃了传统AI的符号推理范式,转而用分层的反应式行为模块来构建机器人控制系统——这一激进立场在当时引发了人工智能领域的深刻论战。三十年后的今天,这一理念正在以全新的技术形态复兴:研究者们将大语言模型与机器人控制相结合,构建能够理解自然语言指令并在物理世界中执行复杂任务的多模态具身代理(Embodied Agent),斯坦福大学的Mobile ALOHA、Google DeepMind的RT-2等项目就是这一趋势的代表。其中RT-2(Robotic Transformer 2)将视觉-语言模型直接端到端地用于机器人动作预测,以"动作词元"的形式将机械臂控制指令编码进语言模型的输出空间,从而使机器人能够执行从未在机器人数据中见过、但在互联网文本和图像中出现过的任务——这一突破深刻揭示了大规模预训练知识向物理世界迁移的可能性。
物理AI(Physical AI)则是NVIDIA CEO黄仁勋近年来大力推广的概念,强调AI系统必须理解和遵循物理定律,能够在三维空间中自主导航和操作。NVIDIA围绕这一愿景构建了完整的技术生态:Omniverse平台提供了基于Universal Scene Description(USD)的协作式3D仿真环境——USD最初由Pixar开发,用于大规模视觉特效制作中的场景描述与协作,NVIDIA将其引入工业仿真领域后,使得同一个场景资产可以在设计工具、仿真引擎和渲染管线之间无缝流转;Isaac Sim则专门面向机器人开发提供高保真仿真、合成数据生成和域随机化工具,其底层基于NVIDIA自研的PhysX物理引擎,支持GPU加速的大规模并行仿真。2024年NVIDIA进一步推出了Project GR00T人形机器人基础模型,试图为物理AI建立类似GPT之于语言AI的通用基座——GR00T采用了模仿学习与强化学习相结合的训练范式,利用人类动作捕捉数据和仿真环境中的大规模强化学习来构建通用的机器人操作先验。这两个概念——具身AI和物理AI——在学术界和工业界正在加速融合,成为继大语言模型之后最受关注的AI前沿方向之一。
一位 Reddit 用户近日发帖引发了这个话题的广泛共鸣。他坦言:"我厌倦了反复重建这个循环。"在真正开始迭代那个自己关心的核心问题之前,大量时间被消耗在了基础设施的搭建上。这不是个例,而是整个具身AI领域普遍存在的结构性问题。
为什么每个具身AI项目都在重复造轮子?
强化学习(RL)驱动的具身智能实验,天然涉及一条相对固定的流程链:环境定义、任务设定、训练、评估、结果可视化。理论上这条链路的大部分环节是可复用的,但现实中,由于缺乏统一的实验层(experimentation layer),每个实验室、每个代码仓库最终都积累出了自己的一套封装器(wrappers)、启动脚本、配置文件和查看器。
这种碎片化的技术根源值得深入剖析。OpenAI在2016年推出的Gym(现已演化为Farama基金会维护的Gymnasium)为强化学习环境定义了统一的交互接口——reset()、step()、render()——这在环境层面实现了一定程度的标准化,使得同一个算法可以无缝切换不同环境。Gymnasium还通过VectorEnv接口支持多环境并行采样,并引入了Wrapper类的标准化组合模式,使得观察空间归一化、帧叠加、奖励缩放等预处理操作可以以装饰器模式灵活叠加,而不必修改底层环境代码。然而,Gym/Gymnasium的标准化止步于环境交互API:它并未覆盖训练循环管理、实验配置、超参数追踪、检查点策略、评估流程、结果可视化等上层工程流程。与此同时,不同的物理仿真引擎——MuJoCo、NVIDIA Isaac Gym/Isaac Lab、PyBullet、SAPIEN——虽然都可以通过Gym接口暴露环境,但在底层API、场景定义格式、渲染管线、并行化策略等方面各有差异,导致从一个仿真器迁移到另一个仿真器时往往需要大量改写。这种"底层已有标准但上层缺乏标准"的夹层状态,正是重复造轮子现象的结构性根因。
这种碎片化带来了显著的效率损耗:新想法的验证成本被无谓地抬高,实验难以复现,团队间的协作也因工具链不一致而受阻。发帖者一针见血地指出,问题的本质在于——每一次强化学习实验都变成了一个"迷你基础设施项目"。这一现象在具身AI领域尤为突出,因为相比纯粹的计算机视觉或自然语言处理任务,具身智能实验涉及的组件更多、耦合更紧密:物理仿真引擎、传感器模拟、动力学约束、奖励函数设计、策略网络架构、训练超参数——任何一环的变动都可能引发连锁调整,而缺乏标准化实验层意味着这些调整每次都要手动处理。
SimRig:不做新造的,只做缺失的
为了解决这一痛点,这位开发者构建了一个名为 SimRig 的轻量级具身AI实验框架。值得强调的是,SimRig 的定位非常清晰:它既不试图成为又一个仿真器,也没有隐藏什么全新的 RL 算法。它本质上是围绕那些"已经能正常工作"的组件所构建的一个实验层。
在软件工程中,这种"实验层"是介于底层基础设施(如仿真引擎、算法库)和上层应用逻辑(如具体的控制策略设计)之间的中间抽象层。它负责管理实验生命周期中的通用流程:配置管理、训练循环编排、检查点保存与恢复、指标记录、结果可视化等。PyTorch Lightning 就是这一理念在深度学习领域的成功典范——它并不替代 PyTorch 本身,而是将训练循环、分布式训练、混合精度等工程细节抽象为标准化接口,让研究者专注于模型架构和损失函数的设计。具体来说,PyTorch Lightning 通过LightningModule抽象训练逻辑,通过Trainer封装训练循环和硬件适配,使得同一份模型代码无需修改即可在单GPU、多GPU、TPU集群上运行,并自动处理梯度裁剪、学习率调度、日志记录等繁琐细节。这种关注点分离(Separation of Concerns)的设计哲学使研究代码的可读性和可复现性大幅提升。SimRig 试图在具身AI领域实现类似的角色定位。
核心工作流
SimRig 定义了一条简洁的标准化流程:
机器人 / Playground 环境 → 任务 → 冒烟测试 → 训练 → 评估 → 浏览器预览
这条流水线的价值在于,它把开发者的注意力从"如何搭建实验"转移回到"这个具身控制想法本身是否有效"。从"我想测试这个控制思路"到真正跑起实验、并检视学习到的行为,中间的工程摩擦被大幅降低。其中"冒烟测试"(smoke test)环节尤为值得注意——在正式启动可能耗费数小时甚至数天的训练之前,先用极短的训练周期验证环境配置、奖励信号和策略网络是否基本可用,这一简单步骤在实践中能节省大量调试时间。具身AI实验中的冒烟测试尤为关键,因为常见的问题包括:奖励函数中的符号错误导致策略学到完全相反的行为(例如本应惩罚跌倒的负奖励被错误地取绝对值,变成鼓励跌倒);观察空间维度不匹配导致的静默错误——策略网络接收到截断或填零的观察向量,但训练仍能正常进行,只是永远无法收敛;物理仿真参数设置不当导致的数值爆炸,如关节力矩过大使机器人"飞天"(NaN/Inf在loss中出现);以及接触动力学的穿透问题,即物体相互穿插导致仿真失真而策略却学会了利用这一bug。这些问题如果在长时间训练后才被发现,代价极其高昂——不仅浪费了计算资源,更可能让研究者对一个根本上配置错误的实验得出错误的结论。一个规范的冒烟测试通常只需运行100-1000个环境步骤,检查奖励曲线的方向、观察值的范围是否合理、以及是否出现NaN——这几分钟的投入可以为后续数小时的训练保驾护航。
技术栈选择
目前 SimRig 构建在业界成熟的技术基础之上:
- 仿真环境:MuJoCo 与 MuJoCo Playground
- 训练算法:PPO(近端策略优化)
- 配套能力:环境脚手架(scaffolding)、训练与评估、浏览器回放
这种"站在巨人肩膀上"的思路是明智的。MuJoCo(Multi-Joint dynamics with Contact)是由华盛顿大学教授Emanuel Todorov开发的高精度物理仿真引擎,最初作为商业软件发布,2021年被DeepMind收购后于2022年正式开源,这一决定极大地推动了机器人RL研究的民主化。MuJoCo的核心技术优势在于其广义坐标(Generalized Coordinates)物理求解器——相比传统基于笛卡尔坐标的刚体仿真,广义坐标天然地处理关节约束,避免了约束力的显式求解,使得多关节系统的仿真在数值稳定性和计算效率上都有显著优势。它的接触动力学模型采用了凸优化框架来解决摩擦锥约束,能够精确模拟刚体、关节、肌腱、摩擦力和碰撞等复杂物理现象,使研究者能够在虚拟环境中安全、高效地训练机器人控制策略,再将学到的策略迁移到真实硬件上。MuJoCo Playground 则是基于 MuJoCo 构建的一系列预配置环境集合,提供了从简单的倒立摆到复杂的人形机器人行走等丰富的基准任务,覆盖了locomotion(运动控制)、manipulation(操作)和dexterous hand(灵巧手)等多个研究方向。
值得注意的是,MuJoCo在具身AI仿真领域并非没有竞争者。NVIDIA的Isaac Gym(及其后继者Isaac Lab)利用GPU大规模并行仿真的优势,可以同时运行数千个环境实例,将训练速度提升数个数量级——Isaac Lab在A100 GPU上可以并行运行超过4096个机器人实例,使得原本需要数天的人形机器人行走训练压缩到数小时内完成,这对于需要海量样本的强化学习算法尤为重要。PyBullet以其Python原生的易用性和活跃的社区在教育和原型开发中占有一席之地,尽管其仿真精度和速度不及MuJoCo,但其完全开源(基于Bullet物理引擎)和零成本的特点使其成为入门教学的首选。SAPIEN则专注于机器人操作任务的精细仿真,特别是在灵巧手操作和家庭场景交互方面表现突出,其底层基于NVIDIA PhysX引擎并深度优化了铰接体(articulated body)的仿真效率,在PartNet-Mobility等家庭物品操作基准上被广泛采用。此外,Google DeepMind推出的基于JAX的MJX(MuJoCo XLA)以及Brax,通过将物理仿真编译为可在GPU/TPU上高效执行的XLA计算图,为MuJoCo生态注入了大规模并行化的能力——MJX保持了与原版MuJoCo完全相同的物理语义和MJCF场景格式,同时获得了与Isaac Gym相近的并行化速度,兼顾了生态兼容性和计算效率。SimRig当前选择MuJoCo作为首要支持的仿真后端,既受益于其学术界的广泛采用和丰富的基准环境,也保留了未来扩展到其他仿真引擎的可能性。
PPO(Proximal Policy Optimization,近端策略优化)由OpenAI的John Schulman于2017年提出,是一种策略梯度类强化学习算法。其核心创新在于通过裁剪(clipping)目标函数来限制每次策略更新的幅度,避免了策略更新步长过大导致的训练不稳定问题。从数学角度看,PPO的裁剪目标函数为:$L^{CLIP}(\ heta) = \mathbb{E}[\min(r_t(\ heta)\hat{A}_t, \ ext{clip}(r_t(\ heta), 1-\epsilon, 1+\epsilon)\hat{A}_t)]$,其中$r_t(\ heta)$是新旧策略的概率比,$\hat{A}_t$是优势估计,$\epsilon$通常取0.1或0.2。这个看似简单的min-clip操作,优雅地实现了"策略改进但不过激"的约束:当策略更新方向正确时允许改进,但通过截断防止过度更新导致策略崩溃。相比其前身TRPO(Trust Region Policy Optimization),PPO在保持相近性能的同时大幅简化了实现复杂度——TRPO需要计算和求解复杂的约束优化问题(涉及Fisher信息矩阵的求逆,计算代价为$O(n^2)$甚至$O(n^3)$),而PPO仅通过一个简单的min-clip操作就近似实现了信赖域约束。从OpenAI Five打Dota 2到机器人灵巧操作,PPO在众多里程碑式成果中都扮演了关键角色,至今仍是最通用、最可靠的基线算法之一。
不过,PPO在具身AI领域也面临着新的挑战和替代方案的竞争。在连续控制任务中,SAC(Soft Actor-Critic)凭借其最大熵框架和样本效率优势,在许多基准上展现出与PPO相当甚至更优的性能——SAC的最大熵目标函数不仅最大化累积奖励,还最大化策略熵,这使得学到的策略天然具有探索性和鲁棒性,在需要精细操作的任务中尤为有效。基于世界模型的方法——如DreamerV3——通过在学到的环境模型中进行"想象"训练来大幅提升样本效率,DreamerV3在Atari、DMControl、Minecraft等跨领域基准上以统一的超参数取得了当时的最优成绩,这对于真实机器人实验(数据采集成本极高)尤为有吸引力。更具颠覆性的是,近期大语言模型驱动的奖励函数自动设计方法——如NVIDIA的Eureka框架——展示了一种全新的范式:利用LLM自动生成和迭代优化奖励函数代码,在笔旋转等高难度灵巧操作任务上超越了人类专家手工设计的奖励函数,大幅减少了RL实验中最耗时的人工奖励工程环节。这些新趋势意味着,一个好的实验层框架不仅需要支持当前的主流算法,还应具备足够的灵活性来容纳未来的算法演进。
SimRig 没有重新发明这些底层能力,而是把它们组织成一套开箱即用的实验框架,让开发者省去繁琐的胶水代码。
一个值得整个社区思考的问题
发帖者在文末抛出了一个开放性问题,也是这篇讨论最有价值的部分:其他从事具身AI的团队,内部是如何处理这个强化学习工具链问题的?
他好奇地问道:你的实验室或代码仓库是否已经拥有一个干净的实验层?还是说,大家其实都是随着时间推移,各自积累了一堆封装器、启动脚本、配置和查看器?
这个问题触及了具身智能工程实践的深层现状。相比于算法研究的高歌猛进,工程基础设施的标准化往往是被忽视的一环。当每个团队都在私有地重复建设相似的工具链时,整个领域实际上在为同一个问题反复付出成本。这一问题在 Sim-to-Real Transfer(仿真到现实迁移)的背景下显得更加突出——具身AI研发的最终目标是将在仿真环境中训练的策略部署到真实机器人上,而这一环节的成功率与整个工具链的质量密切相关。
Sim-to-Real迁移之所以困难,根本原因在于"现实差距"(Reality Gap):仿真环境无论多么精细,都无法完美复现真实世界的所有物理细节——传感器噪声的分布、执行器的非线性特性、材料表面的微观摩擦系数等。为了弥合这一差距,研究者发展出了多种技术路线。域随机化(Domain Randomization)是其中最广泛采用的方法,其理论直觉在于:如果策略在足够多样化的仿真条件下都能工作,那么真实世界不过是其所见过的众多变体之一。OpenAI的Dactyl项目通过对数百个物理参数(包括物体质量、摩擦系数、关节阻尼、执行器延迟,甚至仿真时间步长本身)进行大范围随机化,成功训练出了能在真实Shadow Robot手上解魔方的策略,而无需任何真实机器人数据——这一成果被视为域随机化方法的里程碑式验证。系统辨识(System Identification)则走了另一条路:通过精确测量真实系统的物理参数,在仿真中尽可能还原真实硬件的特性,典型方法包括最大似然估计和贝叶斯优化。域适应(Domain Adaptation)则利用少量真实数据来调整在仿真中训练的模型,近年来还出现了将仿真数据与少量真实演示数据相结合的"自适应迁移"方法。这些技术的有效实施都依赖于实验工具链的可靠性——域随机化需要灵活的参数配置系统,系统辨识需要精确的实验记录和对比分析,域适应需要仿真和真实数据的无缝切换。当实验工具链不统一、不标准化时,研究者很难精确定位策略失败是由算法设计问题还是工程实现问题所导致。
实验层的价值被低估了
从更宏观的视角看,SimRig 所代表的"实验层"理念,正是机器学习工程走向成熟的标志之一。在深度学习的其他领域,我们已经看到诸如 PyTorch Lightning、Hugging Face Transformers 这样的框架,通过抽象出可复用的训练与评估流程,极大地释放了研究者的生产力。PyTorch Lightning 将训练循环、分布式训练、混合精度等工程细节标准化为简洁的接口;Hugging Face Transformers 在NLP领域实现了预训练、微调、推理流程的一站式管理,其pipeline抽象使得调用一个BERT模型做文本分类与调用GPT-2做文本生成使用完全一致的接口——这种统一性大幅降低了新模型的采用门槛,并催生了Model Hub这一模型共享生态。实验追踪工具如Weights & Biases和MLflow则进一步解决了超参数记录、实验对比和团队协作的问题,使得"哪个实验用了什么配置"这类基础但耗时的问题得到了系统化解决。这种分层架构的价值在于:底层组件可以独立演进,上层实验可以快速迭代,而实验层保证了两者之间的稳定连接。
具身AI领域同样需要这样的抽象层,而且已经有一些项目在不同维度上尝试解决这一问题。Stable-Baselines3提供了一系列经过严格测试和文档化的RL算法实现,其设计哲学是"可靠胜于新颖"——每个算法都经过多个基准的性能验证,并配有详细的超参数建议。CleanRL以单文件实现的方式追求算法代码的透明性和可理解性,每个算法的完整实现控制在几百行内,使得研究者可以一眼看清算法的每个细节而无需在多个文件间跳转,这在教学和算法研究中有独特价值。Tianshou则以模块化设计著称,其Collector、Trainer、Policy的三层抽象使得不同组件的替换和组合极为灵活。在更贴近具身AI场景的层面,Robosuite为机器人操作任务提供了标准化的基准环境和评估协议,支持多种机械臂型号和操作任务,并提供了统一的任务难度分级体系;Hugging Face的LeRobot项目则雄心勃勃地试图为机器人学习建立类似Transformers库的统一生态,涵盖数据集标准、模型架构(包括基于扩散策略的Diffusion Policy和基于动作分块Transformer的ACT)和评估协议的全栈标准化。NVIDIA的OmniIsaacGymEnvs/Isaac Lab则提供了深度集成GPU并行仿真的完整训练管线,针对需要数百万环境步骤才能收敛的复杂运动控制任务尤为适合。SimRig的差异化定位在于其"轻量级"和"最小侵入性"——它不要求开发者迁移到特定的仿真引擎或训练框架,而是在现有工具之上提供一层薄薄的实验管理抽象,降低了采用门槛。
具身AI对标准化实验层的需求可能比其他AI子领域更为迫切,因为其实验流程涉及的组件链更长、每个组件的配置空间更大、调试成本也更高——一个人形机器人行走任务的完整实验配置可能涉及数十个物理参数、奖励权重和训练超参数的组合,如果缺乏统一的管理框架,实验的可复现性几乎无从保障。
从个人工具到社区共识
SimRig 目前仍处于早期探索阶段,作者本人也坦承"还在思考它应该做到多通用"。项目已在 GitHub 开源(Su1eym4n/simrig),欢迎感兴趣的具身智能开发者参与贡献。
无论 SimRig 最终能否成为具身AI领域的标准实验工具,它所提出的问题都极具价值:当一个领域中的每个人都在私下重复解决同一个基础设施问题时,或许正是社区应该坐下来共建统一标准的时候。回顾技术发展历程,几乎每一个成熟的工程领域都经历过从"各自为战"到"标准化工具链"的演进——Web开发有了React和Next.js,机器学习训练有了PyTorch Lightning和Weights & Biases,大语言模型微调有了Hugging Face生态。这些工具的成功有一个共同模式:它们都在社区痛点最集中、重复建设最严重的层面提供了一个足够薄、足够透明的抽象,让大多数人的80%的工作变得简单,同时不妨碍少数人对剩余20%的深度定制。具身AI领域正站在这一演进的关键节点上。
这一演进的成功与否,取决于社区能否就几个关键问题达成共识:实验层应该抽象到什么程度?是像PyTorch Lightning那样紧密绑定特定框架,还是像MLflow那样追求框架无关?对于仿真引擎的选择,应该押注单一平台还是支持多后端?奖励函数和任务定义的配置格式是否有可能标准化?这些问题没有简单的答案,但它们的讨论本身就是推动领域走向成熟的必要过程。值得参考的是,自然语言处理领域的标准化并非一蹴而就——Hugging Face生态的形成经历了数年的迭代,其成功在相当程度上依赖于BERT和GPT等少数标志性模型形成了足够强的引力中心,吸引整个社区围绕统一接口聚集。具身AI领域目前尚未出现这样强度的引力中心,但随着人形机器人商业化进程加速(Boston Dynamics、Figure AI、1X Technologies、宇树科技等公司的商业部署规模持续扩大),以及学术界对通用机器人操作能力的集中投入,这一引力中心的出现可能比预期更快。这些问题的答案将决定具身AI工具生态的走向。而SimRig的出现——以及它引发的社区讨论——至少表明,从业者已经强烈感受到了标准化的必要性。
对于正在具身智能赛道上探索的团队而言,与其继续积累各自的"脚本坟场",不如认真考虑构建或采用一个清晰的实验层——这可能是提升机器人强化学习研发效率最被低估的一笔投资。
核心要点
相关推荐

花旗14000名工程师用Devin,技术外包账单砍掉30%
花旗集团14000名工程师使用AI编程智能体Devin,一年内将技术供应商账单削减30%,产品发布提速30-40%。但30%仅限单一成本项,摩根大通同期表示AI收益尚未体现在财报中,揭示企业AI落地的真实分化。

AI写代码,程序员要失业?Devin自主编程真相
Devin等自主AI编程代理正改变软件开发:从Copilot辅助编码到全自动工程代理,程序员角色从写代码转向系统设计与监督。本文分析AI编程对就业、代码安全、初级开发者培养的影响,以及效率悖论下程序员需求的真实走向。

AGENTS.md 实战指南:让编程 Agent 真正好用
AGENTS.md 和 CLAUDE.md 能显著提升编程 Agent 表现,但研究发现用错反而让成本上升 20%。本文详解该写什么、该删什么、200 行与 32KB 的硬边界、Monorepo 嵌套规则及安全提醒。