SkillOpt:为AI智能体技能构建训练闭环
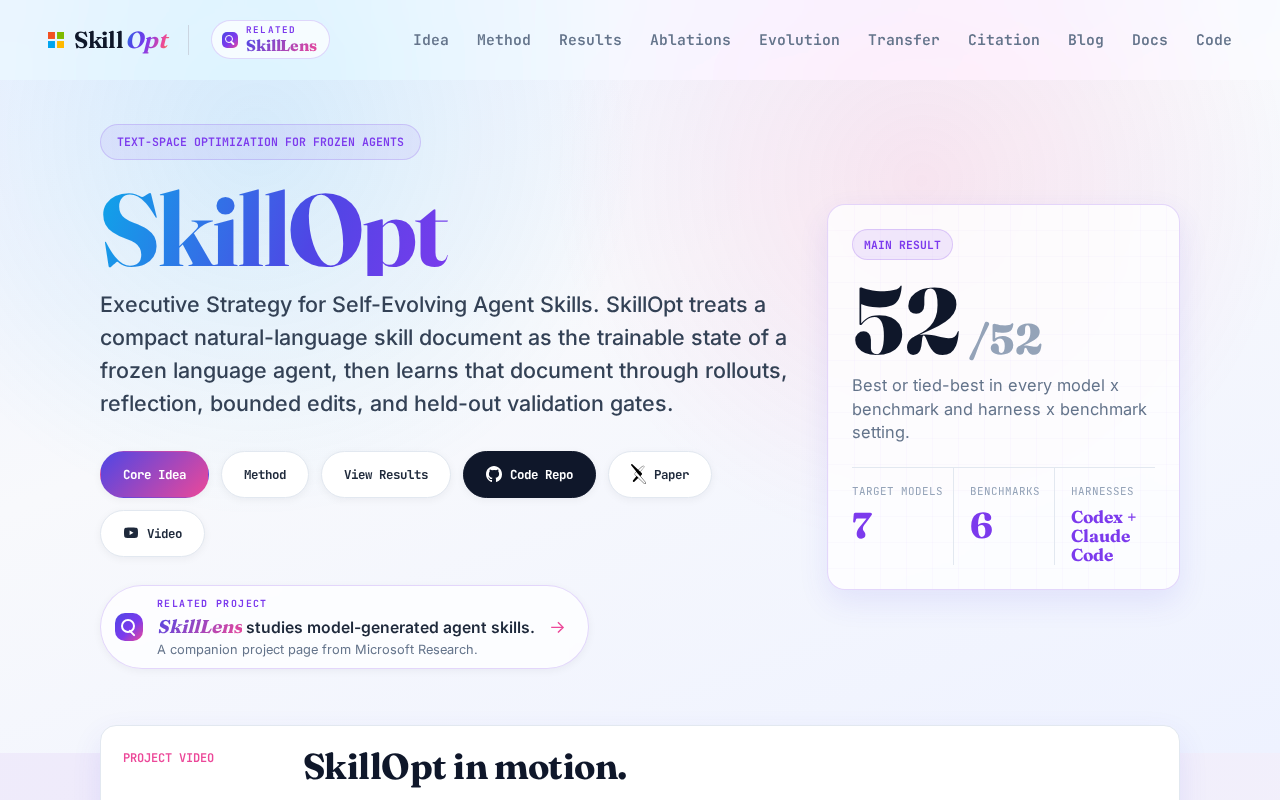
SkillOpt 将机器学习训练循环范式引入AI智能体技能优化,使Agent能力迭代变得可循环、可度量。
SkillOpt 是一个早期开源项目,核心理念是为 AI 智能体(Agent)的技能层建立类似机器学习的训练循环:定义任务、执行、评估、反馈、再迭代。它不微调底层模型权重,而是围绕技能的定义与调用方式进行优化,成本更低、迭代更快。这一思路契合当前 Agent 开发从"手工调提示词"走向"系统化工程优化"的行业趋势,与 DSPy、Agent Eval 等探索处于同一脉络,但更聚焦于"技能"这一粒度。目前该项目社区热度有限,落地案例不足,实际效果仍待验证,但其"把智能体优化做成可循环、可评估流程"的理念对构建持续迭代型 Agent 系统具有参考价值。
什么是 SkillOpt
SkillOpt 是近期在 Hacker News 上出现的一个开源项目,核心思路是为 AI 智能体(Agent)的技能(Skills)构建一套完整的训练循环(Training Loop)。随着大模型驱动的智能体逐渐从演示走向实际生产环境,如何让智能体的能力持续迭代、可度量地变强,成为一个越来越现实的问题。SkillOpt 尝试给出的答案是:把智能体技能的优化,做成一个类似机器学习训练那样的可循环、可评估的过程。
需要说明的是,该项目目前在社区中的讨论度还比较有限(Hacker News 上仅有个位数的投票与少量评论),本文主要基于其公开定位对这一方向的价值进行分析,具体实现细节仍需以项目官方文档为准。
智能体技能为什么需要“训练循环”
传统意义上的智能体开发,更多依赖工程师手工编写提示词(Prompt)、调整工具调用逻辑,然后凭经验判断效果好坏。这种方式在原型阶段足够,但一旦进入需要稳定表现的场景,问题就暴露出来:改动一处提示词可能在某些任务上变好、在另一些任务上变差,而开发者往往缺乏系统的反馈信号。
所谓“训练循环”,借鉴的正是机器学习里熟悉的范式——定义任务、执行、评估结果、根据反馈调整、再次执行。SkillOpt 把这套思路搬到了智能体技能层面:不是去微调底层模型权重,而是围绕技能的定义、调用与表现,建立起一个可以反复迭代优化的闭环。这种做法的好处在于成本更低、迭代更快,且不依赖对基础模型的重新训练。
这一思路的价值与定位
将智能体技能的优化“工程化”,本质上是在解决可复现性和可度量性的问题。当技能的每一次改动都能对应到一组评估指标上,团队就能像做单元测试和回归测试那样管理智能体的能力演进,而不是靠人肉试错。
这与当前智能体领域的一个大趋势相吻合:从“会用工具的聊天机器人”走向“能被持续调优的软件系统”。业界已有不少围绕 Agent 评估(Eval)、自动化提示优化的探索,SkillOpt 可以看作这一脉络下聚焦于“技能”这一粒度的尝试。它把技能当作可优化的第一类对象,理论上更贴合复杂智能体由多种技能组合而成的现实结构。
Agent 评估(Agent Eval)是近两年业界重点投入的方向。OpenAI、Anthropic 等机构以及 LangChain、LlamaIndex 等生态项目均在探索如何系统化地衡量智能体在多步骤任务中的表现。自动化提示优化领域也出现了 DSPy、TextGrad 等工具,尝试用程序化方式替代手工调提示词。SkillOpt 与这些工作的区别在于,它将"技能"作为独立的可优化单元进行封装,而不是把整个 Agent 作为一个黑盒来评测。这种粒度上的选择,理论上更便于在由多个技能模块组合而成的复杂 Agent 中定位性能瓶颈,也更贴近软件工程中"模块化测试"的思维方式。
现阶段的观察与保留意见
作为一个早期开源项目,SkillOpt 目前更多是提供了一种思路和框架雏形,社区反馈和实际落地案例都还较少。它是否能在真实、复杂的任务上带来可量化的提升,能否形成通用的评估标准,都有待更多验证。
对开发者而言,如果你正在构建需要持续迭代的智能体系统,这类“技能训练循环”的思路值得关注——即便不直接采用该项目,其背后“把智能体优化做成可循环、可评估的工程流程”的理念,也具有参考意义。建议对该方向感兴趣的读者关注项目后续的文档完善与实测数据。
小结
SkillOpt 代表了智能体开发从手工调试向系统化、可度量优化演进的一个缩影。它把机器学习的训练循环范式引入到 Agent 技能层面,方向具有前瞻性。不过就目前的社区热度和公开信息而言,它仍处于早期阶段,实际效果和成熟度需要时间和更多实践来检验。
背景补充
机器学习中的训练循环(Training Loop)通常包含四个环节:前向传播计算损失、反向传播计算梯度、参数更新、以及在验证集上评估效果。SkillOpt 借鉴这一结构,但将"参数更新"替换为对技能定义(如提示词模板、工具调用策略、上下文组织方式)的修改,将"损失函数"替换为面向任务的评估指标(如任务完成率、输出准确性、调用步骤数)。这种类比并非完美——智能体技能的搜索空间是离散且高维的,不存在梯度信号可以直接利用——但它提供了一套工程上可执行的组织框架,使团队能够以受控实验的方式推进优化,而非依靠个人经验和直觉。
相关推荐
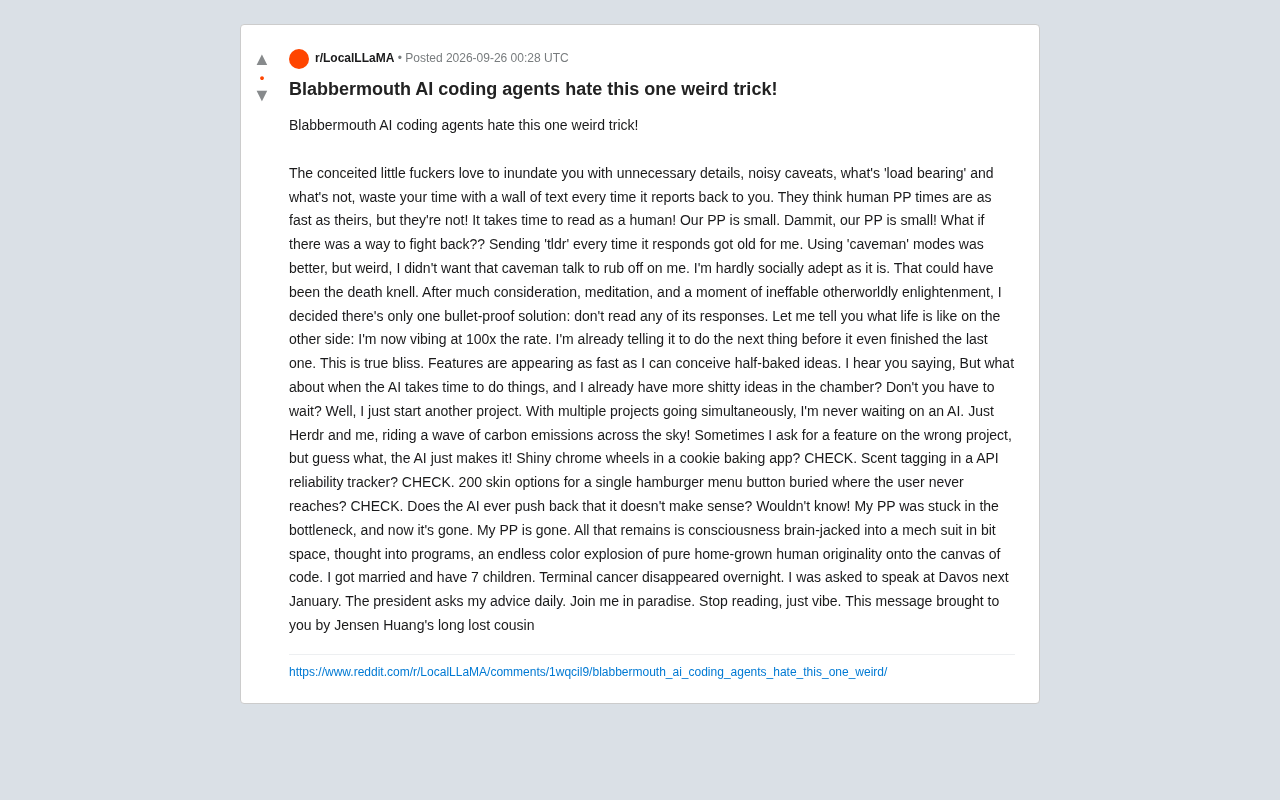
"别读AI的回复"?一篇讽刺帖背后的Vibe Coding隐忧
一篇Reddit爆款讽刺帖调侃AI编程助手太话痨,作者用"干脆不读回复"的荒诞方案暗讽vibe coding隐忧。本文解读段子背后关于信息过载、盲目信任AI输出与人工审查的真实问题。
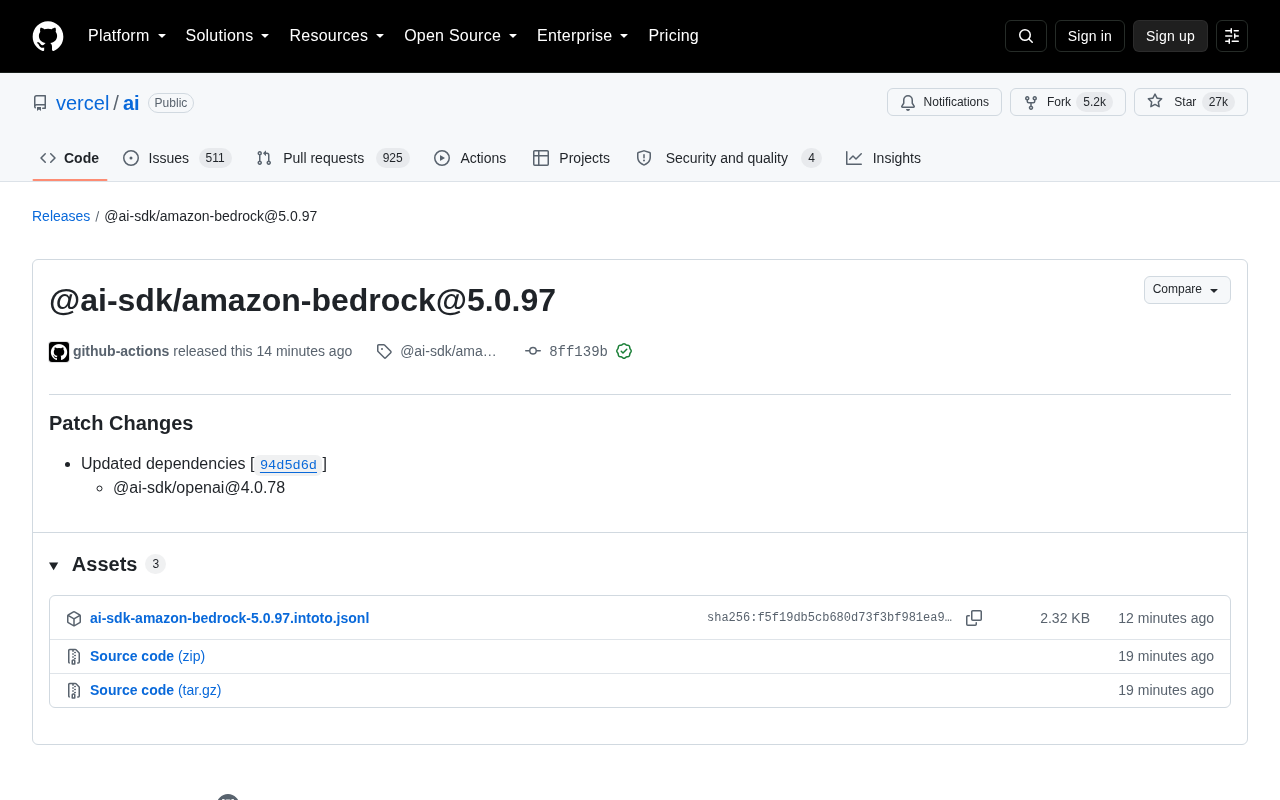
Vercel AI SDK 更新:Amazon Bedrock 5.0.97 发布
Vercel AI SDK 的 Amazon Bedrock 适配包更新至 5.0.97 版本,本次为补丁更新,主要同步依赖 @ai-sdk/openai 至 4.0.78。本文解读更新内容及对开发者的影响。
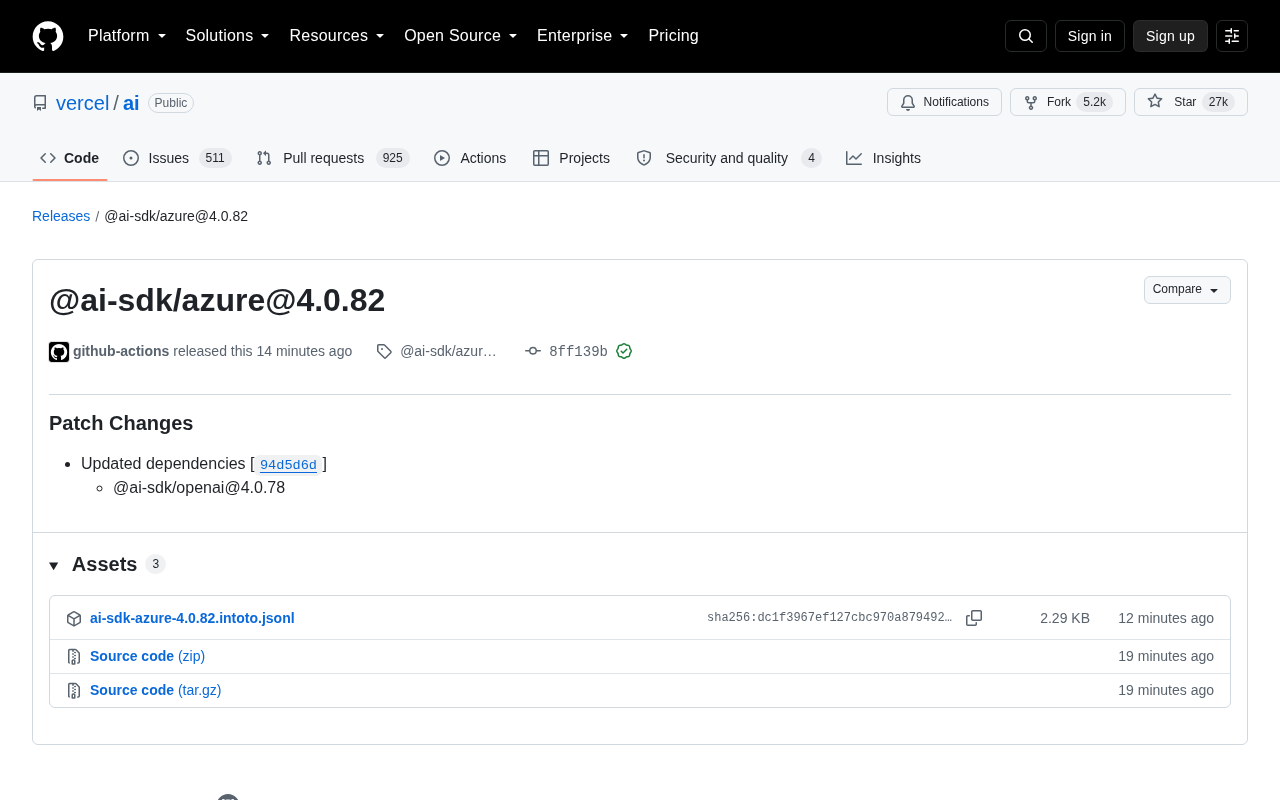
Vercel AI SDK 发布 @ai-sdk/azure 4.0.82 补丁更新
Vercel AI SDK 发布 @ai-sdk/azure 4.0.82 补丁更新,同步升级依赖至 @ai-sdk/openai 4.0.78。本文解读本次更新内容、Vercel AI SDK 生态及开发者应对建议。