SME空间记忆引擎:开源AI记忆插件夺长期记忆第一

独立开发者开源空间记忆引擎SME,盲评对战主流方案以96.7%拿下第一,并呈现越用越准特性。
SME(Spatial Memory Engine)是一款由独立开发者开源的AI长期记忆插件,旨在解决大模型「聊完就忘」的痛点。它以空间分区管理记忆、动态衰减淘汰低价值信息,并整合8种信号进行可解释检索。在作者自行设计的40道题、三组随机种子盲评中,SME以96.7%击败MEM0、GRAFFITY等五大主流方案位居第一,且同一对话回放三遍后准确率从92.5%升至95%,展现出越用越准的自我强化特性。工程层面,SME写入吞吐提升1.79倍、批量处理提升7.4倍、图检索速度快127至159倍,并支持双时间线建模与MCP协议接入。项目以Apache 2.0协议开源,但目前评测数据主要来自作者自测,仍需社区独立复现验证。
当下大模型最让人头疼的问题之一,就是「聊完就忘」——昨天说好的事,今天一问三不知。一位独立开发者选择用一己之力挑战这个难题,开源了名为 SME(Spatial Memory Engine,空间记忆引擎)的记忆插件,并在多方案盲评对战中拿下长期记忆插件第一名。本文梳理其核心机制、评测数据与工程表现。
让AI从「聊完就忘」到「越聊越懂你」
SME 的核心思路,是把 AI 的记忆当作一个可管理的「空间」来运营。作者用「大岛」式的分区管理来比喻——记忆被划分到不同空间分区,配合动态衰减机制,让久远、低价值的信息自然淡出,重要信息则被保留和强化。
检索层面,SME 引入了「近—离融合」的多信号策略,宣称整合了 8 种信号进行可解释检索。这意味着每一条被召回的记忆都有「来龙去脉」,而不是黑箱式地丢给模型一段上下文。可解释性在实际调试和信任建立上,往往比单纯的召回率更有价值。
盲评对战:96.7% 拿下第一
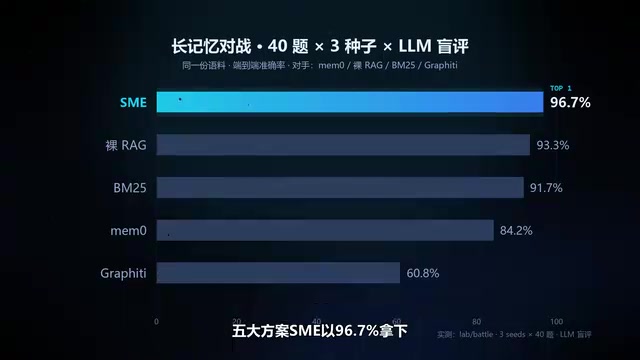
评测环节是这条视频最有说服力的部分。作者设计了 40 道题、三组随机种子,用大模型盲评的方式,让 SME 与 MEM0、GRAFFITY 等五大主流记忆方案正面对战。最终 SME 以 96.7% 的成绩位居第一。
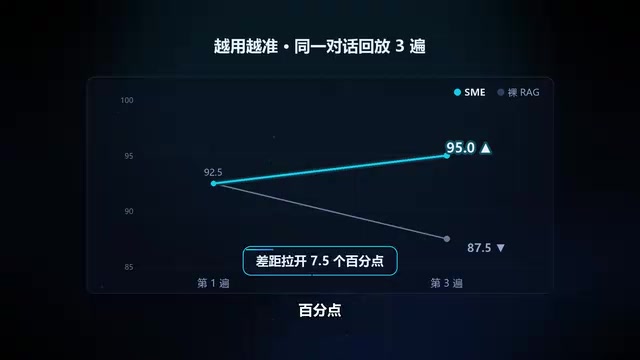
更值得关注的是「越用越准」这一特性。同一份对话回放三遍,SME 的表现从 92.5% 一路涨到 95%;而对照方案 LORAC 却从高位跌到 87.5%,两者最终拉开了整整 7.5 个百分点的差距。这组数据侧面说明,SME 的记忆整理机制在重复使用中能够自我强化,而非随着上下文膨胀而退化。
需要说明的是,这些数据均来自作者自行设计的评测,缺乏第三方独立复现,读者可以关注后续社区的实测反馈再做判断。
工程性能:读写与检索的显著加速
除了效果,SME 在工程指标上也给出了一组对比数字。据作者披露,SME 在写入吞吐上提升约 1.79 倍,批量介入提升 7.4 倍,图检索速度更是快了 127 到 159 倍。对于需要频繁读写记忆的智能体场景,这类性能差距会直接影响响应体验。
底层能力上,SME 支持 BITEMPRO 双时间线(bi-temporal)建模、PPR 图扩展等特性。双时间线意味着它能同时追踪「事件发生的时间」和「记忆被记录的时间」,这对处理时序敏感的对话尤为关键。
BITEMPRO 双时间线(bi-temporal)建模是数据库领域的经典概念,在记忆引擎中的应用尤为重要。传统系统只记录「记录时间」(transaction time),而双时间线额外维护「有效时间」(valid time),即事件在现实世界中实际发生的时间段。举例来说,用户可能在3月告诉AI「我上个月换了工作」,双时间线能同时标注「2月换工作」这一事实时间与「3月被记录」这一入库时间,从而在后续查询时正确处理「你换工作多久了」等时序问题,而不会混淆事件发生顺序与记忆写入顺序。PPR(Personalized PageRank)图扩展则是图数据库中的关联扩散算法,能从一个记忆节点出发,沿知识图谱的边按权重衰减地扩散到相关节点,帮助系统召回那些与查询间接相关、但对理解用户意图至关重要的背景记忆。
空闲自动整理与开箱即用的接入
SME 还内置了一型「空闲自动整理」机制——在系统空闲时自动梳理、融合和归档记忆,避免记忆库随时间无序膨胀。这一设计呼应了前面「越用越准」的表现。
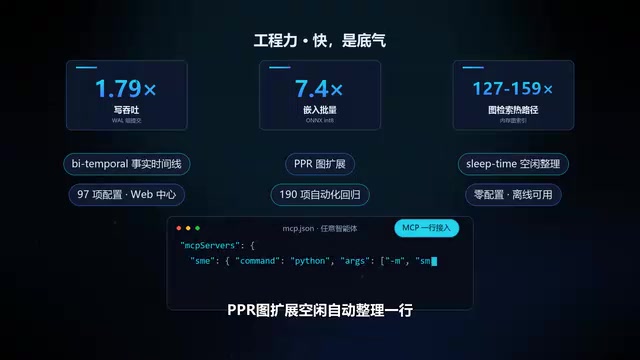
接入方式上,SME 通过 MCP(Model Context Protocol)协议对接任意智能体,理论上可以即插即用地为各类 Agent 添加长期记忆能力。项目采用 Apache 2.0 协议开源,并配备了 190 项自动化回归测试守护代码质量。感兴趣的开发者可以在 GitHub 搜索 Spatial Memory Engine 获取源码并自行实测。
MCP(Model Context Protocol)是 Anthropic 于2024年底提出并推动社区采纳的开放协议,旨在为大模型与外部工具、数据源之间提供标准化的上下文注入接口。它的核心思想类似于USB接口的统一规范:工具开发者只需按协议暴露能力,任何支持MCP的AI客户端(如 Claude Desktop、Cursor 等)无需额外适配即可调用。SME 选择以MCP作为接入层,意味着开发者无需为不同Agent框架分别编写集成代码,理论上能够大幅降低接入门槛。这也是近期越来越多记忆插件、搜索工具选择优先支持MCP的原因——生态兼容性已成为工具层竞争的重要砝码。
小结
SME 是一次典型的「独立开发者对抗大团队」的尝试。它在中文语境下的记忆检索、盲评评分、以及工程性能上都给出了亮眼的自评数据,尤其「越用越准」的特性颇具想象空间。当然,这些数据目前主要来自作者自测,真正的分量还需要社区大规模实测来验证。对于正在为智能体记忆问题苦恼的开发者,这是一个值得动手试一试的开源选项。
相关推荐

AI编程为何离不开Git?从版本回退到AI辅助命令全解析
Git是AI编程的必备工具。本文解析Git分布式版本控制在AI编程中的价值,包括应对AI幻觉的版本回退、分支管理等核心操作,以及如何用豆包、AI输入法等工具快速生成Git命令,帮助新手零基础入门。

拒绝AI胡编:一款"说不了谎"的求职信生成器是如何炼成的
一位开发者因AI求职信工具凭空捏造其Kubernetes经验和管理经历而屡遭拒信,于是打造了CoverCraft——通过代码计算评分、GitHub提交记录背书、对抗性审查与人工审批四重机制,构建一款"无法说谎"的AI求职信生成器。本文解析其对抗AI幻觉的工程设计。
Perplexity携手美国运通:为小企业主打造即用型AI技能库
Perplexity携手美国运通:为小企业主打造即用型AI技能库
Perplexity 联合美国运通推出面向小企业卡会员的即用型 AI 技能库,内置现金流预测、营销活动生成等预构建工作流,用户无需编写提示词即可让 AI 处理日常业务任务。