SoftCache:扩散Transformer的自适应步长缓存加速

SoftCache将缓存陈旧度信号的余量转化为连续步长调制,实现免训练、3.5至6.9倍加速且保真度领先。
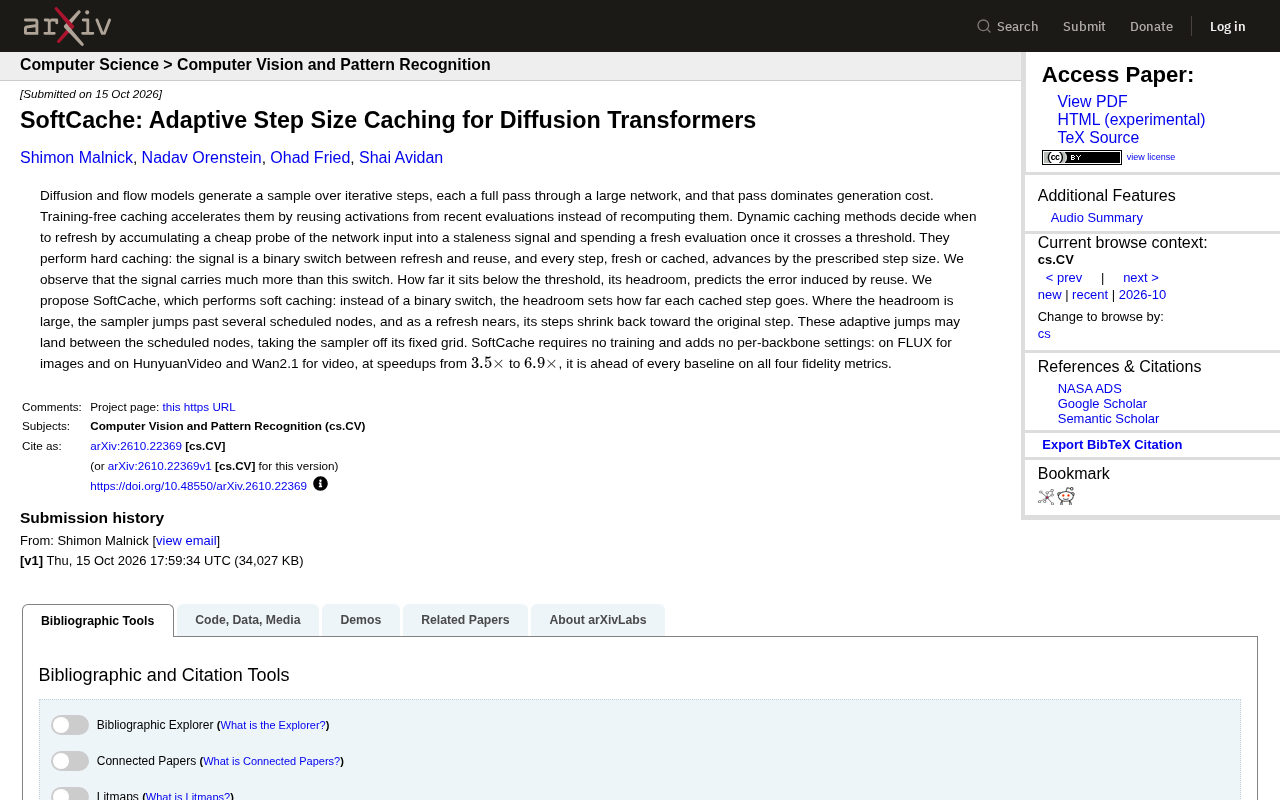
扩散模型和流模型因迭代步骤中完整前向传播大型网络而生成成本高昂,免训练缓存技术通过复用激活值来加速。传统动态缓存方法执行硬缓存:将廉价探针累积为陈旧度信号,越过阈值时刷新,否则复用,每一步都按预设步长推进。SoftCache观察到信号低于阈值的余量能预测复用误差,于是提出软缓存:让余量决定每个缓存步骤前进的距离。余量大时跳过多个预定节点,刷新临近时步长收缩回原始步长。该方法完全免训练,不增加针对特定骨干网络的参数,可直接应用于FLUX、HunyuanVideo和Wan2.1等扩散Transformer。实验显示,在3.5至6.9倍加速下,SoftCache在所有四项保真度指标上均领先基线,重新定义了缓存信号从二元触发到连续误差预测器的使用方式。
扩散模型和流模型通过迭代步骤生成样本,每一步都需要完整地前向传播一次大型网络,这一过程主导了生成成本。免训练缓存技术通过复用近期计算中的激活值来避免重复计算,从而加速生成。动态缓存方法通过将网络输入的廉价探针累积为陈旧度信号,当信号越过阈值时执行一次新的评估,以此决定何时刷新。这类方法执行的是硬缓存:信号是刷新与复用之间的二元开关,每一步——无论新鲜还是缓存——都按预设步长推进。
从硬缓存到软缓存
研究者观察到一个关键现象:陈旧度信号携带的信息远不止一个开关。信号低于阈值的程度——即其“余量”(headroom)——能够预测复用所引入的误差。基于这一洞察,他们提出了SoftCache,执行软缓存:不再使用二元开关,而是让余量决定每个缓存步骤前进的距离。当余量较大时,采样器跳过多个预定的节点;当刷新临近时,步长逐渐收缩回原始步长。
这种方法的核心创新在于将缓存决策从离散的二元选择转变为连续的步长调制。传统的硬缓存方法在每个步骤都遵循固定的时间表,而SoftCache允许自适应跳跃。这些自适应跳跃可能落在预定节点之间,使采样器偏离固定网格。这种灵活性正是加速的来源——在误差可控的区域内大步前进,在需要精度的区域回归细步。
陈旧度信号与余量的具体含义
在动态缓存方法中,网络输入的廉价探针通常指那些计算成本极低的中间特征或统计量,例如某些层的激活均值、输入与上一次刷新时输入的余弦相似度、或者时间步嵌入的差分范数。这些探针被累积成一个标量信号,用以衡量当前输入相对于上次完整前向传播时输入的“陈旧程度”。当该信号超过预设阈值时,说明复用旧激活值引入的误差可能过大,于是执行一次新的完整评估并重置信号。
“余量”(headroom)则定义为阈值与当前信号值之差。余量越大,意味着当前输入与上次刷新时的输入差异越小,复用旧激活值所引入的近似误差也越小;余量越小,则接近下一次刷新的临界点。SoftCache正是利用这一连续量来预测误差,而非仅仅判断是否越界。这种从二元触发到连续预测的转变,使得采样器可以在余量充裕时安全地跳过多个预定节点,从而获得更大的加速比。
免训练与免调参的设计
SoftCache的一个显著优势是完全免训练,并且不增加任何针对特定骨干网络的参数设置。这意味着它可以直接应用于不同的扩散Transformer架构,无需针对每个模型进行超参数调整。论文在多个主流模型上验证了该方法的通用性:图像生成领域的FLUX,以及视频生成领域的HunyuanVideo和Wan2.1。
这种即插即用的特性对于实际部署尤为重要。当前扩散模型的推理成本仍然是应用落地的核心瓶颈之一,尤其是在视频生成场景中,迭代步骤多、网络规模大,生成一段视频的算力开销相当可观。免训练缓存方法不需要额外的微调或蒸馏过程,能够直接叠加在现有推理流程上。
扩散Transformer架构的通用性
扩散Transformer(DiT)将传统扩散模型中的U-Net骨干替换为纯Transformer结构,以处理图像或视频的潜在表示。由于Transformer对序列建模的灵活性,DiT已成为当前高质量生成模型的主流架构,例如FLUX、HunyuanVideo和Wan2.1均采用此类设计。然而,不同DiT在层数、隐藏维度、注意力机制和训练数据上的差异,导致其激活值分布和误差敏感度各不相同。
SoftCache的免训练特性意味着它不需要针对每个DiT重新训练一个误差预测器或微调缓存策略。其核心机制——利用陈旧度信号的余量来调制步长——仅依赖于信号本身与误差之间的经验相关性,而不依赖于特定网络的权重或结构。因此,同一套阈值和步长映射规则可以直接迁移到不同规模的DiT上,仅需极少的通用超参数(如最大跳跃步数)即可工作。这显著降低了在实际部署中适配新模型的工程成本。
速度与保真度的平衡
实验结果显示,在3.5倍到6.9倍的速度提升下,SoftCache在所有四项保真度指标上均领先于所有基线方法。这一结果值得关注,因为缓存加速方法通常面临速度与质量之间的权衡——加速倍数越高,生成质量下降越明显。SoftCache在显著加速的同时保持甚至提升保真度,说明自适应步长策略比固定步长的缓存刷新更符合扩散过程的实际误差分布。
速度提升的具体数值因模型和任务而异:FLUX上的加速比与视频模型上的加速比有所不同,但整体落在3.5倍至6.9倍的区间内。对于视频生成而言,这一加速比意味着原本需要数分钟的生成过程可以缩短到数十秒级别,对交互式应用和批量生成场景都有实际意义。
对缓存策略的重新思考
SoftCache的意义不仅在于具体的加速效果,更在于它重新审视了缓存信号的使用方式。以往的工作将陈旧度信号视为一个触发条件——要么刷新,要么复用。SoftCache则将其视为一个连续的误差预测器,信号的大小本身包含了关于当前近似质量的信息。
这种思路的转变打开了新的优化空间。如果余量能够预测误差,那么理论上可以进一步细粒度地控制缓存行为——例如根据余量动态调整多个缓存步骤的步长分配,或者结合其他误差指标进行更精确的调度。论文展示的自适应跳跃和步长收缩机制只是这一思路的一个实现,后续研究可能会在此基础上发展出更丰富的缓存策略。
从工程角度看,SoftCache不依赖训练的特性使其易于集成到现有的扩散模型推理管线中。对于需要在有限算力下部署高质量生成模型的应用场景,这类免训练加速方法提供了一条务实的路径。
误差预测器与调度策略的关系
将陈旧度信号视为连续的误差预测器,本质上是在构建一个廉价的代理模型,用以估计当前复用激活值所引入的生成误差。这一思路与自适应步长求解器(如DPM-Solver中的自适应阶数调整)有相似之处,但关键区别在于:自适应求解器通常需要计算局部截断误差,而SoftCache仅依赖输入探针的累积信号,计算开销几乎可以忽略。
这种代理误差信号为更细粒度的调度提供了可能。例如,可以设计一个步长分配函数,使得在余量大的区域连续跳跃多个节点,而在余量中等时仅跳跃一个节点,在余量接近零时回归原始步长。进一步地,还可以将余量与多个缓存步骤的误差累积联系起来,实现全局最优的跳跃序列规划。论文展示的自适应跳跃和步长收缩只是这一框架的初步实现,未来可探索更复杂的映射函数或结合其他轻量级误差指标,以在更高加速比下维持生成质量。
相关推荐
LLM应用越改越糟?三步构建有效评估体系
LLM应用迭代时如何判断变好还是变坏?本文基于Reddit开发者讨论,详解构建测试集、自动化回归评估、LLM-as-judge评分与结构化追踪智能体行为,建立从生产反馈到评估追踪的持续闭环。
瑞典政府封杀ChatGPT与Claude:AI工具治理的转折点
瑞典政府宣布禁止在员工电脑上使用ChatGPT和Claude,出于信息安全考虑。本文分析禁令细节、数据主权焦虑及对AI行业的影响。
苹果复活初代iPod:Apple Music隐藏彩蛋深度体验
苹果在Apple Music的404页面埋藏了初代iPod虚拟彩蛋,预置2000年代早期歌曲,引发社交传播。本文解析彩蛋位置、发现过程与怀旧营销背后的产品逻辑。