SoL-Pi 实战:Pi Agent 自动研究循环与 Regolo 配置全攻略

SoL-Pi 通过优化 Agent 上下文管理机制并配合对照实验,量化验证了 AI 编程智能体的 Token 降本效果。
本文基于实战教程,介绍了 SoL-Pi(SOPI)这套面向 Pi Agent 的 Token 成本优化方案的完整落地流程。文章从 Node.js、Regolo API 密钥、Git 三大前置条件出发,重点讲解了密钥安全管理(环境变量、一项目一密钥)、模型映射配置,以及冒烟测试的必要性。核心方法论是「同一任务跑两遍」的对照实验:用自动化脚本分别以标准配置和优化配置执行相同编码任务,通过实时日志追踪各阶段 Token 消耗,最终数据并排对比证明优化分支消耗明显更少。文章同时给出了 API 密钥权限与 Node 版本两个优先排查方向,强调降低 AI 编程成本需依赖可复现的实验与完整日志,而非主观判断。
SoL-Pi 实战:Pi Agent 自动研究循环与 Regolo 配置全攻略
AI 编程智能体的 Token 消耗,往往是实际使用成本中最容易被忽视、也最难控制的部分。SoL-Pi(教程中口述为 SOPI)给出了一套可量化的解决思路:通过优化智能体的上下文管理与模型交互机制,在完成同样编码任务的前提下,显著压缩 Token 用量。本文基于 B 站 UP 主的实战教程,梳理从环境搭建、Regolo 密钥配置到成本对比研究的完整流程。
为什么要关注 Agent 的 Token 成本
当一个编程智能体自动处理代码库时,它需要反复读取文件、组织结构、执行重构逻辑,每一次与模型的交互都在消耗 Token。任务越复杂,上下文窗口占用越高,调用次数越多,成本也随之水涨船高。
SoL-Pi 的核心价值正在于此——它为 Pi Agent 提供一套专用机制,优化智能体与模型之间的通信方式,减少不必要的调用开销。教程作者强调,这套方法的意义不是空谈优化,而是通过同一任务跑两遍(标准配置 vs 优化配置)的对照实验,用实际数据量化节省效果。
Token 是大语言模型处理文本的基本计量单位,通常一个英文单词约对应 1-2 个 Token,中文字符则约为 1.5-2 个 Token。模型服务商(如 OpenAI、Anthropic)按输入与输出的 Token 总量收费,而编程智能体的特殊性在于:它不仅要读取用户指令,还要将整个代码文件、函数依赖、历史对话全部塞入「上下文窗口」一并发送给模型。这意味着一次看似简单的重构操作,实际可能触发数十次 API 调用,每次都携带着膨胀的上下文,累计 Token 消耗可能达到手动编码的数倍乃至数十倍。上下文窗口越大(如 128K Token),单次调用成本越高;任务越迭代,历史信息堆积越快。这也是为什么「管理上下文」而非单纯「减少调用次数」成为降本的关键——有效压缩每次交互携带的冗余信息,才是根本解法。
环境准备:三大前置条件
在动手之前,需要确认三个基础条件已经就绪:
- Node.js:必须使用当前稳定版本。过时的环境极易在安装阶段触发依赖冲突,建议先在终端检查版本号。
- Regolo API 密钥:这是智能体与模型提供商通信的凭证。
- Git:用于克隆 SoL-Pi 仓库及相关框架。
作者特别提醒,安装命令和配置标志应以官方仓库文档为准,而不是凭记忆照搬。参考最新文档能避免因标志变更导致的排查成本。执行安装命令后,系统会拉取核心库并构建本地工作区,此时需密切留意进度条和任何依赖错误,必要时先更新包管理器。
Regolo 密钥配置:安全优先
密钥管理是整个流程中容易被草率处理、却关系到账户安全的关键环节。教程给出的做法值得专业开发者借鉴:
使用环境变量,拒绝硬编码
将 API 密钥导出为环境变量,而非直接写入源文件。这能从根本上防止敏感凭证被意外提交到仓库历史中。
环境变量是操作系统级别的键值对存储机制,程序运行时可通过 process.env.变量名(Node.js)等方式读取,而该值不会出现在源代码中。在实践中,开发者通常将密钥写入 .env 文件并将其加入 .gitignore,或直接在终端通过 export API_KEY=xxx 命令设置会话级变量。这样做的核心好处是「密钥与代码解耦」:即便代码库被公开或意外泄露,攻击者也无法直接获取有效凭证。相较之下,硬编码密钥一旦被推送到 GitHub 等平台,自动扫描机器人往往能在数分钟内检测到并滥用,造成账单暴增或数据泄露。对于团队协作场景,环境变量还能配合 Vault、AWS Secrets Manager 等密钥管理服务实现集中治理和自动轮换。
为每个 Agent 实例生成专用虚拟密钥
前往 Regolo 控制面板,专门为当前 Agent 实例生成一个唯一的虚拟密钥。这种「一项目一密钥」的做法带来两个好处:
- 精细审计:可以追踪每个密钥对应的使用情况;
- 可撤销性:当某个 Agent 出现问题时,能单独撤销其访问权限,而不影响其他项目。
生成后复制密钥,保存到安全的环境管理器中,切勿以纯文本形式散落在文件系统里。
模型映射与配置文件
拿到密钥后,需要根据文档把 API 密钥映射到特定模型配置,引导 Agent 使用正确的基础设施。更新本地模型配置文件、填入新凭证后,务必运行模型验证命令,确认认证握手成功、模型设置已正确应用。
接下来克隆 SoL-Pi 仓库并运行安装脚本,安装框架依赖。这个工具是整个效率测试的核心引擎,安装时要确认没有「缺失库」的警告,所有底层组件都正确链接到现有的 Pi Agent 安装中。
配置文件(Profile)是 Agent 的运行基线,定义它如何处理代码与内存。作者反复强调「干净的配置文件是稳定性能的秘诀」——路径中哪怕一个拼写错误,都可能让 Agent 无法访问必要工具。
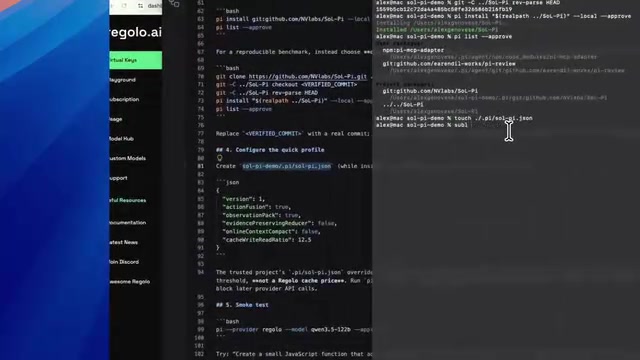
完成配置后先做一次冒烟测试(smoke test),用提供者命令快速验证模型连接是否稳定。确认终端输出显示稳定连接,再进入正式的成本研究阶段,可以避免在失败的初始化尝试上白白浪费 Token。
成本研究:同一任务跑两遍
成本研究的方法论很直接:运行相同的编码任务两次,一次用标准性能设置,一次用优化后的设置,从而量化 SoL-Pi 的实际影响。
启动成本研究脚本后,它会自动执行预先验证好的编码任务,无需人工干预,从而收集干净、可对比的 Token 消耗数据,排除了手动操作带来的人为误差。
分阶段观察 Agent 行为
实时日志会追踪每一次 API 交互,整个任务被拆分为多个阶段逐步执行:
- 智能体先浏览代码库,决定何时触发特定优化函数;
- 在重构阶段组织代码结构,同时记录 Token 消耗,展示它如何管理上下文窗口;
- 在复杂逻辑执行阶段,跟踪优化机制是否成功减少开销;
- 后续阶段中,性能指标保持稳定,日志清晰显示出交互模式的变化。
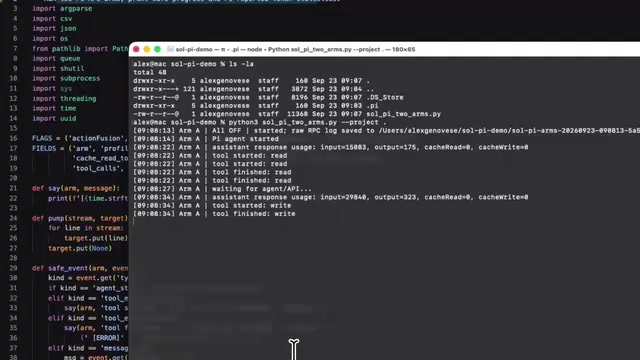
作者指出,与未优化的基线相比,Agent 处理 Token 需求的方式出现了明显变化,这正是配置生效的直接证据。
「对照实验」是科学方法论的基础——通过控制除被测变量之外的所有条件,隔离出单一因素的实际影响。在 Token 成本研究中,「同一任务跑两遍」的设计确保了两次运行在任务内容、代码库状态、模型版本上完全一致,唯一变量是 SoL-Pi 的优化配置是否启用。这种方法能有效排除「任务本身复杂度不同」或「模型版本差异」对结果的干扰。自动化执行脚本进一步消除了人工操作速度、提示措辞等人为误差,使数据具备可重现性——同一团队在不同时间运行应得到接近的结论。这也意味着该方法可以被其他团队复制验证,是建立 Token 成本基线、评估任何上下文优化策略的通用范式,而非仅限于 SoL-Pi 场景。
数据分析与结论
任务全部执行完毕后,打开结果文件进行并排对比。数据汇总了来自两个分支(标准 vs 优化)的 Token 数量。
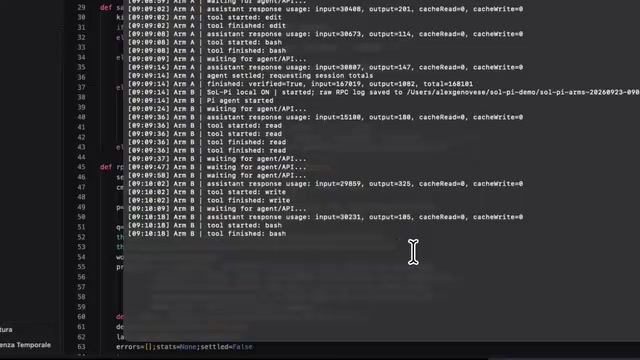
结果证实:优化后的分支完成同样任务所需的 Token 明显更少,直接验证了 SoL-Pi 方法的实际价值。最后再核对一遍终端日志,确认数据完整无误,整个工作流即告闭环。
常见问题排查
如果在过程中遇到错误,教程给出两个优先排查方向:
- 检查 API 密钥权限:确认虚拟密钥具备运行编码任务所需的特定权限;
- 验证 Node 版本:核对是否与官方文档要求一致。
这套流程的最大启示在于——降低 AI 编程成本不是靠感觉,而是靠可复现的对照实验和完整的日志记录。对于长期使用智能体辅助开发的团队来说,建立这样一套 Token 成本基线,是精细化控制支出的第一步。
相关推荐

@ai-sdk/workflow-harness 1.0.146 发布说明
@ai-sdk/workflow-harness 1.0.146 为补丁级别更新,依赖 @ai-sdk/harness 同步升级至 1.0.146,由 GitHub Actions 自动发布并经验证签名。

ICANN新顶级域名争夺战:Meta与OpenAI抢注.agent和.agi
ICANN放出1600份新顶级域名申请,Meta与OpenAI争夺.agent和.agi后缀;同时GTA VI发售倒计时泄露不断,Joe Rogan与Spotify达成约2.5亿美元续约。一文看懂科技圈头部资产争夺战。

MCP协议详解:20行代码搭建你的AI工具服务器
MCP(模型上下文协议)是连接 AI 应用与外部工具的通用标准,被称为「AI 界的 USB-C」。本文详解 MCP 的架构原理、无状态协议升级,并手把手教你用不到 20 行代码搭建自己的 MCP 服务器,附安全实践建议。