SoloBooks AI:本地优先的财务助手如何解决自由职业者隐私痛点

SoloBooks AI用本地开源模型与SQLite实现隐私优先、零边际成本的独立开发者记账工具。
SoloBooks AI 是一款面向自由职业者与独立开发者的开源财务工具,核心主张是把 AI 推理和财务数据全部留在本地,避免将发票、税号和银行流水上传至第三方云端,同时规避每月 30 至 60 美元的 SaaS 订阅成本。技术上前端采用 Next.js 16 与 React 19,数据层用 SQLite 并以整数最小单位存储金额以消除浮点误差;文档处理以 Tesseract.js OCR 与 PDF-Parse 双轨并行,AI 抽取通过本地 Ollama 调用 llama3 或 qwen2.5:3b。为防止幻觉,系统用 Zod schema 严格校验模型输出,并强制用户在写入数据库前逐项审核。AI 助手回答问题前先执行确定性 SQL 查询,模型只负责解释。作者同时诚实披露了显存、延迟与首次联网部署等局限。
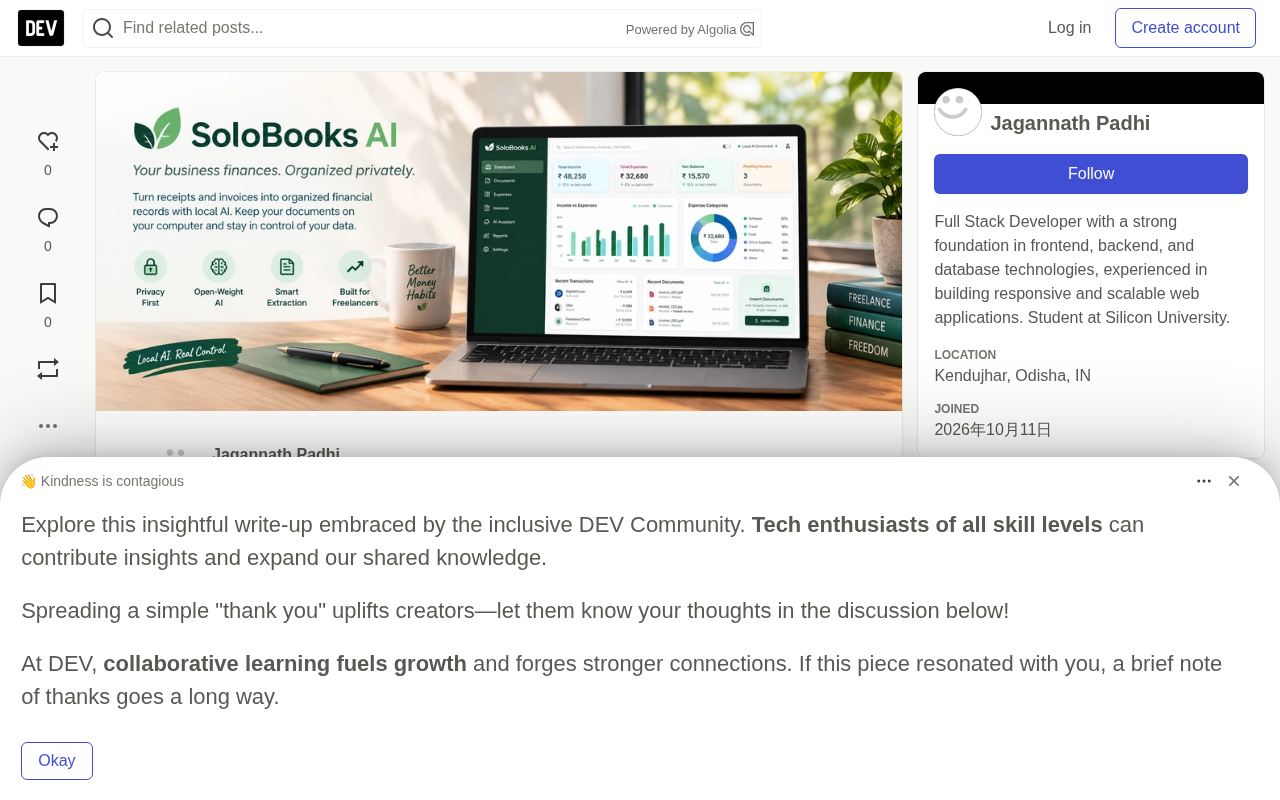
自由职业者和独立开发者长期面临一个两难选择:要么用Excel手动记账,忍受低效;要么订阅每月30-60美元的会计SaaS,把敏感的客户发票、税率和银行流水全部上传到第三方云端。SoloBooks AI试图用本地开源模型打破这个僵局——所有财务文档不离开用户自己的硬盘。
一个被忽视的隐私缺口
SoloBooks AI的作者在Hacktoberfest开源AI挑战赛中指出了传统会计工具的两个核心问题。第一是数据安全:商业工具强制要求将私人银行发票、税号和保密客户费率上传至第三方服务器和专有AI API。第二是成本结构不合理:单体式会计套件月费在30到60美元之间,大量企业级功能对单人经营者来说根本用不上。
这个痛点并非小众。自由开发者、创意工作室、家教和小企业主构成了庞大的长尾市场,他们的财务文档格式碎片化——PDF发票、PNG收据、JPEG照片混杂——但数据敏感度却极高。
技术架构:把AI关进本地盒子
SoloBooks AI的架构设计围绕一个原则展开:推理和存储都留在本地。前端使用Next.js 16 App Router配合React 19和TypeScript严格模式,Tailwind CSS v4定制了森林绿(#059669)与深祖母绿(#10b981)的设计系统。图表由Recharts渲染,按月现金流柱状图和分类支出饼图均为客户端计算。
数据层采用SQLite,通过@libsql/client管理,实现了跨平台的零原生构建嵌入式数据库。一个值得注意的工程细节是:所有货币金额以整数最小单位存储(如₹45,000.00存为4500000派萨,$49.99存为4999美分),从根本上消除了浮点精度漂移。上传的收据经过15MB大小限制、MIME类型白名单和路径遍历剥离校验后,以随机UUID命名存入./data/documents/目录,数据库中只记录相对路径。
文档处理采用双轨策略:Tesseract.js v7负责扫描件和照片的OCR,纯JavaScript和WebAssembly实现,在后台worker中运行,不依赖C++系统二进制;PDF-Parse则直接提取数字发票的原生文本流,跳过OCR延迟。
Zod 与运行时 schema 校验的意义
TypeScript 的类型系统只在编译期生效,编译产物运行时不携带任何类型信息,因此来自外部(此处即语言模型)的数据在运行时是完全不可信的。Zod 是一个运行时校验库:开发者用链式 API 声明一个 schema,运行时即可对任意输入执行 parse,不匹配时抛出结构化错误。
在 LLM 抽取场景中,这层校验尤为关键。模型可能返回多余字段、把数字写成带货币符号的字符串、或省略日期。Zod 配合 .nullable() 与 .catch() 可以把异常输入归一为 null,而不是让脏数据写入数据库。相较手写 if 判断,schema 还能从定义自动推导出 TypeScript 类型,保证校验逻辑与类型声明不会分叉。
本地模型集成与防幻觉设计
AI提取环节通过Ollama本地API(127.0.0.1:11434)完成。作者验证了两个模型:llama3:latest(8.03B参数,Meta Llama 3社区许可)和qwen2.5:3b(3.09B参数,Apache 2.0许可,面向8GB内存笔记本)。
这里有几个值得借鉴的工程决策。提取提示强制使用JSON格式,原始响应通过严格的Zod schema(ExtractedLlmSchema)校验,缺失字段保留为null而非让模型编造日期或发票号。文档文本被包裹在<document_text>分隔块中,并附带明确的系统指令要求忽略发票内嵌的提示注入尝试。AI通信被抽象在通用的ModelAdapter接口之后(src/lib/ai/adapter.ts),模型可以无缝替换,测试中也能自动mock。
最关键的是"人在回路"设计:AI提取结果严格视为草稿提案,用户必须逐项审核、编辑并确认后才会写入SQLite。财务数字的正确性最终由确定性计算引擎保障,而非语言模型。
Ollama 与本地推理的运作方式
Ollama 是一个开源的大模型本地运行框架,它把模型权重的下载、量化、加载和推理服务打包成单一守护进程,在默认端口 11434 上暴露与 OpenAI 风格相近的 HTTP 接口。应用只需向 127.0.0.1:11434 发起请求即可调用模型,无需任何云端凭证,也不产生按 token 计费。
其关键机制是模型量化:权重从 16 位浮点压缩到 4 位整数(Q4 系列),使 3B 参数模型体积降至 1.9GB 左右,从而能在普通笔记本内存中加载。代价是精度轻微下降,但对结构化信息抽取这类任务通常足够。需要注意,Ollama 本身不负责数据持久化与安全边界,它信任本机调用方——因此应用层仍需自行做输入清洗、提示注入隔离和输出校验,这正是本文所述 Zod schema 与 `
接地气的AI财务助手
SoloBooks AI内置的问答助手回答诸如"这个月我在软件上花了多少?"这类问题时,并不是让模型凭空生成数字。系统执行确定性的SQL查询,然后将验证过的交易卡片与叙述性摘要一起呈现。这种"接地"(grounded)方式把语言模型限制在解释层,金额计算交给数据库。
测试套件运行在Vitest上,17个测试全部通过,覆盖最小单位算术、文档安全、schema校验、重复检测、发票状态流转和真实Ollama连通性。
开源创新的三重价值与诚实的局限
作者对开放创新的论证聚焦在三点。数据主权:模型本地运行时,客户名单、时薪和税务抵扣永远不离开设备。零边际推理成本:权重下载后,分析10张还是10000张收据的API成本都是零。摆脱供应商锁定:Apache 2.0许可的开源权重模型不受任意涨价、弃用通知或API条款突变的影响。
但文章也没有回避代价。模型权重要占1.9GB(3B)到4.7GB(8B)磁盘空间,3B模型需至少8GB内存,8B模型需16GB内存或独立显存。纯CPU硬件上OCR加推理每份文档可能耗时5到15秒。首次部署仍需联网下载Ollama和模型权重,尽管作者亲自验证了断网后仪表盘服务、PDF文本处理、SQLite查询、确定性总额计算和RFC 4180 CSV导出全部正常工作。
商业模式与一个务实的取舍
当前开源核心包含无限本地OCR与PDF提取、Ollama集成与schema校验、费用与发票跟踪、接地AI助手以及CSV/JSON导出。规划中的Pro层包括银行流水CSV智能映射、最多50份文档的批量队列处理、密码加密的本地备份快照、基于Tauri的单二进制桌面打包,目标定价为每月₹499(约6美元)。作者明确标注支付和订阅功能仅为提案,未虚假实现——这在黑客松提交中是一种难得的诚实。
SoloBooks AI的意义不在于功能有多全面,而在于它演示了一条路径:本地开源权重模型足以支撑隐私优先、零边际成本的财务工具。对于处理敏感客户数据的独立从业者来说,把AI推理留在自己的机器上,可能比任何云端功能都更有说服力。
相关推荐

花旗14000名工程师用Devin,技术外包账单砍掉30%
花旗集团14000名工程师使用AI编程智能体Devin,一年内将技术供应商账单削减30%,产品发布提速30-40%。但30%仅限单一成本项,摩根大通同期表示AI收益尚未体现在财报中,揭示企业AI落地的真实分化。

AI写代码,程序员要失业?Devin自主编程真相
Devin等自主AI编程代理正改变软件开发:从Copilot辅助编码到全自动工程代理,程序员角色从写代码转向系统设计与监督。本文分析AI编程对就业、代码安全、初级开发者培养的影响,以及效率悖论下程序员需求的真实走向。

AGENTS.md 实战指南:让编程 Agent 真正好用
AGENTS.md 和 CLAUDE.md 能显著提升编程 Agent 表现,但研究发现用错反而让成本上升 20%。本文详解该写什么、该删什么、200 行与 32KB 的硬边界、Monorepo 嵌套规则及安全提醒。