SOP-Bench:评估AI智能体处理真实业务流程的新基准
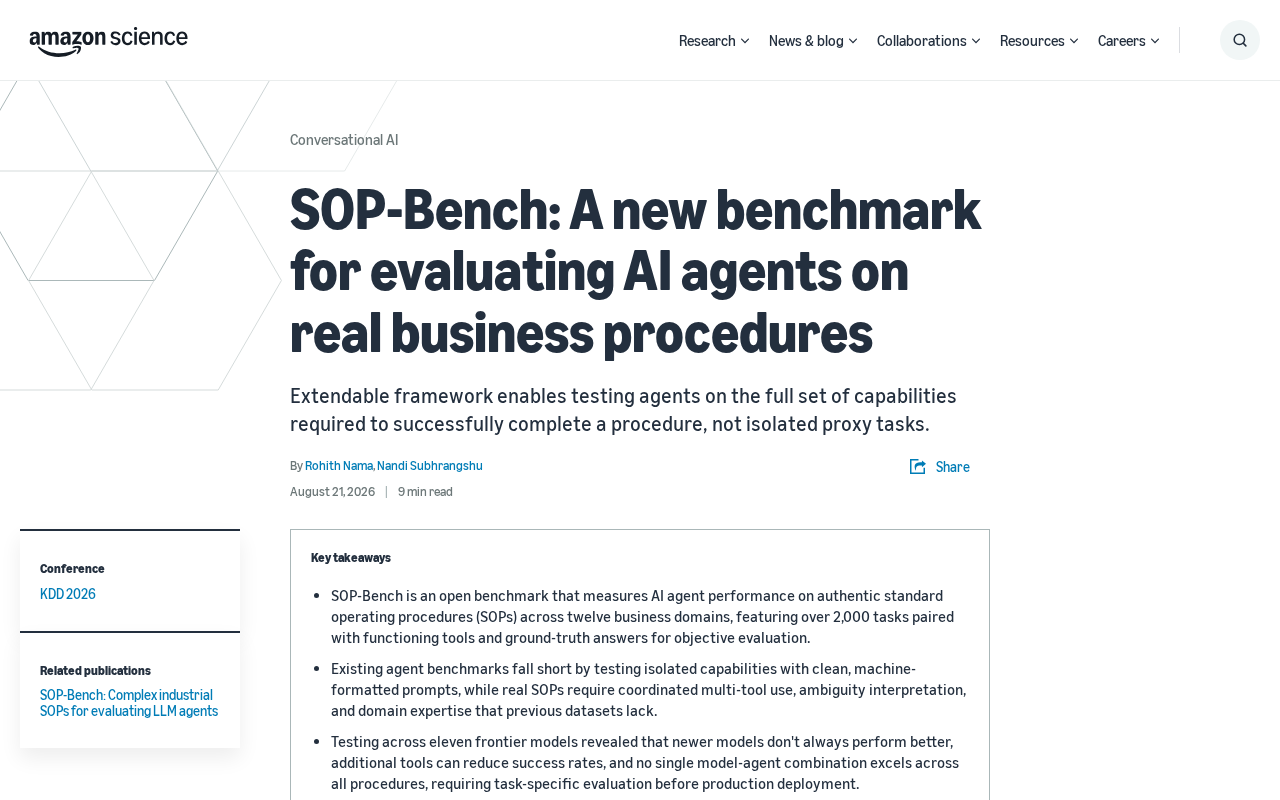
SOP-Bench以完整业务流程为单元评估AI智能体,填补了现有基准只测单点能力的空白。
SOP-Bench是一个面向真实企业业务流程的AI智能体评估基准,旨在解决现有评测方法过度依赖孤立代理任务、无法衡量端到端执行能力的问题。与WebArena、ToolBench等主流基准不同,SOP-Bench围绕完整的标准作业程序(SOP)构建测试场景,要求智能体在多步骤、跨系统的流程中持续追踪状态、保持上下文一致性并处理异常情况。该框架同时具备可扩展性,支持接入新业务流程或企业自定义场景。这一方向标志着AI Agent评估范式的重要转变:从测量模型"懂不懂某个技能",转向测量智能体"能否把一件真实的事情从头做到尾"。
SOP-Bench 想解决什么问题
当前评估 AI 智能体(AI Agent)的方法大多依赖孤立的代理任务(proxy task),比如单步问答、简单工具调用或封闭沙盒中的操作。这类测试能反映模型的部分能力,却无法回答一个更关键的问题:当一个智能体被投入到真实的企业业务流程中,它能否从头到尾完成一整套标准作业程序(Standard Operating Procedure, SOP)?
SOP-Bench 正是针对这一空白提出的新基准。它的核心思路是:不再用碎片化的任务去近似真实工作,而是围绕完整的业务流程来评估智能体,测量其在整个流程链条中所需的全部能力,而非某个单一环节的表现。
标准作业程序(SOP)是企业运营中对特定业务流程的规范化描述,通常包含明确的执行步骤、判断条件、异常处理路径和验收标准。在客服、财务审批、IT运维、供应链管理等领域,SOP是保证业务一致性和合规性的核心工具。将AI智能体引入SOP执行场景,意味着Agent需要理解自然语言描述的流程规则、在多轮交互中维持执行状态、并在遇到例外情况时做出符合业务逻辑的判断——这远比回答一道问答题或调用一次API复杂得多。
从「孤立任务」到「完整流程」的转变
真实的企业作业程序往往由多个相互依赖的步骤组成:读取信息、调用不同系统、做出判断、处理异常、验证结果、再进入下一步。任何一个环节的失误都可能导致整个流程失败。传统基准把这些环节拆开单独考核,容易高估智能体的实际可用性——一个模型可能在每个孤立子任务上都表现不错,却无法把它们串联成一个可靠的端到端执行链。
SOP-Bench 强调「full set of capabilities」,即完成一个流程所需的全套能力,包括对流程状态的持续追踪、跨步骤的上下文保持、以及在长链条中保持一致性的能力。这种评估视角更贴近企业部署智能体时真正关心的指标:这个 Agent 到底能不能把活儿干完。
当前主流的AI Agent基准,如WebArena(网页操作)、ToolBench(工具调用)和AgentBench(多环境综合),通常以单次任务成功率作为核心指标,且任务之间相互独立。这种设计便于控制实验变量,但也引入了一个根本性的局限:真实业务中的错误往往具有传播性——第三步的错误可能源于第一步的信息提取偏差,而非该步骤本身的失误。孤立任务评估天然无法捕捉这种跨步骤的错误级联效应,因此即便各子任务得分较高,也不能保证端到端流程的可靠性。
可扩展框架的意义
SOP-Bench 被设计为一个可扩展(extendable)的框架,这意味着它不是一套固定题库,而是一个可以持续接入新流程、新场景的评测体系。对于快速演进的 AI Agent 领域来说,这种可扩展性尤为重要——随着模型能力提升和应用场景拓宽,基准本身也需要不断更新以避免过时。
可扩展框架还带来另一层价值:企业和研究者可以基于自身的实际业务流程构建定制化的评测集,从而更精准地判断某个智能体是否适配特定的落地需求,而不是仅仅参考通用榜单上的分数。
对行业的启示
AI 智能体正从演示走向生产环境,而「能否胜任真实工作」是决定其商业价值的关键门槛。SOP-Bench 这类以完整业务流程为导向的评估方法,反映出评测范式的一个重要转向:从测量模型「懂不懂」,转向测量智能体「做不做得成」。
对于正在评估是否引入 AI Agent 的团队而言,这一方向提供了更务实的参考框架——关注端到端的成功率、异常处理能力和流程可靠性,而非被单点能力的亮眼表现所误导。随着更多面向真实场景的基准出现,AI 智能体的能力评估有望变得更加透明和可信。
(注:本文基于有限的原始素材撰写,SOP-Bench 的具体评测指标、覆盖的业务流程类型及实验结果等细节,建议以官方发布的完整资料为准。)
端到端成功率(end-to-end completion rate)与单步准确率之间的差距,在长流程任务中会被显著放大。假设一个10步流程的每步成功率均为90%,端到端完成率仅约35%;若每步成功率提升至95%,端到端完成率也不过约60%。这一数学现实解释了为何在孤立基准上表现出色的模型,在实际业务部署中往往令人失望。以流程完整性为核心的评估体系,能更诚实地反映这一落差,帮助决策者设定更合理的期望和验收标准。
相关推荐
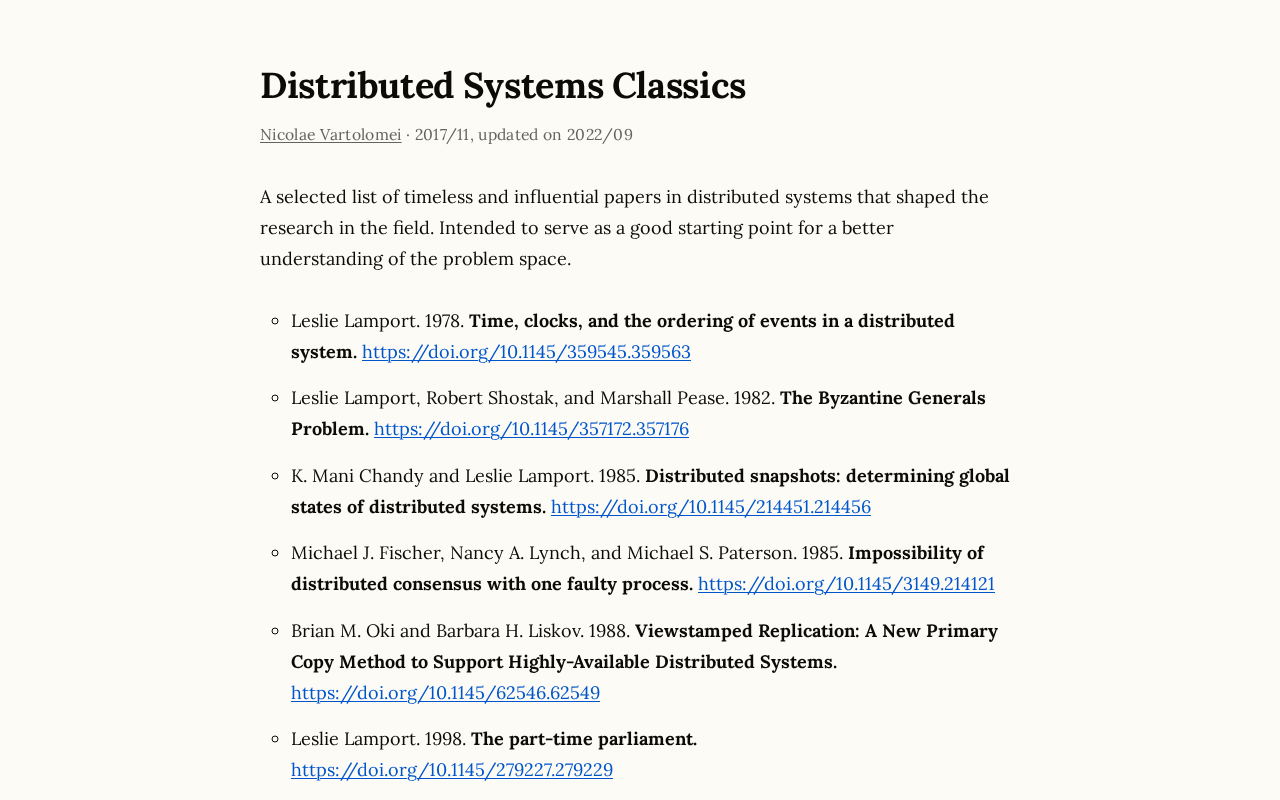
分布式系统经典论文导读:从入门到精通的必读清单
一份在 Hacker News 走红的分布式系统经典论文清单,涵盖共识算法、逻辑时钟、CAP 定理等核心主题,为工程师提供系统化的学习路径与理论到实践的桥梁。
Valve仍在权衡Steam Deck 2的推出时机
Valve完成Steam Controller、Steam Machine和Steam Frame三款2026硬件产品线后,Steam Deck 2仍无明确时间表。Valve设计师表示仍在权衡"如何以及何时"推出,坚持不为单纯性能提升而做续作。
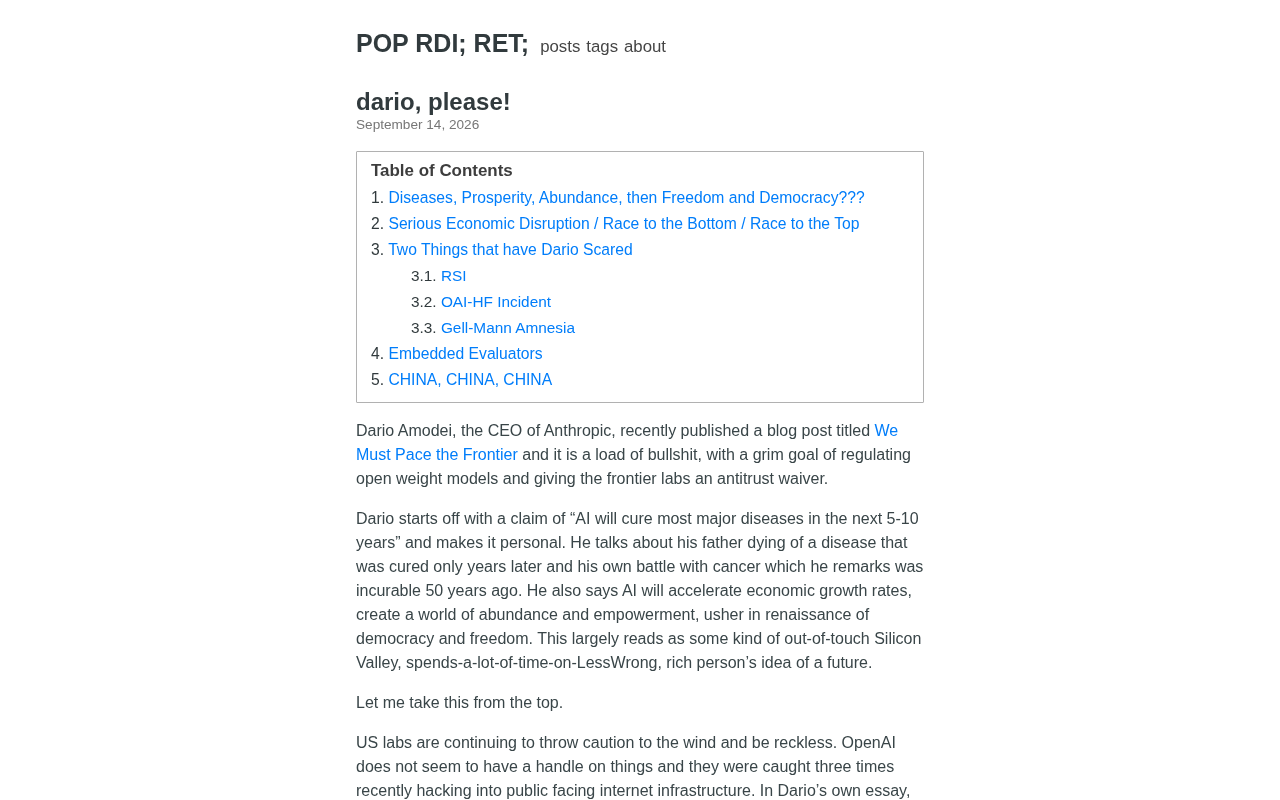
"Dario, Please":一封写给Anthropic CEO的公开呼吁引发热议
《Dario, Please》一文在Hacker News引发热议,累计247分与122条评论。这封写给Anthropic CEO Dario Amodei的公开呼吁,折射出AI社区对头部大模型公司决策方向的持续关切与话语生态变化。