SpeakON Agent:用自然语音驱动Agent完成实际工作

SpeakON Agent用自然语音驱动Agent,以Action审阅确认机制折中自动化与可控性。
SpeakON Agent是Product Hunt当日排名第三的AI Agent产品,主打把自然语音转化为真实工作。其链路包含语音理解、Notes上下文接入、工具连接与Action生成三个环节,核心设计是Agent不直接执行,而是准备好Actions供用户审阅确认,以回应自动执行不可控的痛点。文章分析了语音作为工作入口降低表达成本的价值,也指出确认环节可能打断交互流畅性,产品成败取决于确认界面是否足够轻量。该产品获139票、16条评论,处于早期关注阶段,分类含Hardware标签但硬件形态未披露。
在AI Agent赛道日益拥挤的当下,大多数产品仍停留在「输入框+工作流」的交互范式里。Product Hunt上排名第三的SpeakON Agent试图换一种方式:让用户像日常说话一样表达意图,由Agent理解上下文、连接工具,并生成可审阅、可确认的Action来完成任务。
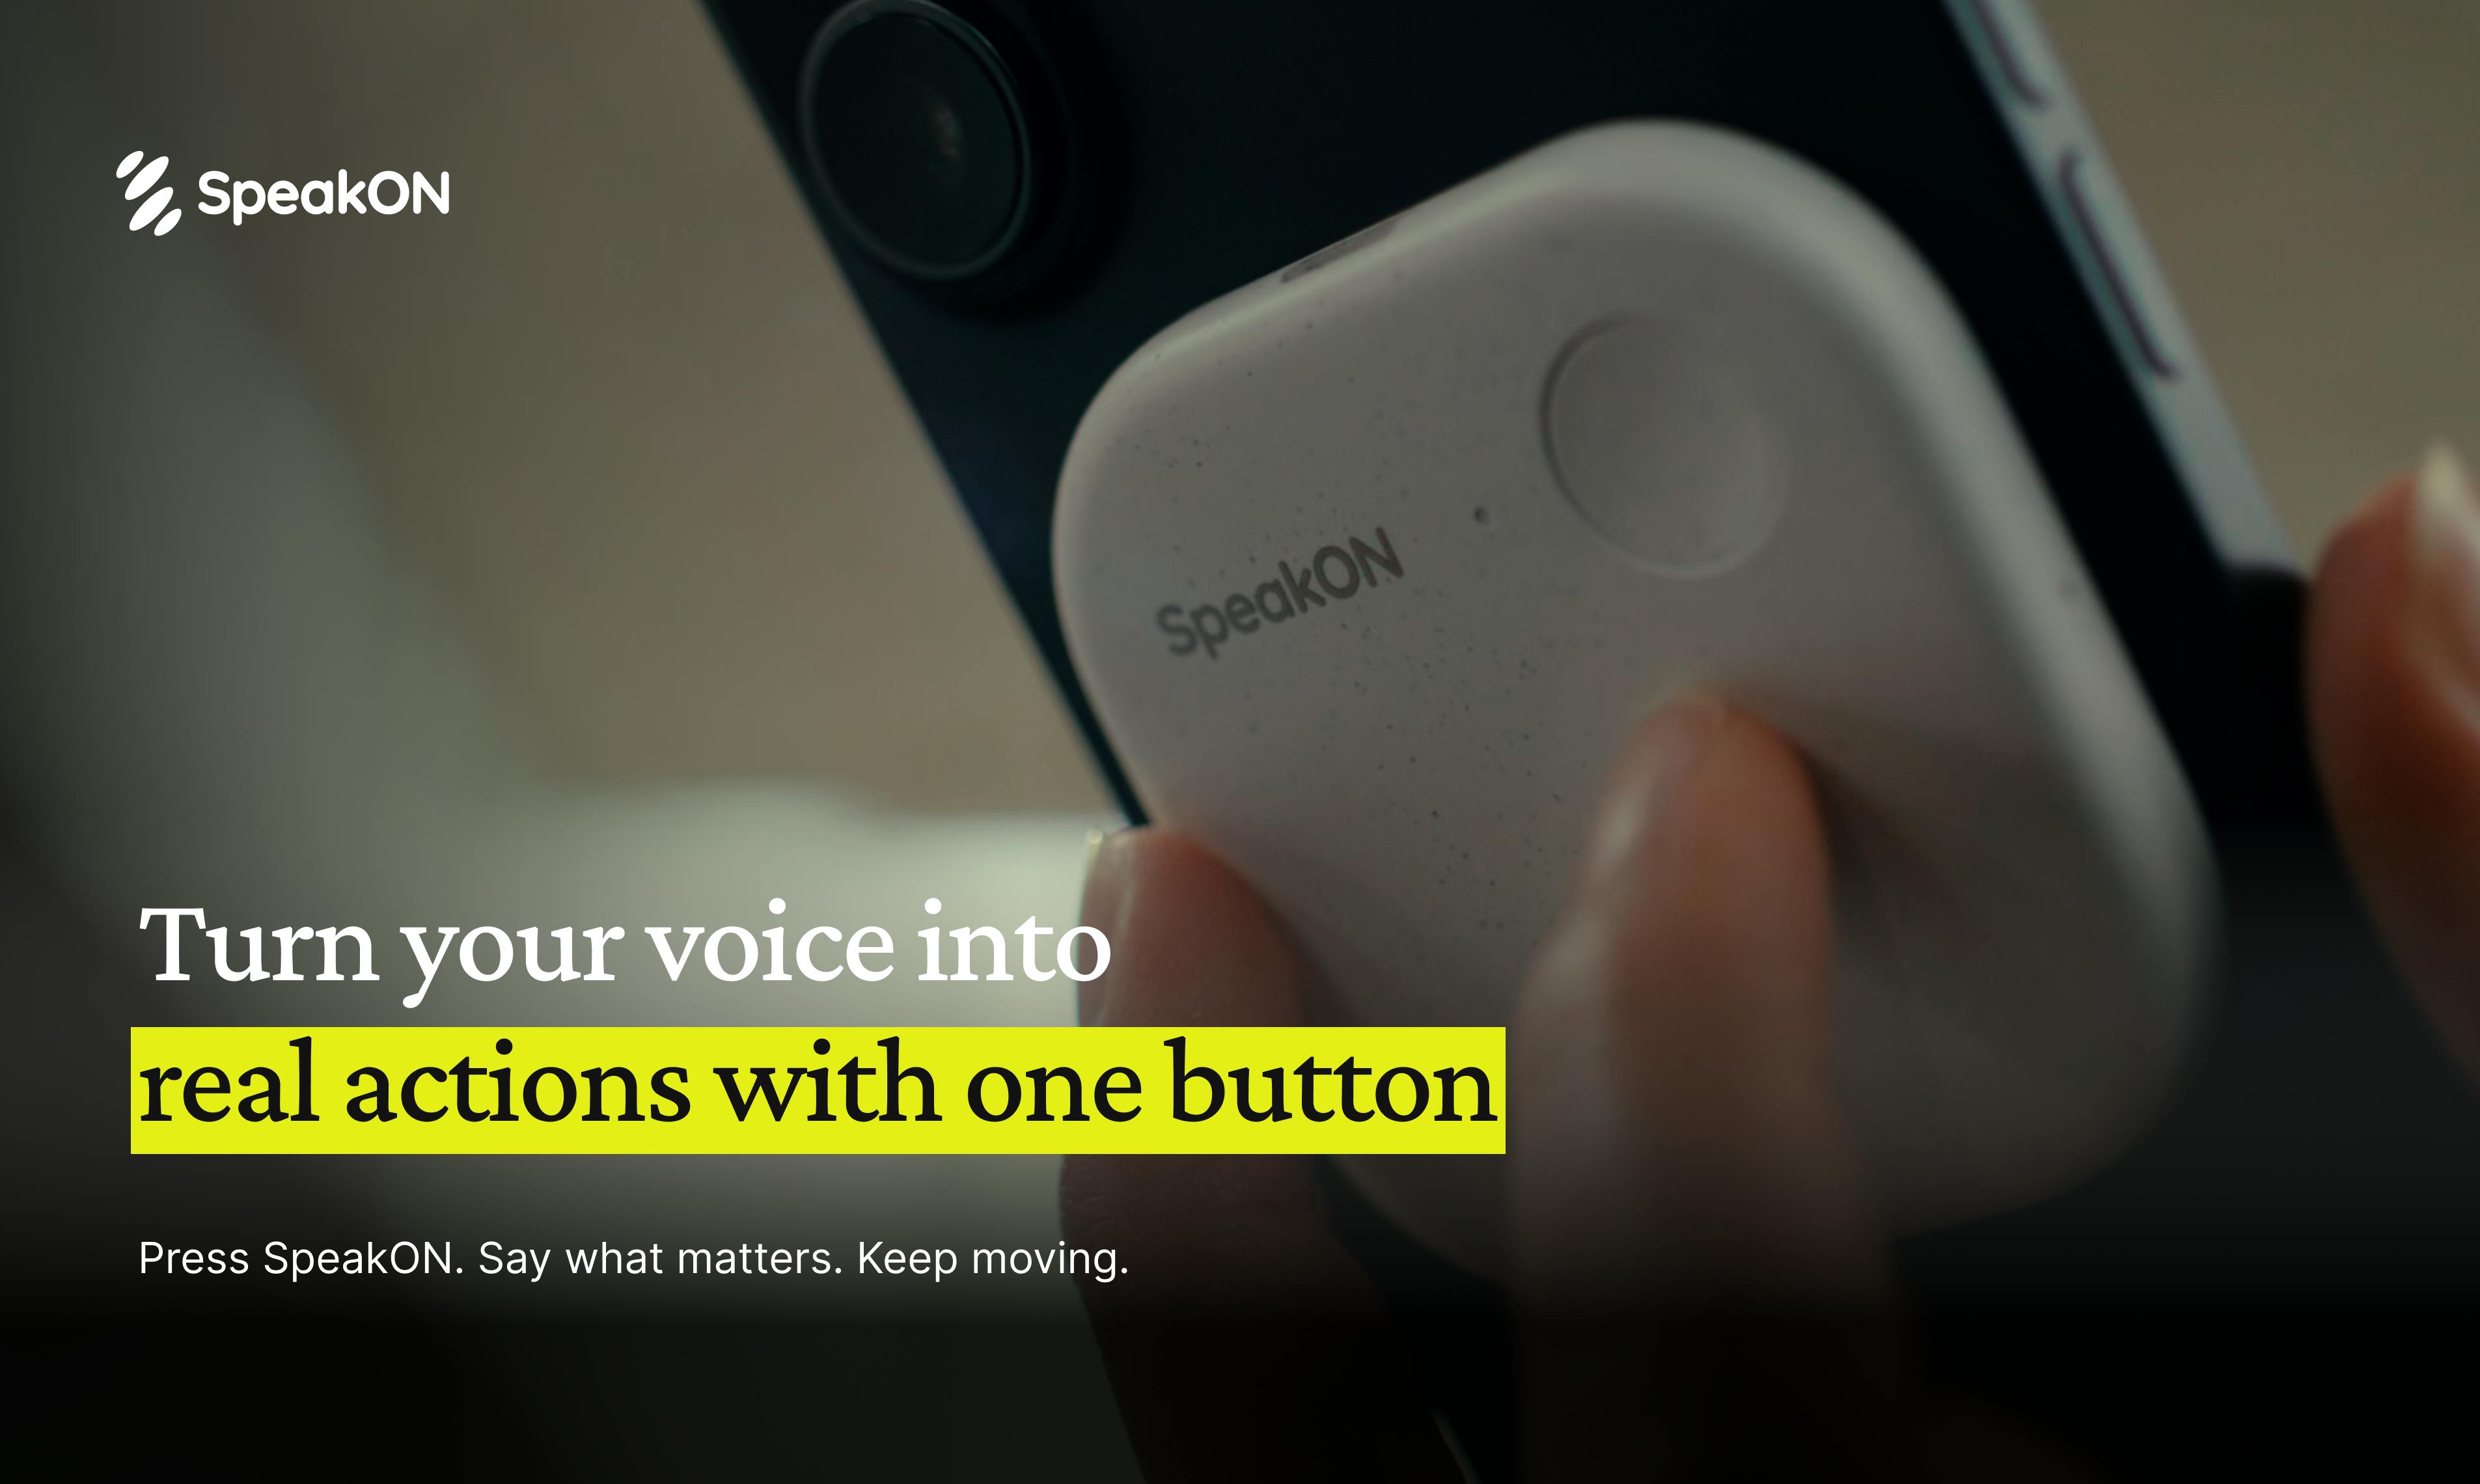
从「说」到「做」的链路设计
SpeakON Agent 的定位是「把自然语音变成真实工作」。据其Product Hunt页面描述,它能够理解用户的Notes(笔记),连接用户已有的工具,并准备好Actions供用户审阅和确认。
这条链路有三个关键环节:
- 语音理解:不是简单的语音转文字,而是把口语中的模糊表达转化为结构化意图;
- 上下文接入:读取Notes,让Agent知道用户在做什么、之前留下了什么;
- 工具连接与Action生成:调用外部工具,产出待确认的操作项。
有意思的是最后一个环节的设计:Agent不是直接执行,而是「准备好Actions供你审阅和确认」。这在一定程度上回应了当前Agent产品最受诟病的问题——自动执行带来的不可控风险。
结构化意图指将口语中含糊、省略、依赖语境的说法(如“把刚才那个发给老王”)解析为机器可解析的字段组合,通常包含动作类型、目标对象、参数与约束条件。它与单纯语音转文字的区别在于:转写只还原字面内容,而结构化意图需要结合对话历史、用户笔记与实体识别,补齐口语中未明说的指代与时序信息,输出可被工具调用层直接消费的任务描述。这一步的质量直接决定后续Action生成是否准确,也是语音Agent区别于语音助手的技术门槛。
Notes上下文接入在工程上通常表现为检索增强生成(RAG)与记忆机制的结合:Agent从用户的笔记、历史记录中检索与当前意图相关的片段,作为提示上下文注入模型,使其了解“用户正在做什么”。与通用聊天机器人不同,这类产品需要处理跨会话的长期记忆与隐私边界问题,上下文选取的相关性直接影响意图理解的准确度。
为什么「语音+Agent」值得关注
语音交互并非新概念,但过去几年它更多停留在助手类产品(查天气、设闹钟、放音乐)的浅层场景。当底层模型具备任务规划与工具调用能力之后,语音才真正有可能成为「工作入口」。
SpeakON Agent 切入的是生产力场景,而非娱乐或信息查询。这与它的Product Hunt分类(Productivity、Hardware、Artificial Intelligence)相吻合——Hardware标签暗示产品可能与特定硬件形态结合,但原始素材并未披露具体细节,尚无法确认其硬件形态与使用方式。
语音作为输入方式的价值在于降低表达成本。对于正在走动、手头有事、或只是不想敲键盘的用户,说一句话比打开应用、找到输入框、组织一段prompt要自然得多。
审阅确认机制:Agent落地的现实折中
SpeakON Agent 明确把「review and confirm」写进了产品描述。这一选择透露出团队对Agent可靠性的判断:在模型还不能完全保证动作正确的前提下,人机协同中的「人类把关」仍是必要的。
这种设计在体验上有双重效应。好处是用户保有控制权,尤其在涉及发送消息、修改文档、调用业务系统等操作时,误执行的代价较高;代价则是流程被切分成多步,语音输入的「一气呵成」感会被确认环节打断。
如何在确认环节做到足够轻量,是这类产品能否留住用户的关键。素材中没有提供确认界面的细节,因此无法评估其交互效率。
Human-in-the-loop(人在回路) 是AI系统设计中让人类在关键节点介入决策的模式,常见于高风险自动化场景。在Agent语境下,它通常体现为“提议—审阅—执行”三段式:模型只生成待执行的动作草案,由用户确认后才真正调用工具。这种模式与“全自动执行”相对,代价是增加交互轮次,收益是降低误操作带来的不可逆后果,也是当前Agent产品在可靠性不足阶段的常见工程折中。
市场反馈与竞争位置
在Product Hunt上,SpeakON Agent 获得139票、16条评论,排名当日第三。这个成绩说明产品在发布节点获得了社区关注,但票数与评论数也表明它仍处于早期阶段,尚未形成大规模讨论。
从竞争格局看,语音输入与Agent执行的结合正在成为多个团队探索的方向。SpeakON Agent 的差异化点不在于语音识别本身,而在于「Notes理解+工具连接+Action审阅」这一整套链路。能否把这条链路打磨得足够顺畅,决定了它究竟是「语音版待办工具」还是真正的Agent工作台。
对从业者的启示
SpeakON Agent 提供了一个观察样本:Agent产品的交互入口正在从文本框向外扩展。语音是其中一种,但核心命题是相同的——如何用最少的用户输入,换取Agent对意图和上下文的最大理解。
同时,「Action预备+人工确认」的模式值得更多团队参考。它既保留了自动化的效率,又为错误提供了缓冲。在Agent可靠性尚未达到无条件信任的阶段,这种折中可能比追求全自动更能赢得用户。
产品的最终成败仍取决于执行质量:语音识别的准确度、Notes理解的深度、工具连接的广度,以及确认环节的顺手程度。这些维度目前都缺乏公开数据支撑,需要等待实际使用反馈来验证。
相关推荐

私钥设为4?CA机构低级错误致TLS体系裸奔
CA机构eMudra将私钥设为数字4等极小值,导致TLS证书可被暴力破解。Computerphile视频演示了从提取公钥到伪造证书的完整过程,并探讨了PKI信任链的脆弱性。

Gen如何用ChatGPT Work把数据变决策
OpenAI用户案例中,企业领导者Gen分享用ChatGPT Work将数据转化为决策的实践:产品上线几小时内即可判断集成与引导流程是否有效,决策迭代从上百次试错变为快速反馈闭环。

ChatGPT与Claude深度对比:编程强但研究弱,如何弥补?
用户考虑从ChatGPT转向Claude,发现Claude编程更强但研究较浅。本文分析两者差异,并提供让Claude研究更深入的实用技巧,帮助您做出明智选择。