SponsorPulse:本地优先的品牌报价量化与谈判AI智能体

SponsorPulse 用 TabPFN 算价、Gemma 措辞加数值防火墙,把品牌报价拉回理性谈判。
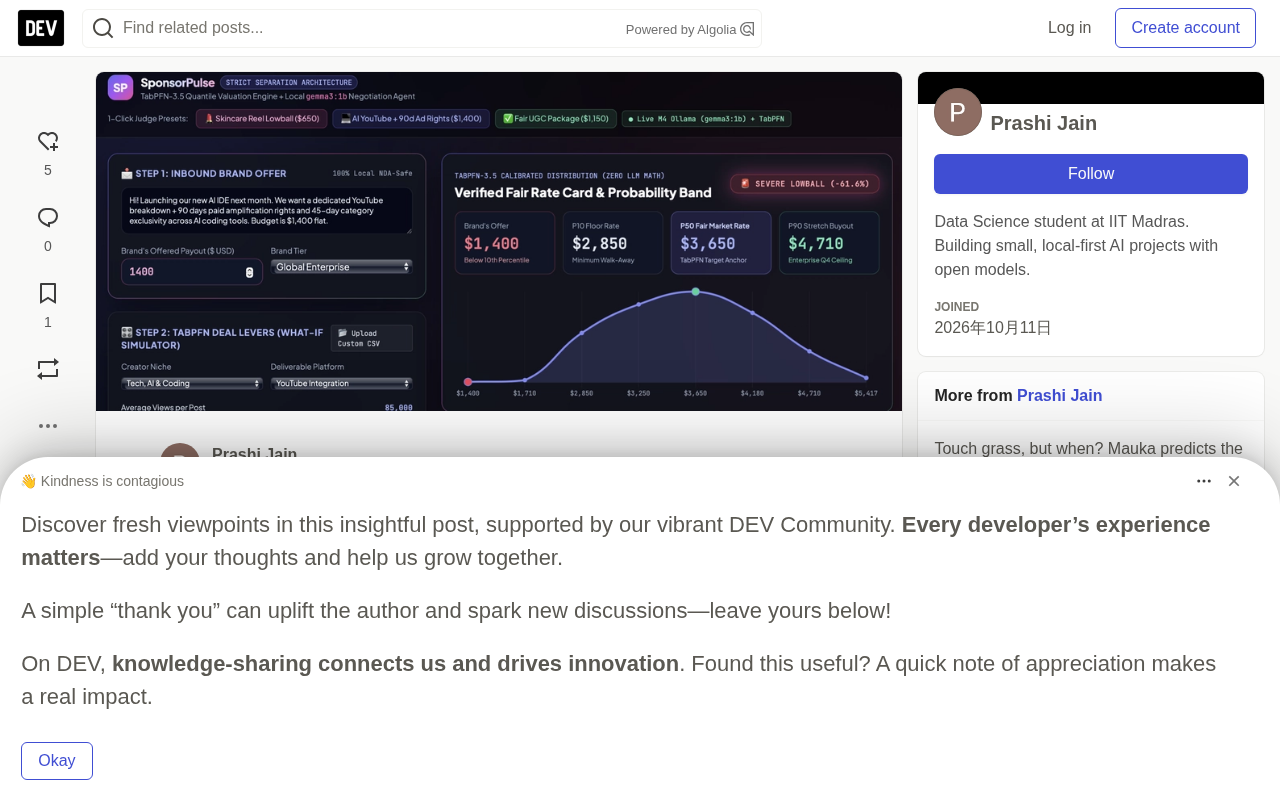
SponsorPulse 是一个本地优先的品牌合作报价量化与谈判智能体,源自 Hacktoberfest 侧业主题,面向创作者、UGC 作者和 Newsletter 写作者。它承认小参数 LLM 在数学计算上的固有缺陷,因此把「算」与「写」彻底分离:用 TabPFN-3.5 分位数引擎基于历史合作日志输出 P10/P50/P90 概率化报价区间,用 Prior Labs 反事实循环并行运行 5 组 What-If 查询量化条款变动的现金影响,再交由本地运行的 Gemma 3:1b 生成谈判措辞。两者之间设置数值防火墙,用 AST/Regex 校验层实时拦截并替换模型编造的数字。本地推理兼顾速度(120+ tokens/秒)与隐私,避免把谈判底牌上传云端。该项目示范了「专用模型计算 + 小模型表达 + 确定性校验」这一可迁移的 LLM 可靠性工程范式。
SponsorPulse:本地优先的品牌报价量化与谈判AI智能体
创作者接到品牌合作邀约时,常面对一个尴尬现实:报价单上写着 30 天付费广告白名单授权、15 天品类独家条款,但你无从判断这些条款到底该值多少钱。SponsorPulse 试图用「量化引擎 + 本地小模型 + 数值防火墙」的组合,把这场信息不对称的博弈拉回理性区间。
该项目源自 Hacktoberfest 第二周「侧业」主题,面向创作者、UGC 作者和 Newsletter 写作者,核心定位是一个本地优先的智能报价台。
为什么小模型不能直接算钱
项目作者给出的判断相当明确:小参数 LLM 在数学任务上表现糟糕。如果直接让语言模型给品牌合作定价,它会凭空编造随机数字。
这不是某个模型的缺陷,而是自回归语言模型的基本特性——它们擅长生成「看起来合理」的文本,而非执行精确的概率计算。SponsorPulse 的应对策略是将「算」和「写」彻底拆开:计算交给专用表格基础模型,措辞交给本地 Gemma,两者之间用一道强制校验层隔开。
确定性神经符号流水线拆解
SponsorPulse 的架构可概括为四层,作者称之为「确定性神经符号流水线」。
TabPFN 分位数引擎:算出价格带而非单点报价
TabPFN-3.5 接收历史合作日志,输入维度包括播放量、互动率、素材使用权限、白名单授权、独家条款等,输出的是概率化的估值区间——P10 代表「走人底线」,P50 是中位目标价,P90 则是企业级上限。用区间替代单一数字,本身就是对谈判不确定性的诚实回应。
TabPFN(Tabular Prior-Data Fitted Network)是一种专为表格数据设计的「基础模型」,其思路与 GPT 类文本基础模型类似,但输入输出都是结构化表格。它通过在大量合成表格任务上进行元学习,把「在小样本表格上做分类或回归」的能力预训练进网络权重,因此无需针对每个新数据集重新训练即可直接推理,且在样本量较小(几十到几百行)时往往优于梯度提升树等传统方法。TabPFN-3.5 是其较新的版本,支持回归任务与不确定性估计——这正是 SponsorPulse 需要的:不是给出一个点估计值,而是输出预测分布。分位数(P10/P50/P90)即从该分布中截取的位置点:P10 表示只有 10% 概率低于此值,可视为接受底线;P90 表示只有 10% 概率高于此值,是企业方可能给出的上限。用分位数区间表达报价,本质上把「定价」从单点猜测变成了带置信度的概率陈述。
Prior Labs 反事实循环:把条款变动翻译成钱
系统并行运行 5 组「如果……会怎样」的查询,直接告诉创作者:调整某项合同条款能释放多少现金。比如减少独家天数、限制白名单授权范围,分别对应多少报价差额。这把抽象的合同谈判变成了可视化的数字权衡。
反事实(counterfactual)推断源于因果推理领域,指的是在「已经观测到的现实」之外,追问「如果某个条件被改变,结果会如何」。在合同谈判语境下,现实是品牌方给出的原始条款组合,反事实则是「如果把品类独家从 15 天缩短到 7 天,报价应该变成多少」。技术上,系统把每一条被改动的条款作为新的输入向量,重新送回 TabPFN 分位数引擎推理,从而得到该假设情境下的概率分布。之所以要「并行运行 5 组」,是因为合同杠杆往往相互耦合:独家天数、白名单范围、素材二次使用权分别影响不同维度的价值,逐一量化才能让创作者看清每一项让步的边际价格,进而在谈判中优先守住最贵的那几条。
本地 Gemma 3:1b:在 Apple Silicon 上跑出 120+ tokens/秒
通过 Ollama 在本地运行 Gemma 3:1b,速度达到每秒 120+ token。本地部署的意义不只是快——品牌合作邮件往往包含报价、受众数据和合同条款,这些内容如果上传到云端 API,创作者等于把自己的谈判底牌交给了第三方。本地推理在隐私上更让人放心。
Gemma 是 Google 发布的开放权重模型系列,命名取自拉丁语「宝石」,提供 2B、7B、9B、27B 等多种参数规模,与闭源的 Gemini 系列同源但可本地部署。3:1b 指该系列第三代中 10 亿参数级别的版本,体量小到可在消费级硬件上运行。Ollama 是一个开源的本地大模型运行与分发工具,把模型权重、量化格式和推理后端(如 llama.cpp、Metal)打包成一条命令即可启动的服务,并暴露兼容 OpenAI 的本地 API。Apple Silicon 指苹果自研的 M 系列芯片,其统一内存架构让 CPU 与 GPU 共享同一块内存,避免了数据拷贝开销,因此小模型推理能跑到每秒上百 token。对于 1B 级模型,120+ tokens/秒意味着生成一段两百词的谈判措辞只需约两秒,接近实时交互体验。
数值防火墙:物理拦截幻觉数字
这是整个架构中最值得关注的设计。一个 AST/Regex 校验层实时扫描 Gemma 的输出,一旦发现模型「编造」了数字,立刻拦截并强制替换为 TabPFN 已验证的精确数值。
这种做法把「防止 LLM 幻觉」从提示词工程层面,下沉到了确定性的代码校验层面。
AST(Abstract Syntax Tree,抽象语法树)在这里指对模型输出文本做结构化解析的一种手段:先把 Gemma 生成的句子切分并识别出其中的数字、单位、比较关系,形成一棵可遍历的语法树,再逐节点与 TabPFN 的已验证结果比对。Regex(正则表达式)则用于更轻量的模式匹配,例如快速抓取「$」「%」「天」「万」等单位附近的数值 token。之所以强调「物理拦截」,是因为它与提示词层面的约束有本质区别:提示词只是「请求」模型不要说错,模型仍可能违反;而 AST/Regex 校验层位于模型输出之后、呈现给用户之前,是确定性的代码门禁,不依赖模型是否听话。一旦某个数字不在已验证集合中,系统直接丢弃并替换,模型对数字没有任何自由裁量权——这正是把「防幻觉」从概率性手段转为工程性保证的关键一步。
功能亮点
品牌邀约审计:粘贴任意品牌邮件,SponsorPulse 即时扫描其中的掠夺性条款,并计算少付差额。
交互式谈判杠杆:实时调整播放量、互动率和广告使用权限滑块,概率曲线同步更新。
Sentry Agent 追踪:基于 OpenTelemetry 的 span 瀑布图,覆盖 TabPFN 推理、反事实变更和 Gemma 合成全链路的延迟。
一键评审沙盒:部署了浏览器内回退引擎,即使没有安装 Ollama,也能直接测试滑块和概率曲线。
一个值得关注的工程思路
SponsorPulse 的真正价值不在于「用 AI 帮创作者报价」,而在于它示范了一种处理 LLM 可靠性问题的模式:承认语言模型不擅长的领域,用专用模型补位,再用确定性的校验层守住最后一道关。
这套「专用模型计算 + 小模型表达 + 数值防火墙」的组合,在报价谈判之外的场景——比如财务分析、医疗数据摘要、法律条款解读——同样有借鉴意义。
项目已开源,提供 GitHub 仓库和线上演示版本。
相关推荐

主流世界之外:被忽视地区的安全与隐私困境
人本安全研究长期集中于西方,导致安全方案在主流世界失效。研究者Collins Minando基于肯尼亚移动贷款应用、网吧认证困境及九国本地专家研究,揭示社会经济约束如何重塑隐私实践,并提出移动货币隐私重设计与PETs部署路径。

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。

AI助手何时该主动建议?时机决定一切
AI助手何时该主动建议?Reddit讨论揭示:同样的建议在不同时机感受迥异。本文分析主动建议的双面性、用户期待的分界线及设计原则,探讨如何平衡自动化与用户控制。