Spring Boot加LLM:不建Python服务也能上线AI功能

用Spring Boot+Spring AI在现有服务内实现工单分类,重点在类型化输出、截止时间与降级。
文章基于一次真实实验,演示如何在已部署的 Spring Boot 4.1.1 + Spring AI 2.0.1 + Java 21 服务中,直接实现工单自动分类,而不必另建 Python 微服务。作者先比较 Spring AI 与 LangChain4j 的选型逻辑,指出只有训练/微调模型或进程内推理才值得引入 Python。核心设计是把模型的不确定性关进笼子:用带枚举的小记录约束输出、分离模型侧类型与 API 类型、限制输入长度、用虚拟线程实现应用级截止时间、用信号量限制并发并统一降级。故障注入实验揭示两个反直觉发现——SDK 重试会与应用重试叠加,默认下一次失败请求产生 4 次上游调用;SDK 超时并不能替代应用截止时间。文末给出上线检查清单与版本兼容注意事项。
很多Java团队一提到加AI功能,第一反应是单独搭一个Python微服务。但如果需求只是“调用模型、拿回结构化数据、在现有API里用起来”,你完全可以在已经部署、监控、鉴权的Spring Boot服务里完成。
这篇内容来自一个真实动手实验:用Spring Boot 4.1.1 + Spring AI 2.0.1 + Java 21,在本地搭建OpenAI兼容的mock服务器,把一个工单自动分类功能端到端跑通。重点不是demo,而是上线前必须处理的“无聊部分”:类型化输出、调用截止时间、并发预算和降级方案。
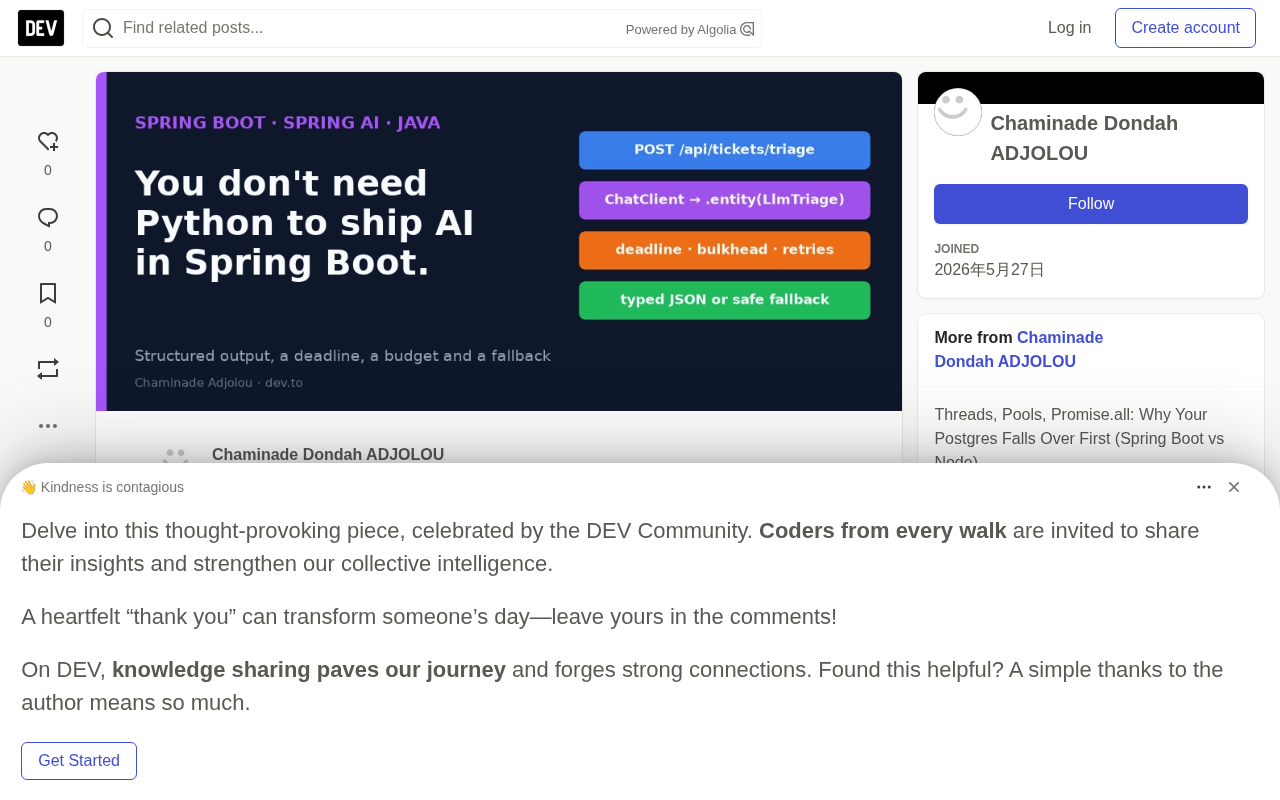
为什么不必默认选Python服务
Spring AI和LangChain4j都是JVM上成熟的选项。选择逻辑很简单:已经在用Spring Boot,想要自动配置、application.properties参数、Micrometer观测和流式ChatClient,选Spring AI;不在Spring生态(Quarkus、Micronaut或纯Java),或者需要更高层的“AI services”接口式Agent和更全的集成目录,选LangChain4j。
两者都支持OpenAI兼容API,覆盖大量托管模型和本地模型服务(如Ollama、vLLM)。原文明确:工单分类这类“调用模型→解析结构化输出→存储或返回”的功能,留在Spring Boot里是合理的;需要训练/微调模型、跑数据科学管线、或做进程内模型推理时,才值得引入Python服务。
Spring AI 是 Spring 官方推出的 AI 集成框架,核心抽象是 ChatClient(流式对话接口)和 EmbeddingClient 等,通过 starter 依赖与 Spring Boot 自动配置无缝集成,模型参数可直接写在 application.properties 里,并自动接入 Micrometer 指标与链路追踪。它内置对 OpenAI、Anthropic、Azure OpenAI、Ollama 等多家服务商的支持,对 OpenAI 兼容 API 的适配尤为完整。LangChain4j 则是受 LangChain 启发的社区项目,除底层模型调用外,还提供 AiServices 这类声明式接口——只需定义一个 Java 接口,框架就自动生成实现并处理提示词组装与结果解析,集成目录(向量库、文档加载器等)也更广。简言之,Spring AI 胜在与 Spring 生态的原生融合,LangChain4j 胜在更高层的抽象与更丰富的周边集成;两者都运行在 JVM 上,不必为了调用模型而切换语言。
核心设计:把不确定性关进笼子
只向模型要一条小记录
定义LlmTriage记录,字段包括枚举Category、枚举Priority、summary和tags列表。每个字段都是模型必须兑现的承诺,字段越少越可控。
关键细节:模型侧类型(LlmTriage)和API返回类型(TicketTriage)要分开。作者第一版把带source字段的API记录直接传给.entity(...),结果Spring AI生成的JSON Schema把source列为必填,模型被迫去猜自己是不是降级来源。模型不知道的事,不该让它填。
用枚举是成本最低的护栏。生成的schema里会带上"enum": ["BILLING", "BUG", ...],模型若编造"PAYMENTS",解析直接失败,而不是让未知分类漏进数据库。
结构化输出(Structured Output) 指让模型按预先给定的 JSON Schema 返回数据,而非自由文本。Spring AI 的 .entity(Class<T>) 会从目标 Java 记录(record)反射生成 JSON Schema,随请求一并下发给模型;支持该能力的服务商(OpenAI 的 Structured Outputs 等)会在解码阶段施加约束,使输出在语法层面就符合 schema。Java 的 record 是理想载体:字段不可变、简洁,且每个组件天然对应 schema 中的一个属性。枚举在其中扮演关键角色——枚举会映射为 schema 的 enum 约束,把模型的可选值限定在有限集合内,从源头杜绝“编造分类”这类幻觉。需要注意,schema 中生成为 required 的字段是模型必须兑现的承诺,因此模型侧类型应只包含模型真正能决定的字段,任何由应用填充的元数据(如来源标记)都必须从该类型中剥离。
截止时间、预算与降级
服务层做了四件事:
- 输入限制:工单文本1到4000字符,超长直接拒绝,保护token账单和延迟。
- 提示注入防护:工单内容通过模板参数放进
<ticket>标签,系统提示词声明规则。这不等于完全防住注入,但配合枚举输出,最坏结果是分类错误,而不是任意文本进入UI。 - 应用级截止时间:用虚拟线程把阻塞调用包进
Future,triage.timeout(示例6秒)一到就cancel并降级,无论模型服务商那边发生什么。 - 并发预算:
Semaphore限制同时在途的模型调用数(示例8个),满了直接降级而不是排队,既保护速率限制也保护线程池。
降级返回source: "fallback",告诉UI和指标系统这条需要人工分类。功能优雅降级,而不是造成故障。
虚拟线程(Java 21 正式特性,JEP 444)是由 JVM 调度的轻量级线程,创建成本极低,阻塞时自动卸载载体线程,因此非常适合包装“等待网络 I/O”的模型调用。把阻塞调用提交到虚拟线程执行器并拿到 Future,主线程便可用 future.get(timeout) 施加应用级截止时间,超时后 cancel(true) 触发中断并转入降级路径。信号量(Semaphore) 是 AQS 实现的计数同步器,tryAcquire() 不阻塞、立即返回布尔值,正好实现“预算满则快速失败而非排队”的语义,避免请求在队列中堆积导致延迟雪崩,同时保护下游服务商的速率限制。二者结合,使模型调用这一最不确定的环节具备了与普通远程调用同等的可预测性:有上限、有超时、有兜底。
故障注入实测:两个反直觉发现
作者用mock服务器强制制造每种失败,实际结果如下:
- 合法JSON → 正常返回,约0.7秒
- 返回散文而非JSON → 降级,约0.01秒(解析异常)
- 模型挂起8秒 → 降级,6.0秒(应用截止时间触发)
- HTTP 500 → 降级,约0.5秒(上游被调用2次)
发现一:重试会叠加。 默认配置下,一次失败的用户请求产生了4次上游模型调用。Spring AI 2.0的OpenAI集成基于官方openai-java SDK,SDK自带重试设置(spring.ai.openai.chat.max-retries,配置元数据里默认3)。对一个有降级兜底的用户接口,这意味着用户多等三次计费尝试。作者把它设为1后降到2次。另一个细节:spring.ai.openai.chat.options.max-retries也在元数据里,但实测无效,只有不带options的那个属性生效。上线前请到服务商日志里数一数上游调用次数。
发现二:保留自己的截止时间。 元数据里还有spring.ai.openai.chat.timeout(默认60秒),但作者设成4秒后,并没有在6秒应用截止时间之前切断挂起的调用。作者没有深究,建议在自己的环境里验证。无论如何,应用级截止时间是你可控、可单测的东西。
重试叠加的根源在于重试发生在多个独立层次:openai-java SDK 内部对 429/5xx 及连接异常有指数退避重试(默认 3 次),应用代码若再包一层重试框架(如 Spring Retry 或 Resilience4j),用户的一次点击就会被放大为乘积级的上游调用。对带降级兜底的接口,重试往往弊大于利——降级已经保证了可用性,额外重试只会拉长用户等待并增加计费。SDK 超时与应用截止时间 属于不同语义:前者作用于单次 HTTP 连接/读取,后者约束整个业务调用的总时长;若 SDK 超时大于应用截止时间,应用层会先返回降级,而底层请求仍可能在后台继续,甚至在被取消后仍完成计费。因此二者的关系应是“SDK 超时 ≤ 应用截止时间”,且以应用层为准做单元测试验证。
上线前检查清单
- 输出是带枚举的小记录,模型侧类型与API类型分离
- 输入长度受限,且作为模板参数传入而非拼进指令
- 设置了
max-tokens,分类场景温度调低 - 应用截止时间短于HTTP客户端超时和用户耐心
- 端到端统计重试次数(SDK + 你的代码 + 客户端)
- 并发有上限,溢出走降级
- 响应标明来自模型还是降级,并对该比例做监控
- 清楚哪些个人数据会随提示词离开你的系统,且服务商的数据保留条款允许
版本注意事项
Spring AI 2.0面向Spring Boot 4.x;仍在Boot 3.x的话用Spring AI 1.x,ChatClient和.entity(...)API在那边同样存在,但属性名可能不同。.entity(...)还支持可靠性开关(validateSchema()出错带反馈重试、useProviderStructuredOutput()把schema作为服务商级约束下发),作者未在mock上测试,所以没放进示例代码。每个校验重试都是又一次计费调用。另外若同一项目引入springdoc,注意swagger-annotations版本冲突(作者需要锁定2.2.55)。
何时该加Python服务
需要训练或微调模型、需要只有Python才有的库做进程内推理、或ML团队想要独立发布周期时,单独起Python服务是合理的。即便如此,Spring Boot这一侧的结构不变:带截止时间和降级的类型化调用,只是URL变了。
对于大多数“调用模型拿结构化数据”的业务功能,答案很直接:不必为了用AI而引入一门新语言和一个新部署单元。
相关推荐

JobRunner MCP服务器:AI智能体可修复失败的Java任务
JobRunner 推出开源 MCP 服务器,让 AI 智能体直接查看集群状态、诊断失败原因并恢复 Java 任务,运维人员可在云编码环境或已有智能体中完成故障响应。

MLAI Digital推出9大安全智能体:MCP服务器守护Agentic AI全生命周期
MLAI Digital推出Security MCP Server,内置九个专业安全智能体,覆盖漏洞发现、攻击模拟、Prompt注入检测、API与基础设施评估及修复加速,将安全验证嵌入Agentic AI开发到生产的完整生命周期。

H100 GPU运行Isaac Lab:更优方案探讨
探讨在NVIDIA H100 GPU上运行Isaac Lab的优化方法,包括MIG配置、混合精度、TensorRT加速及社区经验,帮助提升机器人仿真与强化学习效率。