SqueezeBench:抗饱和的AI数学能力评测基准

SqueezeBench用动态上下界机制与Lean形式验证,构建永不饱和的AI数学能力评测基准。
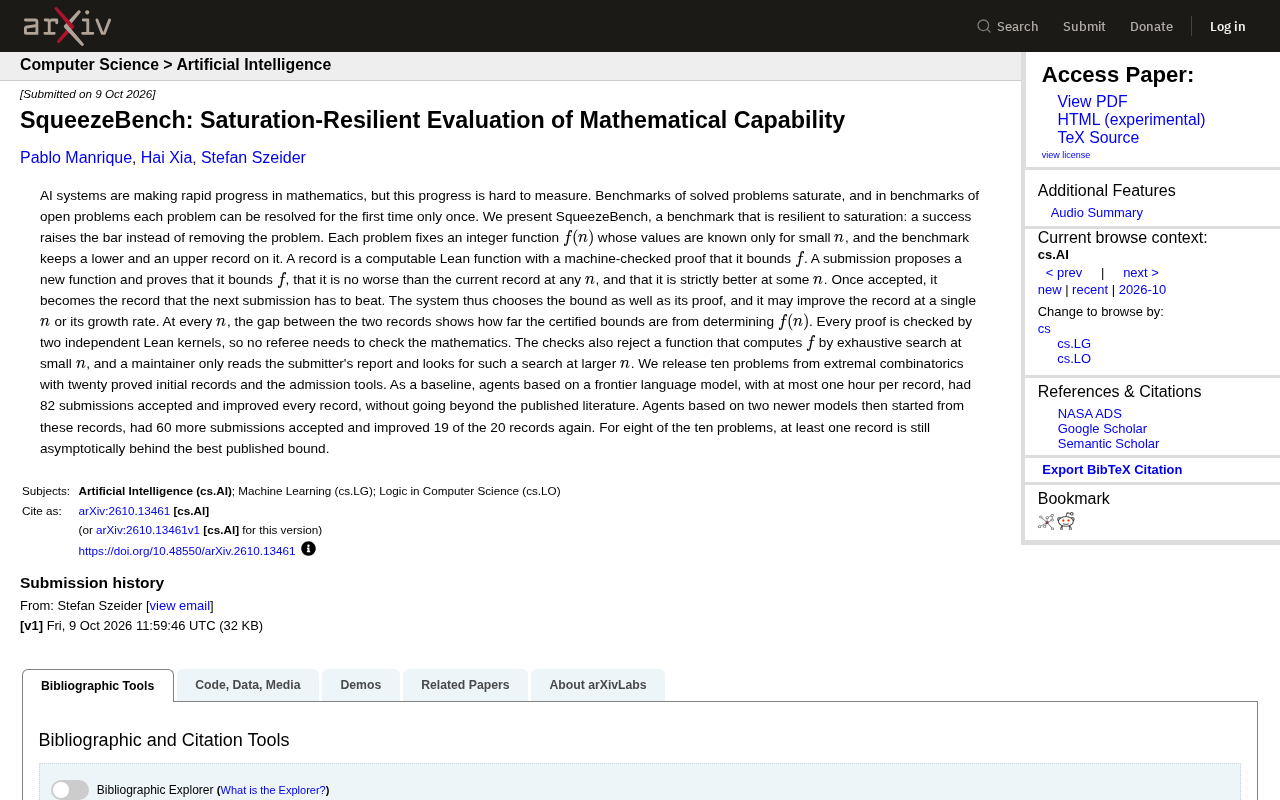
SqueezeBench针对现有数学基准"很快被刷满、随后失效"的根本缺陷,提出了一种抗饱和的评测框架。其核心设计是:每道题对应一个整数函数f(n),系统持续维护机器可验证的上界与下界记录;提交者若想被采纳,必须用Lean形式化证明其新函数严格优于当前记录,由此旧记录自动成为新挑战的起点。双Lean内核交叉验证保证了无需人类裁判即可确认数学正确性,同时系统拒绝穷举搜索式的取巧提交。实验基于极值组合学的十个开放问题展开,前沿AI智能体共产生142份被接受的提交并持续改进记录,但十个问题中仍有八个的至少一条记录在渐近意义上落后于人类已发表的最佳成果,揭示了当前AI数学能力的真实局限。
为什么现有数学基准正在失效
人工智能在数学领域的进步速度令人瞩目,但衡量这种进步却成了一道难题。传统的数学基准测试面临两种困境:一类基于已解决问题的测试会很快被模型刷满(saturate),一旦前沿模型全部答对,这个基准就失去了区分能力;另一类基于未解决开放问题的测试,每道题目只能被首次攻克一次,之后便无法重复衡量。
换句话说,当AI系统的能力逼近甚至超越基准设计者的预期时,这些评测工具会迅速贬值。研究者需要的,是一种能够随着能力提升而自我进化的评测机制。SqueezeBench 正是针对这一痛点提出的解决方案。
SqueezeBench 的核心机制:成功即抬高门槛
SqueezeBench 的设计哲学可以概括为一句话——解出一道题不是移除它,而是抬高它的门槛。这种"抗饱和"(saturation-resilient)特性是它区别于传统基准的关键。
具体来说,每个问题对应一个整数函数 $f(n)$,这个函数只有在 $n$ 较小时的取值是已知的。基准会为每个函数维护一个下界记录和一个上界记录。所谓"记录",是指一个可计算的 Lean 函数,并附带机器可验证的证明,确保它确实约束了 $f$。
当有人提交新成果时,必须同时证明三件事:新函数确实约束了 $f$;在任意 $n$ 处它都不比当前记录差;并且至少在某个 $n$ 处严格优于当前记录。一旦被接受,这个新函数就成为新的记录,下一个提交者必须超越它才能被认可。
既选择边界,也选择证明
这套系统有个有趣的特性:它不仅让参与者选择"答案"(更紧的边界),还要求选择"证明"。改进可以发生在单个 $n$ 点上,也可以体现在整体的增长率(growth rate)上。在每一个 $n$ 处,上下两个记录之间的差距,直观地反映了当前被认证的边界距离确定 $f(n)$ 真实值还有多远。
双 Lean 内核验证:无需人工裁判
SqueezeBench 的另一个工程亮点在于验证机制。每一份证明都由两个独立的 Lean 内核进行检查,这意味着整个数学正确性的审核无需任何人类裁判介入。这极大降低了评测的主观性和维护成本。
当然,自动化验证也要防范作弊。系统会主动拒绝那些通过在小 $n$ 范围内穷举搜索来"计算" $f$ 的函数——这种做法只是记忆而非真正的数学推理。维护者的工作仅限于阅读提交者的报告,并留意在更大的 $n$ 处是否存在类似的穷举搜索取巧行为。
这种"机器验证为主、人工抽查为辅"的架构,让基准在规模化时依然保持可信度和可持续性。
Lean 是一种交互式定理证明器(interactive theorem prover),由微软研究院开发,目前在形式化数学社区中被广泛使用。它的核心思想是:用一套严格的类型论(type theory)作为逻辑基础,将数学命题表示为类型、将证明表示为该类型的项,由计算机内核逐步检查每一步推导的合法性。与传统"人工审阅"不同,只要 Lean 内核接受了一段证明代码,其正确性就在该逻辑系统内得到了机械保证,无需依赖人的判断或信任。SqueezeBench 使用两个独立的 Lean 内核交叉校验,是一种额外的防御措施:两个内核在实现上独立,若两者都接受同一份证明,则出现共同错误的概率极低,从而进一步提升了验证结论的可信度。这也是为什么整个评测流程可以做到"无需人类裁判"——数学正确性的最终裁决权完全交给了可审计的机器逻辑。
实验结果:前沿模型表现与局限
研究团队发布了十个来自极值组合学(extremal combinatorics)领域的问题,附带二十个已证明的初始记录以及准入工具。
作为基线测试,基于某个前沿语言模型的智能体,在每条记录上最多花费一小时的限制下,共有 82 份提交被接受,并改进了全部记录——但这些改进并未超出已发表文献的范围。随后,基于两个更新模型的智能体从这些记录出发继续推进,又有 60 份提交被接受,并再次改进了 20 条记录中的 19 条。
这组数据揭示了两个层面的信息。一方面,前沿模型确实具备持续推进数学边界的能力,而且新一代模型能在旧模型的成果之上继续优化,印证了基准的"接力式"进化设计有效。另一方面,一个清醒的事实是:在十个问题中,有八个问题的至少一条记录仍然在渐近意义上落后于已发表的最佳边界。
换言之,当前最强的AI智能体在严格的机器验证标准下,尚未能追平人类数学界的最佳成果。这为衡量AI真实数学能力提供了一把更诚实的尺子。
极值组合学(extremal combinatorics)是组合数学的一个分支,核心问题是:在满足某种约束条件的离散结构(图、集合系统、序列等)中,某个参数的最大值或最小值是多少?经典问题如"$n$ 个顶点的图最多有多少条边才能不包含三角形"(Turán 问题)就属于这一类。此类问题的特征是:答案通常是关于参数 $n$ 的函数,上界与下界往往来自不同的证明技术,且两者之间常常存在难以消弭的渐近差距。这使得极值组合学问题天然适合 SqueezeBench 的"维护上下界并持续收紧"框架——既不会一步被彻底解决,又可以通过改进构造或证明技术不断取得阶段性进展,是检验 AI 持续数学推理能力的理想领域。
对AI评测范式的启示
SqueezeBench 代表了一种值得关注的评测思路转变。它把静态的"题库"变成了一个动态的、永不饱和的"竞技场",让每一次成功都成为下一次挑战的起点。这种设计天然适配能力持续增长的AI系统,避免了基准反复失效、不断重建的尴尬。
更重要的是,机器可验证的证明与双内核交叉检查,为AI数学能力评估树立了严谨的可信标准。相比那些依赖人工评分或容易被记忆攻破的测试,SqueezeBench 在客观性和抗作弊性上都更进一步。随着AI在形式化数学领域的持续演进,这类抗饱和、自我进化的评测框架很可能成为未来研究的重要基础设施。
相关推荐

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。

Anthropic IPO前,早期投资人账面回报有多高?
Anthropic IPO前早期投资人账面回报引发关注。本文分析其纸面收益来源、资本结构、IPO预期下的博弈与风险,以及对AI创业生态的启示。