SRBench:用大模型自动化系统综述筛选的基准框架
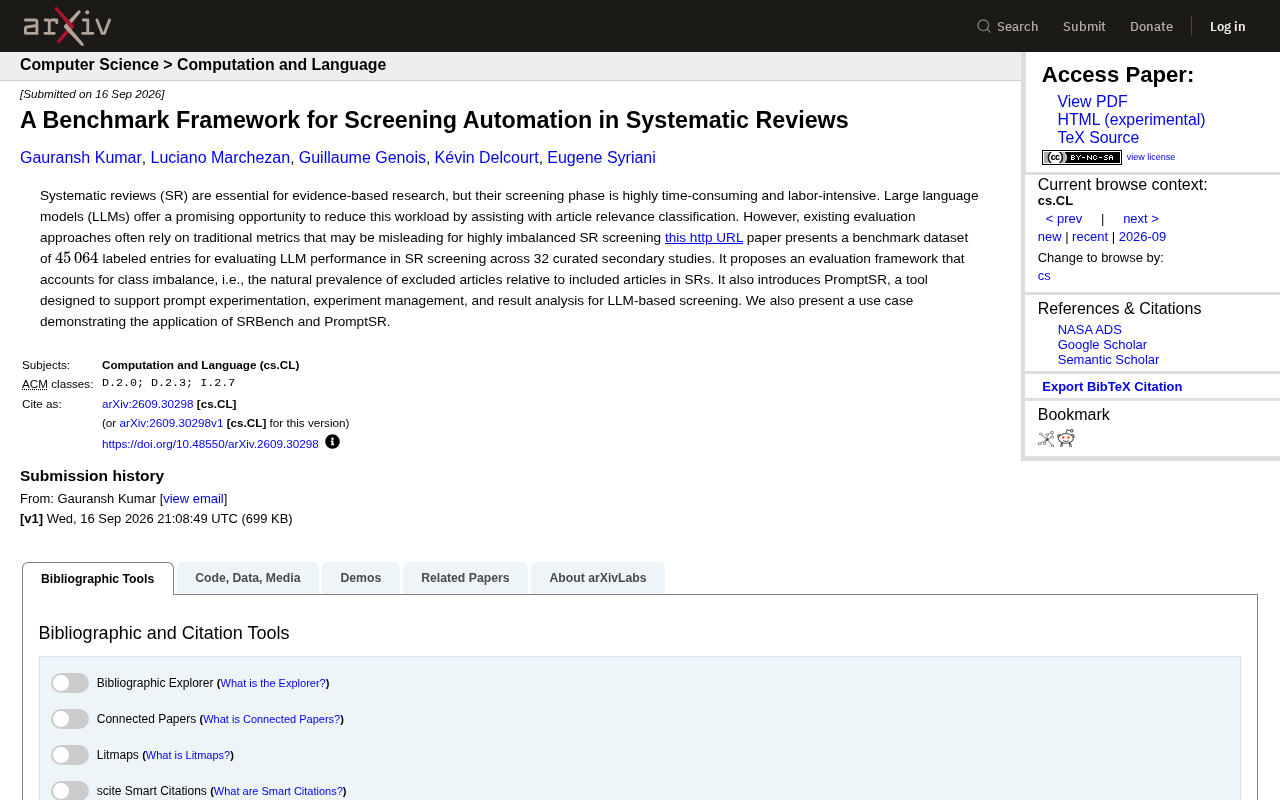
SRBench 提供统一基准与工具,解决LLM辅助系统综述筛选的评估缺失问题
系统综述的文献筛选阶段耗时耗力,大语言模型(LLM)被寄望于自动化这一流程,但长期缺乏客观统一的评估标准。论文提出 SRBench 基准框架,构建了包含 45,064 条标注条目、覆盖 32 项二次研究的数据集,并配套设计了专门应对类别不平衡问题的评估体系——避免传统准确率指标因"排除文章占绝大多数"而失真。配套工具 PromptSR 则支持提示词实验、实验管理与结果分析,推动筛选研究走向可复现、可对比的规范化路径。该框架的核心价值在于为整个领域提供共同标尺,使不同 LLM 辅助筛选方案的横向比较成为可能,从而让研究者在引入 AI 辅助时拥有更可靠的决策依据。
系统综述(Systematic Review, SR)是循证研究的基石,但其筛选阶段——从海量文献中判断哪些文章与研究问题相关——往往耗费研究者大量时间与精力。一篇新发布的论文提出了专门针对这一痛点的基准框架 SRBench,并配套发布了名为 PromptSR 的实验工具,试图系统性地评估大语言模型(LLM)在文献筛选任务中的真实表现。
筛选阶段为何是系统综述的瓶颈
在一项标准的系统综述中,研究者可能需要从数千甚至上万条检索结果中,逐条判断文章是否符合纳入标准。这项工作重复、枯燥且极易疲劳出错,是整个综述流程中最费时费力的环节之一。
大语言模型天然擅长文本理解与分类任务,因此被寄予厚望,用于辅助文章相关性判断,从而大幅压缩人工筛选的工作量。问题在于:如何客观地衡量一个 LLM 在这类任务上究竟表现如何?
论文指出,现有的评估方法大多依赖传统指标(如准确率),而这些指标在系统综述筛选这种高度类别不平衡的数据集上可能产生误导。原因很简单——在真实的综述数据中,被排除的文章数量远远多于被纳入的文章。如果一个模型只是无脑地把所有文章都判为“排除”,它在传统准确率上依然可能拿到很高的分数,但这样的模型对研究者毫无价值。
类别不平衡(class imbalance)是机器学习与自然语言处理任务中的常见挑战,指数据集中不同类别的样本数量差异悬殊。在系统综述筛选中,这一问题尤为极端:一项综述的初始检索结果中,最终被纳入的文献往往仅占总量的 1%–5%,其余均被排除。传统分类指标"准确率(accuracy)"在这种场景下严重失真——一个将所有文章判为"排除"的"懒惰模型",准确率可高达 95% 以上,却完全无法完成筛选任务。更适合此类场景的指标包括召回率(recall,衡量真正应纳入的文章有多少被正确识别)、精确率(precision)、F1 分数,以及专门权衡假阴性代价的指标如 Work Saved over Sampling(WSS)。系统综述领域普遍认为,漏掉关键文献(假阴性)的代价远高于误纳无关文献(假阳性),因此评估框架必须将召回率置于核心位置。
SRBench:4.5 万条标注数据的基准集
为了解决评估缺乏统一标准的问题,论文构建了一个包含 45,064 条标注条目 的基准数据集,覆盖 32 项经过精心整理的二次研究(secondary studies)。这一规模让评估结果具备了跨领域、跨主题的代表性,而不再依赖零散的单一案例。
更关键的是配套的评估框架。该框架专门针对类别不平衡问题设计,明确考虑了系统综述中“被排除文章相对于被纳入文章的天然高占比”这一特征。换句话说,它不再用会被极端不平衡数据欺骗的传统指标,而是让评估结果更贴近模型在实际筛选场景中的可用性。
这种设计思路抓住了 LLM 辅助筛选落地的核心矛盾:研究者最不能容忍的是漏掉本应纳入的关键文献(假阴性),而评估框架必须能真实反映模型在这方面的能力。
二次研究(secondary studies)是指以已发表的原始研究为分析对象、通过综合与归纳来得出更高层次结论的研究类型,系统综述和荟萃分析(meta-analysis)是其最典型的形式。与直接收集实验数据的"一次研究"不同,二次研究的质量高度依赖文献筛选的严格性与全面性——一旦在筛选阶段遗漏重要文献,后续所有分析结论都可能产生偏差。SRBench 选择以 32 项经过精心整理的二次研究为基础构建数据集,一方面保证了数据来源的学术规范性,另一方面也使基准覆盖了不同领域、不同筛选标准的真实场景,从而让评估结果具有跨领域的普适意义,而非仅适用于某一特定学科或研究类型。
PromptSR:面向提示工程的实验工具
除了数据与框架,论文还发布了工具 PromptSR,用于支持基于 LLM 的筛选实验。它主要提供三方面能力:
- 提示实验(prompt experimentation):方便研究者尝试不同的提示词设计,观察其对筛选效果的影响;
- 实验管理(experiment management):系统化地组织和追踪多轮实验;
- 结果分析(result analysis):对筛选输出进行结构化分析。
这体现了一个务实的判断:在 LLM 辅助任务中,提示词的设计往往对最终效果有决定性影响。一个可复现、可管理、可分析的实验工具,能让研究者从“凭感觉调提示”走向“有据可依地优化”。
论文还给出了一个应用案例,演示 SRBench 与 PromptSR 如何协同工作,为后续研究者提供了可直接参照的实践路径。
提示工程(prompt engineering)是指通过精心设计输入给大语言模型的文本指令,来引导模型产生更符合预期的输出,而无需修改模型权重。在文献筛选场景中,提示词的设计涉及多个维度:是否提供筛选标准的详细描述、是否给出示例(few-shot)、是否要求模型给出置信度或推理过程、输出格式的规范化程度等。研究表明,不同提示策略在同一模型上可能导致召回率相差超过 20 个百分点,这使得提示工程成为影响 LLM 筛选效果的关键变量。PromptSR 将这一变量纳入系统化管理,使研究者可以在受控条件下对比不同提示策略的效果,从而将"提示调优"从依赖直觉的试错过程转变为可记录、可复现的科学实验。
对循证研究自动化的意义
这项工作的价值不在于提出某个单点的高性能模型,而在于它为整个领域补上了缺失的一环——统一、可信、贴合实际的评估基础设施。
过去,各类 LLM 辅助筛选的研究很难横向比较,指标口径不一、数据规模有限、类别不平衡问题被忽视,导致结论难以推广。SRBench 提供了共同的标尺,PromptSR 提供了共同的实验平台,二者结合有望推动该方向从“各说各话”走向“可复现、可对比”的规范化研究。
对于希望在系统综述中引入 AI 辅助的团队而言,这类基准框架的出现意味着,选择和调优模型时终于有了更可靠的参考依据,而不必再担心被漂亮但失真的准确率数字误导。
相关推荐

AI智能体的真实风险:被夸大的"黑客"与被忽视的隐患
AI智能体"黑客"事件频发,但真实风险究竟是什么?本文剖析OpenAI训练暂停、DNS隧道漏洞、Meta Muse隐私泄露,以及智能体消除摩擦可能引发的银行挤兑与医疗成本上涨,提出"AI现实主义"的理性视角。

OpenAI Dev Day 全盘点:20+ 发布背后的三大趋势
OpenAI Dev Day 一次性发布 20+ 产品,涵盖个人智能体 DOTS、GPT-6.1 Sol、Decisions API、Space 协作区与模型市场。本文全面盘点并解读其揭示的三大 AI 趋势。

只想要一个自定义域名邮箱,为何如此艰难?
拥有一个自定义域名邮箱看似简单,实则涉及 SPF/DKIM/DMARC 配置、IP 信誉、托管服务成本等诸多难题。本文梳理自建与托管方案的权衡,并给出实用建议。