SSU-LSF:为地学状态空间模型打造的机器遗忘框架

SSU-LSF 提出首个专为地学 Mamba 模型设计的机器遗忘框架,高效消除灌溉、水坝调度等混杂事件对陆面预测的持续偏差。
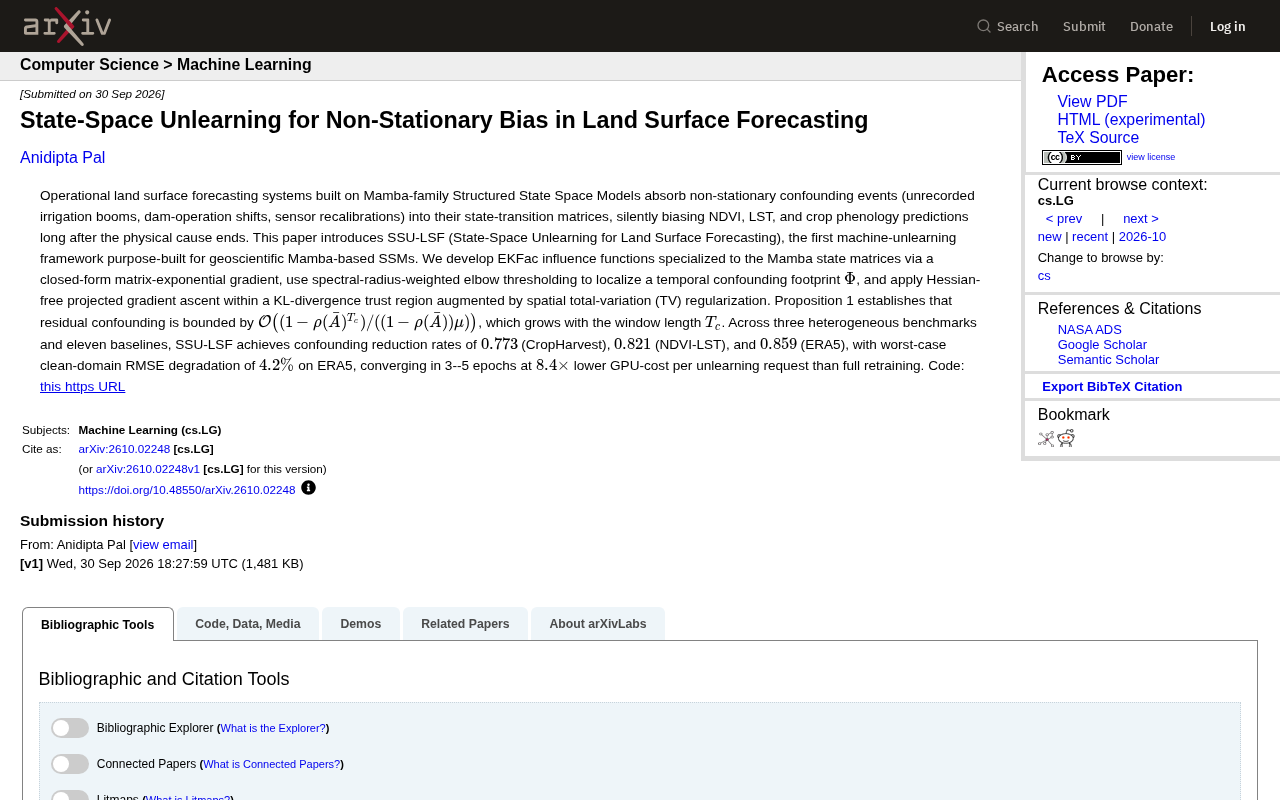
基于 Mamba 状态空间模型的陆面预测系统存在一个隐蔽缺陷:灌溉激增、水坝调度变化、传感器重新标定等非平稳混杂事件会被模型悄悄编码进状态转移矩阵,在物理事件结束后仍持续偏置 NDVI、LST 和作物物候预测,且不会触发任何报错。论文提出的 SSU-LSF 框架通过专用 EKFac 影响函数、谱半径加权拐点阈值和无 Hessian 投影梯度上升三项技术,在不重训模型的前提下外科手术式地消除这类偏差。在 CropHarvest、NDVI-LST、ERA5 三大基准上,混杂削减率达 0.773–0.859,干净域 RMSE 最坏仅退化 4.2%,且 GPU 成本比完整重训降低 8.4 倍,为业务级陆面预测系统的偏差纠正提供了一条兼具理论保证与工程可行性的新路径。
当预测模型"记住"了不该记的东西
基于 Mamba 系列结构化状态空间模型(Structured State Space Models, SSM)的陆面预测系统正在气象与农业监测领域快速普及。但这类模型存在一个隐蔽的隐患:它们会把非平稳的混杂事件悄悄吸收进自身的状态转移矩阵中。
论文列举的典型例子包括未被记录的灌溉激增、水坝调度策略的变化、以及传感器的重新标定。这些事件在物理层面可能早已结束,但模型却会在之后很长一段时间内继续受其影响,持续地给出带偏差的 NDVI(归一化植被指数)、LST(地表温度)和作物物候预测结果。
问题的关键在于"沉默"二字——这种偏差不会报错,也不易被常规评估发现,模型看起来运行正常,实则早已被历史异常事件污染。
Mamba 是 2023 年底提出的一种选择性状态空间模型(Selective SSM),其核心创新在于引入了输入依赖的选择机制(input-dependent selection),使模型能够动态决定哪些信息应当保留在状态中、哪些应当遗忘,从而在长序列建模上同时兼顾效率与表达能力。与 Transformer 的全局注意力机制不同,Mamba 的计算复杂度对序列长度是线性的,因此在处理逐小时或逐日的长跨度地表观测序列时具有明显优势。然而,这种"选择性记忆"机制恰恰是双刃剑:当训练数据中混入了非平稳的突发事件(如一次未记录的灌溉脉冲),模型的状态转移矩阵 $\bar{A}$ 会将该异常信号编码为"有价值的规律"而持续保留,在物理事件结束后仍影响后续预测,且这种污染不会触发任何显式警报。
SSU-LSF:首个面向地学 Mamba 模型的机器遗忘框架
这篇 arXiv 论文提出的 SSU-LSF(State-Space Unlearning for Land Surface Forecasting),声称是第一个专门为地学 Mamba 类 SSM 设计的机器遗忘(machine unlearning)框架。所谓机器遗忘,指的是在不从头重训模型的前提下,有针对性地"抹除"特定数据或事件对模型的影响。
相比于直接丢弃全部训练数据重新训练,机器遗忘的价值在于效率——它试图外科手术式地移除混杂因素带来的偏差,同时尽量保留模型在干净数据上的预测能力。对于运行成本高昂的业务级陆面预测系统来说,这一思路具有现实意义。
核心技术路径
SSU-LSF 的方法由几个关键组件构成:
- 专用 EKFac 影响函数:针对 Mamba 状态矩阵,通过闭式的矩阵指数梯度(closed-form matrix-exponential gradient)构建影响函数,用于量化特定事件对模型参数的贡献。
- 谱半径加权的拐点阈值法:用 spectral-radius-weighted elbow thresholding 来定位时间上的"混杂足迹" $\Phi$,也就是确定究竟哪一段时间窗口受到了污染。
- 无 Hessian 的投影梯度上升:在 KL 散度信任域内执行遗忘操作,并辅以空间全变分(TV)正则化,以保持预测结果在空间上的平滑与合理性。
论文还给出了理论保证(Proposition 1),证明残余混杂被一个与窗口长度 $T_c$ 相关的界所约束,其量级为 $\mathcal{O}\big((1-\rho(\bar{A})^{T_c})/((1-\rho(\bar{A}))\mu)\big)$——意味着污染窗口越长,可能残留的偏差上界也越大。
机器遗忘(Machine Unlearning)最初源于数据隐私领域,目标是在不重新训练模型的前提下,消除特定训练样本对模型参数的影响,以满足"被遗忘权"(Right to be Forgotten)等法规要求。其核心挑战在于:神经网络的参数是所有训练数据共同优化的结果,单独抹除某部分数据的影响在数学上等价于求解一个反向优化问题,计算代价极高。现有方法大致分为精确遗忘(exact unlearning,通过数据分片等方式保证等价于重训)和近似遗忘(approximate unlearning,通过梯度上升、影响函数等手段近似消除影响)两类。SSU-LSF 属于后者,并针对 SSM 状态矩阵的特殊结构(矩阵指数递推)定制了影响函数的计算方式,这是将机器遗忘迁移到状态空间模型时必须解决的核心工程难题。
EKFac(Extended Kronecker-Factored Approximate Curvature)是一种用于近似神经网络 Fisher 信息矩阵的方法,通过 Kronecker 积分解将原本难以直接计算的高维 Hessian 矩阵转化为两个小矩阵的乘积,大幅降低了二阶优化的计算开销。影响函数(Influence Functions)则借助这一近似曲率,估算"移除某个训练样本后模型参数会如何变化",是近似遗忘方法的理论基础。SSU-LSF 将 EKFac 扩展到 Mamba 的状态转移矩阵场景,难点在于该矩阵以矩阵指数形式出现($\bar{A} = e^{\Delta A}$),梯度计算需要用到矩阵指数的 Fréchet 导数,论文给出了闭式解以避免数值微分带来的误差积累。谱半径(spectral radius)$\rho(\bar{A})$ 是矩阵最大特征值的绝对值,它决定了状态信息在时间轴上的衰减速率——谱半径越接近 1,历史信息保留越久,混杂事件的"记忆"也就越难消除。
实验结果:三大基准上的表现
作者在三个异构基准数据集上、对比十一个基线方法进行了评估,混杂削减率(confounding reduction rate)数据如下:
- CropHarvest:0.773
- NDVI-LST:0.821
- ERA5:0.859
在削减偏差的同时,模型在干净域上的性能损失得到了控制——ERA5 上最坏情况的 RMSE 退化为 4.2%。换句话说,遗忘操作并没有以大幅牺牲正常预测精度为代价。
效率优势
从工程角度看,最吸引人的数字或许是效率表现:SSU-LSF 在 3 到 5 个 epoch 内即可收敛,每次遗忘请求的 GPU 成本比完整重训降低了 8.4 倍。对于需要频繁响应数据污染问题的业务系统而言,这一成本差距足以决定方案是否可落地。
论文代码已在 GitHub 开源(github.com/Anidipta/SSU-LSF)。
意义与局限
SSU-LSF 把机器遗忘这一近年来主要在隐私合规、版权删除等场景讨论的技术,迁移到了地学时序预测这个相对冷门但高价值的领域,填补了 Mamba 类 SSM 在偏差纠正方面的空白。
不过需要客观看待:这仍是一篇预印本论文,混杂削减率在 0.77–0.86 之间,意味着仍有相当比例的混杂影响未被完全消除;理论界也表明长窗口污染的处理难度更大。该方法在真实业务环境中的鲁棒性、以及对不同类型混杂事件的泛化能力,仍有待进一步验证。
对于关注遥感、气候建模和状态空间模型的研究者与工程师来说,这项工作提供了一个值得跟进的新方向——如何让高效的序列模型不仅学得快,也能"忘得准"。
相关推荐

苹果iPhone Duo折叠屏开箱:万元级新物种值不值?
苹果首款折叠屏iPhone Duo开箱上手:顶配近5000加元,哑光内屏成最大亮点,折痕控制出色,护照式宽矮比例引领新形态。本文梳理屏幕、铰链、手感和价格的完整体验。
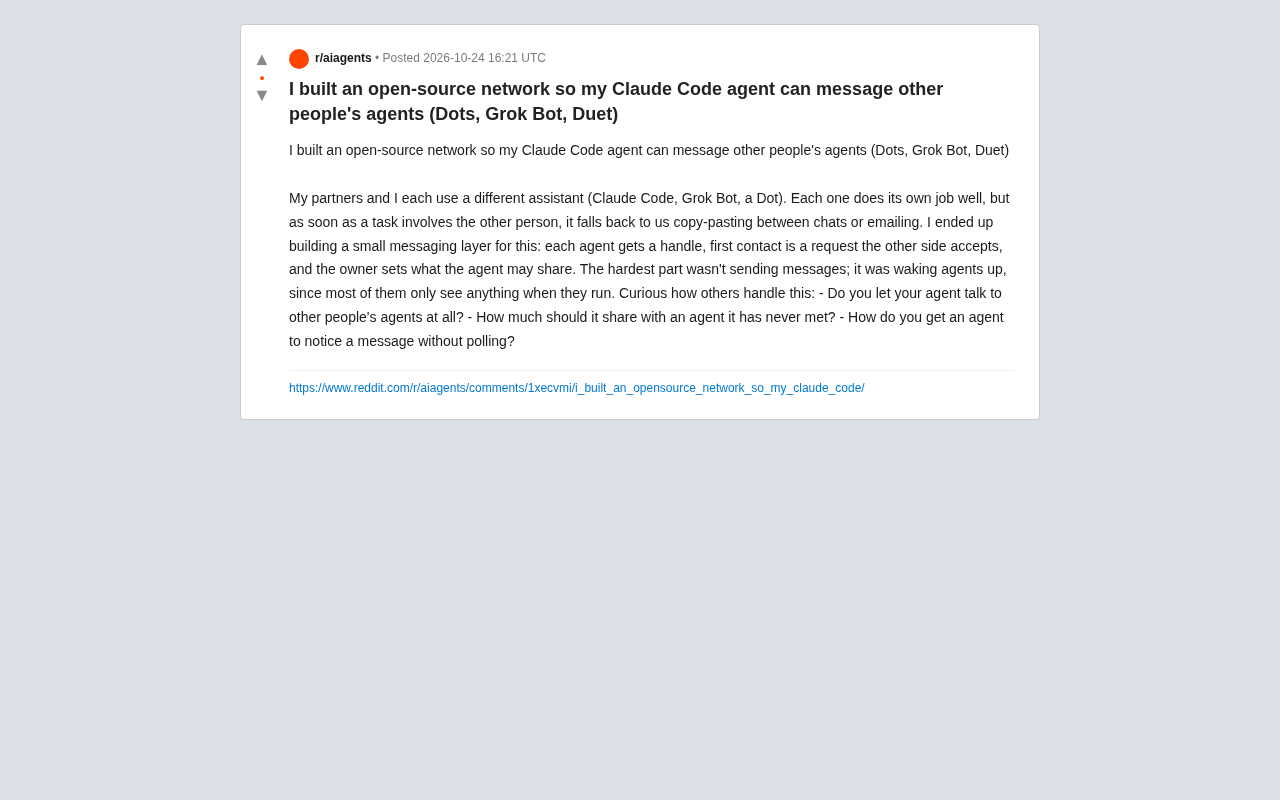
开源智能体消息网络:让Claude Code与其他AI助手直接对话
开发者构建开源消息层,让Claude Code、Grok Bot等AI智能体直接通信。项目采用句柄与握手机制控制权限,但唤醒休眠智能体成为最大技术挑战。探讨智能体互操作性的未来与信任边界。

告别上下文大杂烩:多智能体管道如何严格界定状态与交接
多智能体管道中上下文大杂烩导致状态膨胀和交接模糊。本文基于Reddit讨论,总结显式输入输出模式、不可变状态、分层状态等严格界定状态与交接的工程实践,并分析交接协议设计中的关键取舍。