StepBack:步骤级错误定位重采样,推理token省41%

StepBack通过步骤级首错定位与局部重采样,在匹配自洽性准确率的同时最多节省41.26%的token。
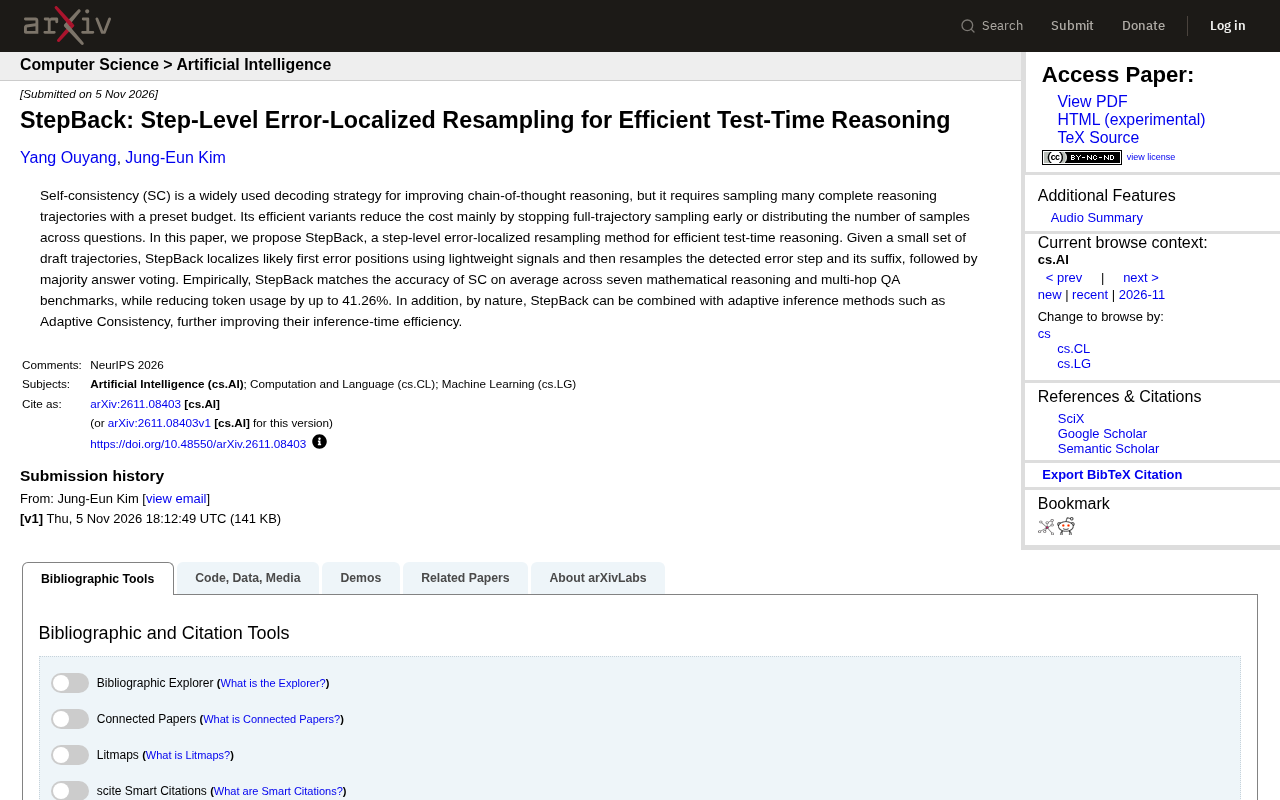
StepBack是一种面向测试时推理的高效方法,旨在解决自洽性(SC)多次完整采样导致token开销过大的问题。其核心流程分三步:先采样一小组草稿轨迹,用轻量信号定位每条轨迹中最可能的首个错误步骤;然后仅重采样该错误步骤及其后续后缀,保留正确前缀;最后对候选答案进行多数投票。在七个数学推理和多跳问答基准上,StepBack的平均准确率与SC相当,token使用量最多降低41.26%。与早停、自适应采样等高效变体不同,它利用轨迹内部的错误结构进行细粒度资源分配,并可与Adaptive Consistency等方法叠加使用。其效果依赖首错定位精度,目前验证集中于数学推理与多跳QA。
链式思维(Chain-of-Thought)推理让大模型在复杂问题上表现更好,但代价是推理成本飙升。自洽性(Self-consistency, SC)通过多次采样完整推理轨迹并投票来提升准确率,却需要预设较大的采样预算。如何在保持准确率的同时降低token开销,是测试时推理(test-time reasoning)的核心效率问题。近期一篇题为《StepBack: Step-Level Error-Localized Resampling for Efficient Test-Time Reasoning》的论文提出了一种步骤级错误定位重采样方法,在多个基准上匹配SC的平均准确率,同时将token使用量最多减少41.26%。
现有高效推理方案的局限
自洽性方法之所以昂贵,在于它对每条候选轨迹都完整采样到底。已有的一些高效变体主要从两个角度降低成本:一是提前终止整条轨迹的采样(early stopping),二是根据问题难度自适应分配采样数量。这些方法减少的是“采样多少条”或“采样多长”,但对轨迹内部的错误结构缺乏针对性利用。
换句话说,当一条推理轨迹在中间某一步走错时,后续步骤往往已经偏离正确答案,完整采样这条轨迹的剩余部分是一种浪费。StepBack的出发点正是这一点:与其整条重采样,不如先定位最可能出错的那一步,从那里重新采样。
自洽性(Self-consistency)本身是一种无需额外训练、仅靠推理阶段多次采样并投票的集成策略,其准确率增益随采样数量增加而趋于饱和。这意味着在采样预算达到某一临界点后,继续增加完整轨迹的边际收益迅速下降,而token成本却线性上升。早停(early stopping)策略通常设定置信度阈值或最大步数,一旦某条轨迹的中间答案稳定便提前截断;自适应采样则依据题目难度或模型不确定性动态决定采样条数。两类方法都作用于轨迹的外部维度,未深入轨迹内部逐步审视错误分布。StepBack的切入角度正是填补这一空白:它把轨迹视为可分解的步骤序列,利用步骤间的因果依赖关系,只对错误发生之后的后缀进行重生成,从而在保持前缀正确性的前提下修正结果。
StepBack的核心机制
StepBack的流程可以拆解为三个环节。
1. 用小规模草稿轨迹定位首错位置
方法首先采样一小组草稿轨迹(a small set of draft trajectories),然后利用轻量级信号(lightweight signals)在每条轨迹中定位最可能的“首个错误位置”。这一步不需要额外的重型模型或完整验证,成本较低,目的是找出最值得修复的步骤。
“首个错误位置”的定位依赖轻量级信号,这类信号通常包括步骤级对数概率、草稿轨迹之间的答案一致性、步骤间语义连贯性打分,或对中间结论进行快速校验的规则/小模型。其共同特点是计算开销远低于完整重采样或调用大型验证器。定位首错而非任意错误,是因为推理链存在误差累积效应:首个错误步骤之后的所有内容都建立在该错误前提上,修复后续步骤而保留错误前缀通常无法纠正最终答案。因此,首错定位把重采样范围收缩到最小必要后缀,既避免从头生成,也避免在多个错误点之间反复修补。草稿轨迹的规模较小,也使得定位阶段本身的token成本可控,不会抵消后续节省。
2. 重采样错误步骤及其后缀
定位到错误步骤后,StepBack只重新采样该步骤及其后续后缀(suffix),而不是从头生成整条轨迹。这样,前缀部分的正确推理被保留下来,token开销集中在真正需要修正的部分。
3. 多数答案投票
经过重采样后,方法对候选答案进行多数投票(majority answer voting),沿用自洽性的聚合思路,但参与投票的轨迹经过了错误定位与局部修复。
这种“先定位、再局部重采样”的设计,使计算资源从全轨迹铺开转向错误密集区域,这是它区别于early stopping和样本分配策略的关键。
多数投票是自洽性的聚合核心,其有效性依赖于候选答案的多样性。在StepBack中,参与投票的轨迹并非全部独立完整采样,而是由“原始草稿轨迹”与“错误步骤后缀重采样后的修复轨迹”混合构成。这带来一个值得注意的权衡:修复轨迹之间可能共享相同的前缀,导致答案多样性低于完全独立采样,从而削弱投票的纠错能力。StepBack通过保留多条草稿轨迹并分别定位、重采样来维持一定多样性。此外,投票通常只对最终答案字符串进行,不涉及推理路径的合并,因此聚合成本很低,不会成为新的开销瓶颈。
实验效果:匹配SC准确率,token省41.26%
论文在七个数学推理和多跳问答(multi-hop QA)基准上进行了评估。结果显示,StepBack在平均准确率上与自洽性方法相当(matches the accuracy of SC on average),同时将token使用量最多降低41.26%。
这一结果的意义在于:效率提升并非以牺牲准确率为代价,而是在同等准确率水平下减少了推理开销。对于需要大规模部署推理模型的场景,这类节省会直接反映在成本上。
可与自适应推理方法叠加
论文还指出,StepBack在性质上可以与自适应推理方法(如Adaptive Consistency)结合使用,进一步提升推理时的效率。这意味着它不是一个孤立的替代方案,而更像是一个可以嵌入现有高效推理流水线的组件——自适应方法负责决定“采多少”,StepBack负责决定“从哪里重采”。
实践启示
从工程视角看,StepBack的价值在于把推理预算花在刀刃上。传统自洽性的冗余主要来自完整轨迹的重复采样,而步骤级错误定位提供了一种更细粒度的资源分配方式。对于推理链较长、单步错误代价高的数学与多跳问答任务,这种思路尤其契合。
当然,方法的效果依赖于轻量信号对首错位置的定位精度;定位不准时,重采样可能落在错误的前缀上。论文的实验覆盖了数学推理和多跳QA两类任务,其他推理形态下的表现仍需更多验证。但就现有结果而言,StepBack为测试时推理的效率优化提供了一个值得关注的方向:不是少采样,而是聪明地重采样。
相关推荐
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。

Commodore 64经典赛车游戏迎来Driver AI
探索Commodore 64经典赛车游戏《Stunt Car Racer》中的Driver AI实验,了解在资源受限的8位平台上实现自动驾驶AI的技术挑战与启示。

黄仁勋若被替换,开源AI会否生变?Reddit激辩
Reddit网友激辩:如果黄仁勋被替换,英伟达会反对开源AI吗?讨论指出英伟达支持开源AI源于商业利益,需拓宽GPU客户群,而非一人决策。