Stockfish找漏着, Gemma 4讲给孩子听: 代码校验每个字
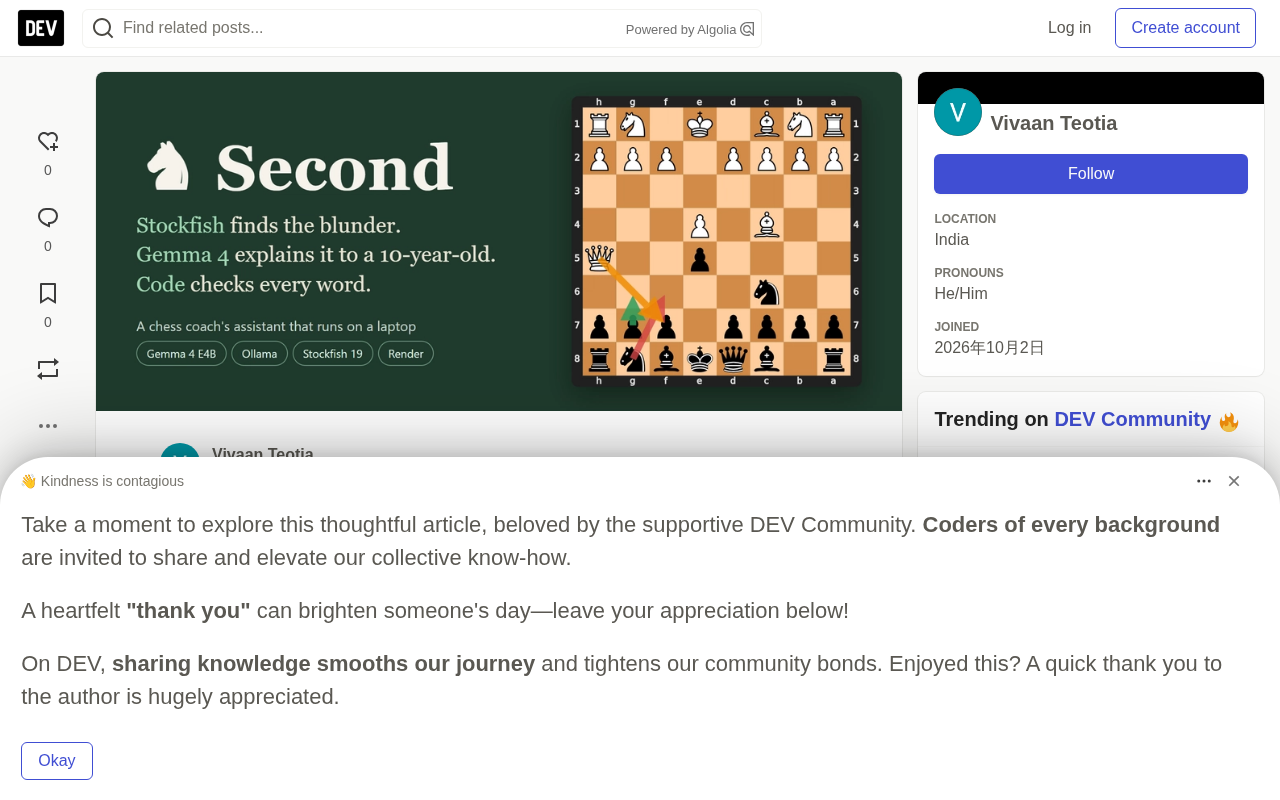
把象棋判断交给引擎、措辞交给小模型、正确性交给校验器,4B 模型也能写出可靠点评。
开源项目 Second 用一组对比实验说明:裸 Gemma 4 E4B 在 29 个真实失误中 0 次说中 Stockfish 首选着法,还 7 次给出不合法的走法、18 次做出引擎未确认的断言。它的解法是把职责拆开——Stockfish 以 depth 14 分析局面,python-chess 把结果整理成结构化“事实清单”,Gemma 只在这份清单范围内组织语言,最后由纯 Python 校验器逐条核对棋子、格子、杀法与战术名词,不合格就打回重写,三次失败退回模板文本。喂入事实后,同一模型 29/29 说中正确着法。整套系统在无独显的笔记本上约 90 秒完成一盘复盘,面向印度象棋教练,以 GPL 自托管加低价增值服务变现。
当大模型当不好象棋教练
把一局棋丢给聊天机器人,让它解释学生哪里下错了——这大概是很多棋类教练和家长的朴素想法。但开源项目 Second 的作者做了一组对比实验,结果相当扫兴:给 Gemma 4 E4B 一段关于某个失误的事实,让它写教练点评,它把最简单的初学者杀局说成"后翼底线陷阱",还凭空捏造了一个"发现攻击"。
这不是聊天窗口里的无害错误。它会印在一张纸上,交给一个十岁孩子,而这个孩子的父母正在为"准确性"付费。
Second 的解法很干脆:语言模型只负责写字,所有象棋判断交给代码。 Stockfish 算出事实,python-chess 把事实翻译成自然语言句子,Gemma 只在这些句子的范围内组织措辞,最后一层纯 Python 写的校验器逐条核对——每个棋子、每个格子、每个"N 步杀"、每个战术名词,都必须能在事实表里找到出处。
事实与措辞的分工
流水线是这样的:PGN 或 Lichess/Chess.com 用户名进来,Stockfish 以 depth 14 分析每个局面,python-chess 判断实际发生了什么——哪个子无人保护、被谁攻击、对手最佳应手是什么、是否构成叉子、是否有强制将杀、更好的那步能白吃多少子。这些被写成一份"事实清单",例如:
走了 19. Rxe5(失误)。走后你的 d6 后正被 g6 后攻击,且无人防守。对手最佳应手是 Qxd6。更好的走法是 Qxe7,白吃对方 e7 马。
Gemma 拿到的就是这份东西,写标题、两三句解释、一个引导学生自己找答案的提问、一条经验法则,再加上总结、作业和一段给家长的话。校验器随后登场:战术词汇(fork、pin、sacrifice、back rank 等)只有在事实里出现过才被允许;"你丢了后""f4 的马悬着"这类断言必须对应事实中确实丢失或无人保护的棋子;给家长的段落不能出现棋谱记号,如果指定印地语就必须真的是天城文。任何一条不过,Gemma 会收到具体的错误清单重写;三次失败后,系统退回到直接由事实拼装的中性文本。
这套设计的成本几乎为零,因为所有模型都跑在教练自己的笔记本上。
Stockfish 是目前公认最强的开源国际象棋引擎,采用 NNUE(高效更新神经网络)评估局面,UCI 协议是它与外部程序通信的标准接口。depth 14 指搜索树深度约为 14 层半回合,对业余对局复盘而言是精度与耗时的平衡点:深度过低会漏掉战术,过高则在普通笔记本上耗时剧增。
PGN(Portable Game Notation)是记录整盘棋着法的纯文本标准格式,绝大多数棋类网站都支持导出;Lichess 与 Chess.com 则提供 API,可按用户名批量拉取学生的历史对局。python-chess 是 Python 生态中最成熟的棋类库,负责合法性校验、局面推演与着法生成——文中“判断哪个子无人保护、是否构成叉子”等逻辑,正是建立在这些底层能力之上。
29 个真实失误给出的数字
作者从 Lichess 开放数据库(CC0)抽取 16 盘 1000 到 1700 分段的真实对局,取每方最大的失误,共 29 个时刻,用同一台机器、同一个模型做三种方式的对比:
| 指标 | 裸 Gemma | Gemma + 事实 | Second(含校验) |
|---|---|---|---|
| 给出具体着法 | 14/29 | 29/29 | 29/29 |
| 说中 Stockfish 首选替代着 | 0/29 | 29/29 | 29/29 |
| 提到棋盘上不合法的着法 | 7/29 | 0/29 | 0/29 |
| 做出引擎未确认的断言 | 18/29 | 0/29 | 0/29 |
一个 4B 模型单靠自己,29 次里没有一次说中引擎的首选着法,还有 7 次提了根本不存在的走法。而一旦把结构化事实喂进去,它 29 次全中。
作者自己也承认,这个结果让他意外:真正干活的是事实清单,不是模型。在测试中,Gemma 带事实的第一版回答全部通过了校验器,校验层一次都没被触发。他仍然保留它——"安全带是给接地失效的那天准备的",也让他可以说"不会有编造内容到达学生手里",而不是"大概不会"。
4B 模型在普通笔记本上跑起来
硬件是一台 Intel Core Ultra 5、16GB 内存、无独显的笔记本,跑 Ollama 里的 gemma4:e4b-it-qat(6.1GB)。默认情况下 Ollama 忽略核显,设置 OLLAMA_IGPU_ENABLE=1 打开 Vulkan 后,prompt 处理速度从约 31 tokens/s 提升到约 315 tokens/s。整盘棋的复盘约 90 秒,其中 Stockfish 约 20 秒,每条点评约 12 秒。一次完整复盘消耗 2000 到 3000 个 prompt token、约 550 个输出 token,全部免费。
公开演示部署在 Render 免费层,内存装不下 Gemma,于是容器内跑 Stockfish,点评交给 Google AI Studio 上的 Gemma 4 26B A4B。因为同属一个开放模型家族,prompt、校验器和模型行为保持一致,只是权重跑在哪里不同。21 步的对局不到 30 秒返回,所有点评首轮通过校验。
Ollama 是本地运行开源大模型的常用工具,默认只使用 CPU,因为它不易判断集成显卡的可用性;设置 OLLAMA_IGPU_ENABLE=1 后会通过 Vulkan 计算接口把推理负载分给核显。Vulkan 是跨厂商的图形与通用计算 API,Intel、AMD 的核显都能受益。模型名中的 qat 指 Quantization-Aware Training(量化感知训练),在训练阶段就模拟低精度运算,使模型量化到 4 位后精度损失更小,因此 4B 参数模型只占约 6.1GB 内存。
prompt token 与输出 token 的区分很关键:prompt 处理是并行可批量的,输出则是逐 token 串行生成,所以打开核显后 prompt 速度提升近十倍,而每条点评仍约需 12 秒。Gemma 4 26B A4B 中的 A4B 指 MoE(混合专家)架构下每个 token 仅激活约 4B 参数,因此大模型也能保持较低推理成本。
一个被刻意做窄的产品
目标用户很具体:印度的国际象棋教练。Gukesh 拿下世界冠军后,当地象棋培训爆发,大量教练是业余强手和兼职的大学生——这本身就是一个副业市场。课程是收费的,课后那部分不是:翻看每个学生的棋、找转折点、写一段孩子和家长都愿意读的东西。20 个学生每周各下两盘,就是 40 盘棋;每盘 5 分钟,每周超过 3 小时的无偿劳动。
Second 把这 40 盘变成笔记本上的后台任务。产品定位是 GPL 开源、可永久自托管,付费的是教练不想自己做的部分:一键安装、打印件上的棋院名字、每周自动导入学生网棋、技术支持,定价约每月 299 卢比(约 3.15 美元)。这个价格成立的前提是边际成本为零——模型跑在教练自己的机器上,第 40 盘棋和第 1 盘棋一样不花钱,也不需要账号、API key 或国际信用卡。
数据合规是另一层考虑。学生是未成年人,印度《2023 年数字个人数据保护法》对儿童数据有额外要求,包括可验证的家长同意。本地运行意味着棋谱和姓名不出机器,没有第三方处理者,没有跨境传输,也不需要向家长额外解释什么。加上比赛场馆常年 Wi-Fi 糟糕,离线可用不是噱头。
许可层面,Gemma 4 采用 Apache 2.0,可以合法构建付费产品;同一套 prompt 可以跑在笔记本的 Gemma、Ollama Cloud 或 Google AI Studio 上,机器升级就换更大的模型。评测之所以能做,是因为 Lichess 数据库是 CC0,每一条点评和每一个分数都公开在 eval/results.json 里,并能链接回原始对局。
印度《2023 年数字个人数据保护法》(DPDP Act)将 18 岁以下用户的数据列为儿童数据,处理前须取得可验证的家长同意,并禁止针对儿童的行为追踪与定向广告。对教育类工具而言,这意味着若把学生棋谱与姓名上传到第三方云服务,教练就可能成为数据处理者,需承担告知、同意留存与安全义务;而数据完全留在本地机器上时,这些义务大幅简化。
GPL(GNU 通用公共许可证)要求分发衍生作品时公开源代码,这与“可永久自托管”的定位相配,但并不意味着不能收费——收费对象是安装、运维与支持等服务,而非软件许可本身。Apache 2.0 则更为宽松,允许闭源分发与商业使用,只需保留版权与许可声明,这正是能用 Gemma 构建付费产品的法律前提。
几个值得抄走的提示词教训
- 告诉模型什么最重要。 早期点评全部正确、全部寡淡("小心大失误!")。有一局事实里写着即将出现 Nxc2+ 的马叉,同时攻击王和车,Gemma 却在讲 c2 兵。修复方式是让代码为每个时刻挑一条 KEY FACT,并要求解释以它开头。
- 说清楚读者是谁。 第一版印地语家长信开头是"प्रिय Aarav"——写给了孩子。现在 prompt 明确要求写给家长、用第三人称提孩子,并指出本周练一件事。
- 干脆不要把孩子的名字给模型。 Gemma 写
[STUDENT],Second 事后替换。本地跑无所谓,但这意味着托管演示从不把儿童姓名发给任何人。
校验器自己一开始也有 bug。首个样本局它报告"抓到 4 处编造细节",作者逐条核对,发现全是自己的问题:总结里说学生"第 5 步易位"、准确率"75.1%",两条都真实存在于给 Gemma 的事实表中,只是总结校验器只认识关键时刻。更糟的是,整个总结因此退回英文模板,而家长要的是印地语。修复有两条:总结对照实际展示给模型的那份事实表校验;回退按字段进行,只有坏掉的那一句被替换。
开源拼图与一个诚实的边界
Second 的立论是:难的部分早已开源。世界上最强的象棋引擎 Stockfish 是自由软件,一个 4B 语言模型不会下棋,也不需要会——象棋分析已经被开源解决了,模型只需要会说话。这个项目本质上是两个开源项目之间的一层薄胶水。
产品验证目前还很初步。第一位用户是作者一位棋力不错的朋友,试用后觉得"给教练用相当可以"。作者自己没有把这句话当成精度评审,只当作第一个来自构建过程之外的正向反馈。下一步是把工具放进教练的每周routine:复盘学生的棋、在课上用那些提问、看哪一部分真正省下了备课时间。在那之前,259 卢比的付费方案还只是一个提案。
对于想把大模型塞进教育场景的开发者,这个项目的价值不在于象棋。它示范了一种分工:确定性交给代码和引擎,表达交给语言模型,正确性交给一个能说"不"的校验层——以及一个反直觉的发现,当事实足够好时,4B 模型的表现可以比你以为的更可靠。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。