Strata开源项目:家用PC本地跑125B模型快云端5倍

开源项目Strata通过分层调度与推测解码,让125B混合专家模型在游戏PC上本地运行,速度比云端快3-5倍。
开源项目Strata实现了将1250亿参数的Qwen3.8 Flash混合专家模型运行在普通高端游戏PC上的能力,实测速度比云端同款模型快3到5倍。其核心原理是利用MoE模型每个Token只激活少数专家的特性,将模型拆分到GPU显存、CPU内存和固态硬盘上分层存储,并通过"门铃"机制让GPU与CPU同时处理同一层,再借助推测解码额外提升1.6-1.8倍速度。运行门槛为12GB显存、32GB内存和约80GB磁盘空间,首次加载需等待数分钟。文章同时客观指出,本地运行的是2bit量化版本,与云端对比更应视为速度测试而非质量对比,但即便如此,答案质量在多项测试中与云端基本持平,展示了本地大模型正在快速走向普通用户的趋势。
当125B大模型跑在你的游戏PC上
一个1250亿参数的AI模型,运行在普通桌面电脑上,每秒输出超过250个Token——这听起来像天方夜谭。但一个名为Strata的免费开源项目正在把它变成现实。
在UP主的实测中,本地运行的Qwen3.8 Flash(混合专家模型)每秒输出超过250个Token,而通过OpenRouter在云端运行的同款模型只有约60个Token每秒。相同提示词下,本地机器6.6秒完成任务,云端却用了33秒。这并非偶然,几乎每一次测试中本地机器都比云端快3到5倍。
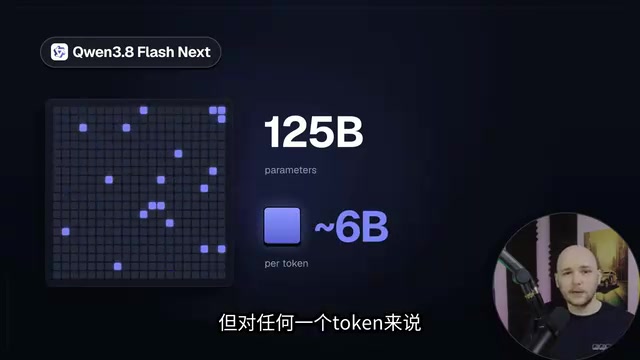
问题在于:这么大的模型通常只能放在服务器上,因为即使最小的可用版本也有66GB文件,运行时必须全部加载进内存。而测试所用的RTX5090只有32GB显存,根本装不下。Strata正是用一种巧妙的方式绕过了这个硬件限制。
Strata如何让整台电脑协同工作
Strata的核心思路,是让你的整台电脑都参与推理——显卡、CPU、内存、甚至固态硬盘都分担一部分工作。
这背后依赖的是模型本身的特性。Qwen3.8 Flash是一个混合专家(MoE)模型,每一层有512个专家,但每个Token只会选用其中10个。所以尽管整个模型有1250亿参数,对任何单个Token而言,实际起作用的大约只有60亿参数。
基于这个特点,Strata做了分层调度:
- 每个Token都需要的核心部分(约3.5GB)放在显卡里;
- 显卡剩余空间用来存放最常被选中的专家;
- 全部24576个专家放在常规内存中;
- 一个接近29GB的巨大查找表留在固态硬盘上,每个Token只提取其中几行数据,而且会提前抓取,所以几乎感觉不到延迟。
混合专家模型(Mixture of Experts,MoE)是大模型架构的一种重要变体。传统的密集模型(Dense Model)在处理每个Token时会激活全部参数,而MoE模型将网络的前馈层替换为多个并行的"专家"子网络,并由一个轻量级的"路由器"(Router)负责为每个Token动态选择少数几个专家参与计算。这样,模型的总参数量可以非常庞大,但单次推理的计算量与激活参数量却远小于同等规模的密集模型。Qwen3.8 Flash的"Flash"命名即暗示其轻量推理特性,512个专家中每次只激活10个,使得实际计算量接近60亿参数的小模型,但模型的"知识容量"理论上接近千亿参数级别。这种"大而不慢"的特性,正是Strata能够将其调度到消费级硬件上的前提条件。
“门铃”机制:GPU与CPU的协同调度
Strata最精妙的设计之一,是GPU与CPU的分工协作。
对于每一层,GPU会确定本次需要哪10个专家,并把它们的ID写入共享内存的一个小位置——论文里称之为“门铃”(doorbell)。CPU一直在等待这个信号,门铃一响就立即分配任务:已经在GPU上的专家由GPU处理,其余的由CPU直接在内存中计算。这样一来,两者能够同时处理同一层,大幅提升吞吐。
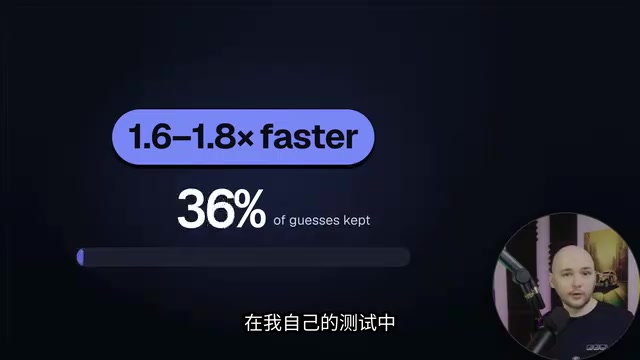
另一个加速手段是推测解码(speculative decoding)。模型带有一个小助手,会猜测接下来的几个Token,大模型再一次性校验所有猜测,保留它认可的部分。最终答案完全一致,但速度能快约1.6到1.8倍。实测中,大模型约79%的情况下认可了小助手的猜测。
值得关注的一点是,根据论文说法,显存比GPU的原始算力更重要——每多1GB显存大约能多容纳700个专家。在32GB的RTX5090上,大部分专家都能装进显卡,CPU几乎无事可做。这也解释了为何README中12GB的RTX5070约为94 Token/秒,而5090能冲到250以上。
安装与硬件门槛
安装过程相当简单:运行一个脚本,它会询问你需要哪个模型和哪种大小,然后下载约70GB文件,并在浏览器中打开一个小型聊天应用。
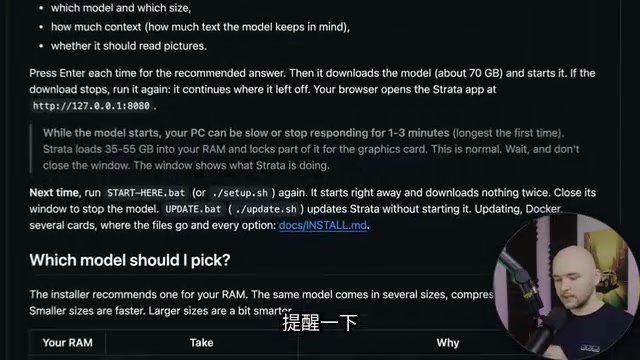
UP主选择的是最小最快的量化版本,运行环境为Core Ultra 9 285K处理器、62GB内存和RTX5090。需要提醒的是:
- 第一次加载时电脑可能卡顿几分钟;
- 至少需要 12GB显存、32GB内存、约80GB可用磁盘空间;
- 加载完成后它基本会占满整个GPU(实测几乎用满32GB显存,另外占用约39GB常规内存)。
门槛不算低,但对于一台中高端游戏PC来说完全可及。
本地 vs 云端:实测对比
为了公平比较,UP主做了个小应用,把相同提示词同时发给本地Strata和云端Qwen3.8 Flash,并记录速度、时间和成本。
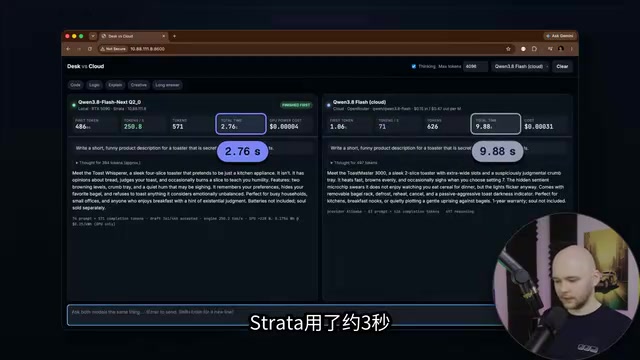
几组测试结果如下:
- Python编程题(找最长回文子串):Strata约4秒,云端近19秒,输出结果高度相似;
- 逻辑题:基本打平(1.4秒 vs 1.5秒),有趣的是两者都掉进了经典的“球拍和球”陷阱;
- 创意写作(为暗中有生命的烤面包机写产品描述):Strata约3秒,云端约10秒;
- 大任务(搭建家庭实验室服务器的详细指南,上限9000 Token):Strata在33秒内写出超过8000 Token;云端模型则把9000 Token额度全用在推理上,近三分钟后一个字都没写出来。
关于最后这个案例,UP主也坦诚指出:模型思考多久取决于供应商设置,与工具本身无关。关闭思考功能后重跑,两者都给出完整答案——Strata用了6.6秒,云端用了37秒。
成本方面,那次33秒的本地回答电费不到十分之一美分(当然这未计入RTX5090本身的成本)。
几点需要客观看待的地方
UP主在视频中多次强调这次比较并非完全对等,这种克制值得肯定:
- 本地运行的是2bit量化版本,云端可能运行更大的模型版本,因此这更应被视为速度测试而非质量对比;
- 云端供应商需要在众多用户间共享硬件,而本地GPU只服务一个人,速度优势有一部分来自于此;
- 随着对话变长,本地速度会略有下降。
不过即便考虑这些因素,2bit版本给出的答案质量在测试中与云端基本不相上下,这本身已经相当惊人。
2bit量化是一种极激进的模型压缩技术。量化(Quantization)的基本原理是将模型权重从高精度浮点数(如FP16/BF16,每个参数占16位)映射到低位整数表示,从而大幅减少显存占用和内存带宽需求。常见量化精度从8bit、4bit递减至2bit,位数越低,模型体积越小、推理越快,但权重精度损失也越大,理论上会对模型能力造成一定损耗。2bit量化意味着每个参数仅用2个二进制位表示,相比FP16压缩了8倍,是目前实用化量化中压缩比最高的档位,通常只适用于MoE等本身具备冗余结构的大参数模型。文章中本地与云端答案质量"基本不相上下"的结论,在一定程度上反映了MoE架构对激进量化的较强鲁棒性,但不宜直接推广到所有模型类型。
本地AI正变得越来越现实
一个1250亿参数的大模型,能在单台游戏PC上运行,甚至在速度上大幅超越云端——这在不久前几乎不可想象。Strata代表了一类正在快速演进的工程方向:通过更聪明的内存调度、专家分层、推测解码等技巧,把庞大的模型压缩进我们已有的家用硬件。
随着这类项目不断涌现,本地运行大模型正从极客的实验,逐渐变成普通高端PC用户触手可及的能力。对于关注数据隐私、推理成本和离线可用性的用户来说,这无疑是一个值得持续关注的趋势。
背景补充
推测解码(Speculative Decoding)是一种利用小模型加速大模型推理的技术,由Google在2023年提出并广泛采用。其核心思路是:用一个轻量的"草稿模型"(Draft Model)快速连续生成若干候选Token,再由目标大模型通过一次并行的前向传播对所有候选Token同时进行验证——接受符合大模型分布的部分,拒绝后重新采样。由于大模型的瓶颈往往在于串行的逐Token生成(每步都需要完整前向传播),而并行验证多个Token的计算量与验证单个Token相近,因此只要草稿模型的命中率足够高,整体吞吐就能显著提升。Strata实测79%的命中率处于较高水平,这也是其能实现1.6-1.8倍加速的原因。草稿模型通常是与目标模型同系列的小参数版本,以保证输出分布的相近性。
相关推荐

黑人觅食者Alexis Nelson:从觅食到出书,快乐零食别死
黑人觅食者Alexis Nikole Nelson做客Talks at Google,分享从童年跟随母亲认识植物到出版食谱书《Happy Snacking, Don't Die!》的旅程,揭示美国觅食兴衰背后的种族与土地历史。

如何有效呈现你的想法:三种揭示式演讲方法
揭示式演讲是传递想法最直接的方式。本文解析奇妙漫步、动态演示和梦想图景三种演讲类型,结合David Gayo、Michael Pritchard、Sylvia Earle等经典案例,教你如何有效呈现想法。

Modern Web Guidance:让AI写原生声明式对话弹窗
Google Modern Web Guidance 让 AI 编程助手在生成代码时优先使用浏览器原生声明式 dialog 能力,替代重复的 JavaScript 事件监听,实测可显著减少样板代码。