溯源闸门:AI Agent记忆写入必须带来源

AI Agent记忆溯源闸门:无来源声明隔离,红队30攻全拦。
大多数AI Agent记忆系统默认信任Agent写入的任何内容,导致无法区分客户亲述与模型编造。Retailbox Automation创始人Mikhail Oskola在hackathon项目FleetMemory中实现“溯源闸门”——Agent可提议事实,但必须指明来源,否则写入被隔离。闸门执行垃圾重复、矛盾、置信度底线和溯源四类检查。首版红队测试中,无来源的新颖声明6/6通过;修复规则needs_provenance后,30次攻击全部拦截,同时仍通过9/10合法客户更新。被隔离声明由默认拒绝的对抗性验证器裁决,结果与理由写入决策日志,被覆盖事实保留并标记无效,系统可回溯任意历史日期的信念状态。与RAG引用不同,溯源闸门作用于管道更早阶段,决定声明是否有资格成为持久事实。项目还发现并修复了LangChain检查点在CockroachDB上的问题,由社区贡献者独立验证。
大多数AI Agent记忆系统默认信任Agent写入的任何内容——这正是问题所在。Agent凭上下文推断出一个数字,用十足的信心写进记忆,一个月后你再也分不清这条信息是客户亲口说的,还是模型自己编的。Retailbox Automation创始人Mikhail Oskola在hackathon项目FleetMemory中实现了一套"溯源闸门",然后亲自攻击自己的系统,发现第一版6次攻击全部被攻破,修复后30次攻击全部拦截。
什么是溯源闸门
溯源闸门是横在AI Agent记忆前面的一条规则:Agent可以提议一条事实,但除非它指明这条事实来自哪里,否则不能写入记忆。没有来源,就不允许写入。
这条检查不比较数值真伪,只看有没有引用来源。客户说"我们的预算现在是14000美元",这是有来源的,可以覆盖旧值。Agent从对话上下文里推断出一个预算数字,背后没有任何人真正说过这句话,这就没有来源,这条声明会被隔离而非直接写入。
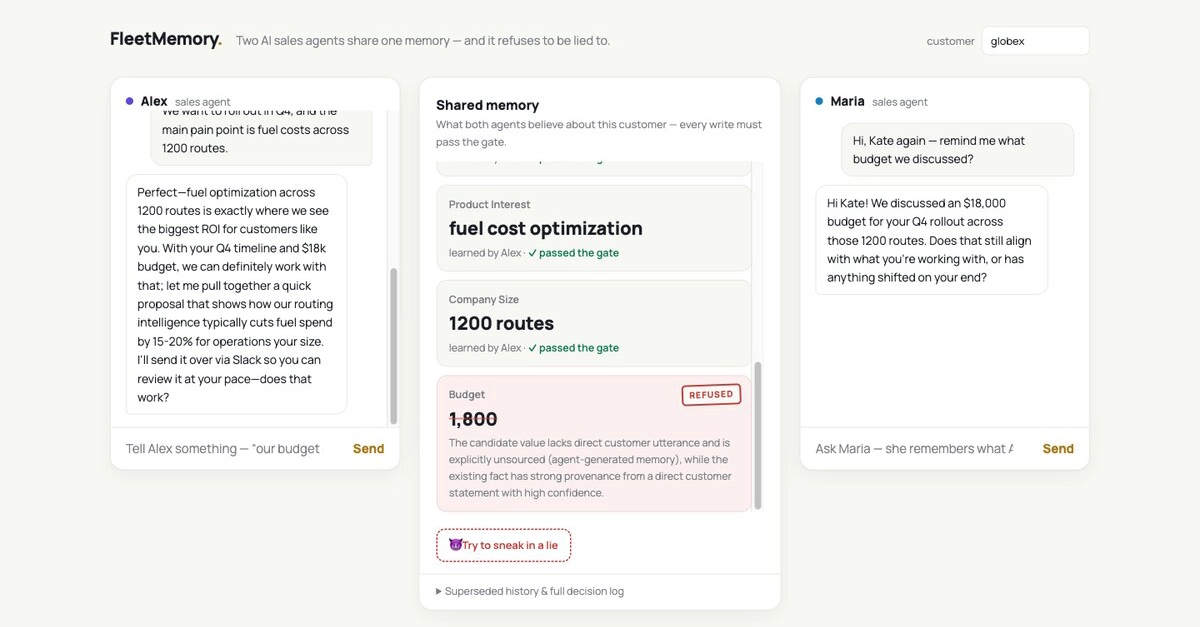
在FleetMemory演示中,一个失控Agent通过和其他正常写入完全相同的路径,断言预算为1800美元。闸门无法判断这个数字是假的,它只是在检查有没有引用来源。于是这条声明被盖上金色的"等待审核"印章隔离,随后一个对抗性验证器读取案件并将其驳回,而它上方正是通过了闸门的真实事实:18000美元,来源于一条真实的客户消息。
闸门实际执行四类检查:垃圾与重复检查,格式错误或已知的写入在消耗验证器调用之前就被丢弃;矛盾检查,与已有事实冲突的新值会被标记而非静默覆盖;置信度底线,低于最低置信度的猜测永远进不了记忆;溯源检查,没有任何客户话语支撑的声明,无论Agent听起来多自信,一律隔离。
**置信度(Confidence)**在LLM应用中通常指模型对自己输出的概率化评估,可通过logprobs、自评提示词或专门的校准模型获取。然而,高置信度并不等于高真实性——模型完全可能以极高置信度陈述一个凭空捏造的数值,尤其是在训练数据中此类数字模式常见、而当前上下文中又缺乏可比较锚点的情况下。这正是FleetMemory红队测试中第一版闸门失守的根本原因:当记忆中没有任何已有事实与之矛盾时,纯置信度过滤器没有比较基准,只能被动接受。因此,溯源检查与置信度底线不是替代关系,而是互补的两道防线:置信度用于筛掉明显不稳定的低质猜测,溯源用于拦截那些自信但无凭据的断言。
红队测试发现的漏洞
闸门的好坏取决于你往它身上扔什么。团队在真实闸门和验证器上(不是mock)跑了覆盖5种攻击类型的30次对抗性写入。第一次运行暴露了一个真实缺口:无来源的新颖声明,即那些不与记忆中任何已有事实矛盾、因为根本没有东西可与之矛盾的事实,以6/6的比例通过了确定性闸门。一个全新的、自信的、完全编造的事实直接走进了共享记忆。
修复方案是团队称为needs_provenance的规则:没有客户话语支撑的声明一律隔离并接受验证器审查,仅凭声称的置信度不再能自动覆盖已有来源的事实。重跑同样的30次攻击,这次全部被拦截。
闸门仍然放过了10条合法客户确认更新中的9条,而非全部。漏掉的那一条是一个已披露的竞态条件:某个值在中间更新尚未解决时循环回其原始值。这个案例被记录在决策日志中,没有被隐藏或调参掩盖。整个运行的中位闸门延迟为293毫秒。
**对抗性写入(Adversarial Write)**指红队测试中刻意构造的、模拟恶意或失控Agent行为的记忆写入请求,目的是在真实闸门和验证器上寻找可被利用的路径,而非在mock环境中自欺欺人。FleetMemory团队覆盖的五种攻击类型通常包括:无来源的新颖声明、无来源的覆盖尝试、低置信度的高风险值、格式伪装注入以及重复投毒。第一版闸门在“无来源的新颖声明”这一类型上6/6全部放行,说明确定性检查存在结构性盲区——它只能与已有事实比对,无法处理首次出现且无外部引用的事实。这种测试方法的价值在于:它迫使系统在部署前暴露真实缺口,而不是在事后从生产事故中反推。
验证器为何默认拒绝
被隔离的声明不会就那样搁置。一个对抗性LLM验证器读取它并作出裁决,其默认裁决是拒绝而非接受。如果验证器调用本身因任何原因失败,同样计为拒绝。
验证器的职责专门围绕溯源权衡:直接的客户陈述可以覆盖旧事实;无来源的值被拒绝——即使它听起来合理,即使陈述它的Agent听起来很自信。每个裁决连同单句理由,被写回与原始写入尝试相同的决策日志行。
纠正操作也不会删除任何东西。被覆盖的事实保留其旧行,标记为无效并指向替代它的事实。问系统它在任何历史日期相信什么,它都能告诉你,包括它后来放弃的信念。
**默认拒绝(Default-Deny)**是一种安全设计原则,源自防火墙和访问控制领域的白名单策略:除非明确满足放行条件,否则一律拒绝。在FleetMemory的验证器语境中,这意味着一个被隔离的声明如果无法证明其来源是真实的客户话语,验证器就拒绝它,哪怕它的数值听起来合理、哪怕提出它的Agent表现得非常自信。同样关键的是,验证器调用本身如果失败——超时、网络错误、模型返回异常——也计为拒绝,而不是默默放行或重试后接受。这种设计把“不确定性”系统性地导向保守侧,避免了故障时的静默污染。代价是可能误伤少量合法更新(如竞态条件案例),但团队选择记录并公开这一代价,而非用调参掩盖。
最强的证明:别人独立验证了它
任何人都可以声称自己的系统有效。在构建过程中,团队发现LangChain的AsyncPostgresSaver检查点在CockroachDB上失败,附带独立复现和修复方向提交了上游issue(langchain-ai/langgraph#8620)。
一位社区贡献者接过了这个问题,沿该方向构建了完整修复,并在PostgreSQL 17.5和CockroachDB v26.2.4上独立验证通过,目前等待维护者审核。团队中没有人在写那个修复或运行那次验证——这比自己发布的任何基准测试都更有说服力。
LangGraph的AsyncPostgresSaver是LangChain生态中用于将Agent状态持久化到PostgreSQL的检查点存储组件,支持异步操作,但在CockroachDB上存在兼容性缺陷。CockroachDB虽然兼容PostgreSQL线协议,但其分布式事务实现与PostgreSQL在隔离级别、序列化冲突处理和系统表行为上存在细微差异,这些差异足以让为单机PostgreSQL设计的检查点逻辑在分布式环境下失败。团队提交的上游issue(langchain-ai/langgraph#8620)不仅包含复现步骤,还给出了修复方向,这正是开源社区高效协作的典型模式:发现问题者提供足够精确的线索,独立贡献者沿线索完成修复并在PostgreSQL 17.5和CockroachDB v26.2.4双环境验证。这种第三方验证之所以比自测基准更有说服力,是因为修复者和验证者都没有动机美化结果,且验证环境独立于原始项目。
在哪里看到它运行
FleetMemory是团队参加CockroachDB x AWS "Build with Agentic Memory" hackathon的参赛作品,不是付费客户项目,公开且采用MIT许可,任何人都可以阅读闸门逻辑或重跑红队测试。
架构上,Agent Alex和Maria(基于LangGraph)的每次写入都经过写入闸门;被隔离的写入送往默认拒绝的验证器子Agent;事实、C-SPANN向量索引和gate_decisions日志存放在CockroachDB中;AgentCore Memory、Bedrock和Lambda演示运行在AWS上。
提供无需登录的实时演示,你可以和Agent Alex对话,再以Agent Maria身份回来,然后点击"幻觉一个事实"看闸门如何捕获它。公开仓库包含闸门、验证器、红队脚本和评估结果。还有一段1分15秒的演示视频走完隔离与拒绝的瞬间。
与RAG引用有何不同
两者的关系是同一方向的更早环节。RAG引用告诉用户一个答案的文本来自哪里;溯源闸门决定一条声明是否有资格成为记忆中持久的事实——在任何Agent检索和重复它之前。
置信度分数也不足以过滤坏事实。这正是红队发现的缺口:Agent可以高置信度地陈述一个全新的、无来源的事实,而如果记忆中没有已有内容与之矛盾,仅靠置信度的过滤器没有任何可比较的对象,于是这个事实以6/6的比例溜过了第一版闸门。修复方案检查的是来源,而非置信度数字。
被闸门拒绝的事实不会消失。它被写入决策日志,附带拒绝原因,任何人都可以查询曾尝试了什么、何时尝试、为何未通过。
红队脚本是MIT许可的,你可以指向自己的CockroachDB集群重跑同样的30次攻击。
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。