算力告急:OpenAI暂停200美元Pro新订阅内情
GPT-6 Astra发布一周因算力严重不足,OpenAI被迫暂停200美元Pro档新订阅并两度重置额度。
OpenAI于9月10日起暂停每月200美元ChatGPT Pro档的新订阅,原因是GPT-6 Astra发布后算力供给严重吃紧。据产品负责人Tibo透露,Astra上线一周基本处于"超载"状态,期间两度耗尽全局额度,大量用户将其用于Blender 3D建模等高消耗任务是主要推手。现有200美元订阅用户可正常续费使用,但Free、Go、Plus及100美元Pro用户均无法升级。与此同时,社区争议Astra是否在高峰期悄悄降质,官方回应称未主动修改模型,但承认算力不足并承诺调查。这一系列事件揭示出顶级AI模型需求增速远超算力扩张速度这一行业核心矛盾。
最贵套餐突然停售
OpenAI最高档位的付费服务迎来意外调整。据爆料,9月10日起,每月200美元的ChatGPT Pro档暂停新订阅。负责Codex的产品负责人Tibo在社交平台上给出了直接理由:这一档位给系统带来的压力最大,暂停新购是为了保住现有用户的体验。
换句话说,这不是营销策略,而是算力扛不住后的被动应对。当一家顶级AI公司主动关闭最高利润的付费入口时,背后的供给紧张程度可想而知。
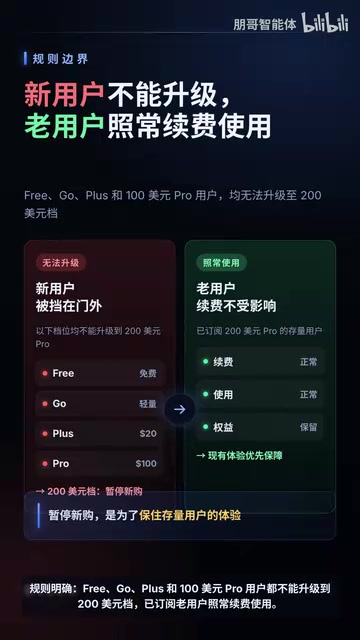
规则划得很清楚:Free、Go、Plus以及100美元Pro用户,都无法升级到200美元档;而已经订阅的老用户照常续费、正常使用。这种“保存量、限增量”的做法,既是对现有付费用户的承诺,也是对系统负载的紧急刹车。
Astra发布一周:一个词概括“超载”
这轮停售的导火索,是GPT-6 Astra的发布。按照Tibo的说法,过去一周Astra的状态基本可以用一个词总结——超载。
时间线清晰地勾勒出压力的层层叠加。9月3日Astra上线当天,普通付费用户甚至拿不到模型,供给从第一天就吃紧。到了9月7日,Tibo再次宣布全局重置额度,理由颇具戏剧性:大量用户拿Astra去做Blender建模,把配额烧光了。
这个细节值得玩味。它说明Astra在复杂3D建模、工程类任务上的能力足够强,强到用户愿意用它跑高消耗的创作流程,进而对算力池形成了远超预期的挤兑。模型越好用,反而越可能拖垮系统——这是当下大模型厂商普遍面临的甜蜜负担。
“Astra降质了吗”的争论
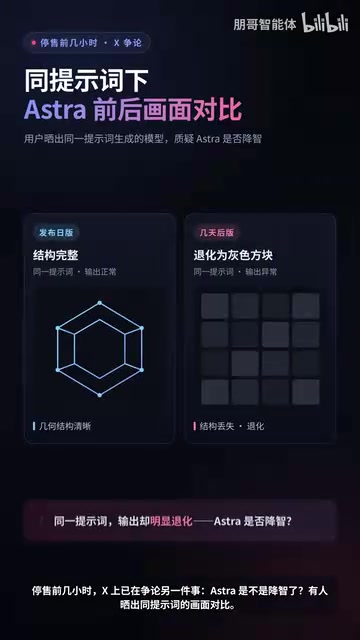
就在停售前几个小时,社交平台上已经为另一件事吵开了:Astra是不是悄悄降质了?
有用户晒出相同提示词下的画面对比,质疑输出质量在高峰期出现了下滑。面对争议,OpenAI员工Victor Nunez回应称,并没有对Astra做任何改动,目前正在调查是否存在降质问题。
截至目前,Astra到底有没有降质还没有定论,但有一点是确定的:算力是真不够了。即便官方没有主动调整模型,极端负载下的排队、限流、降配等机制,也可能让用户在主观体验上感到“变差”。这正是“未改动模型”与“体验下降”两种说法并存的技术根源。
这件事说明了什么
从暂停最高档订阅,到两度重置额度,再到降质争议,OpenAI这一周暴露出的核心矛盾只有一个:顶级模型的需求增长速度,远快于算力供给的扩张速度。
对行业而言,这释放了几个信号。其一,旗舰模型的发布节奏,正越来越受制于硬件和算力调度能力,而非单纯的技术突破。其二,厂商开始用“限制增量、保护存量”的方式管理稀缺资源,付费不再等于无条件可用。其三,当模型能力足以支撑Blender建模这类高消耗任务时,用户的使用方式本身会反过来重塑产品的供给策略。
对普通用户来说,短期内想要体验最高档位的Astra能力,门槛反而变高了。而这场围绕算力的拉锯,很可能是未来一段时间大模型服务的常态。
背景补充
Blender是一款开源的3D创作套件,支持建模、渲染、动画、视频剪辑等全流程工作。它对AI模型的挑战在于:3D建模任务通常需要多轮对话、大量代码生成(如Python脚本调用Blender API)以及持续的上下文维护,单次会话的token消耗量可能是普通文字问答的数十倍。当大量用户将Astra用于此类高强度工程任务时,对算力池的冲击远超对话类或搜索类使用场景——这也是为什么OpenAI需要专门以"Blender建模"作为例证来解释额度耗尽的原因。
大型AI服务在高负载下通常会触发多层保护机制:请求排队会拉长响应延迟;动态限流会降低单用户的并发请求数;部分系统还会在极端负载下自动路由到更小的模型或更低精度的推理配置(即"降配"),以保持整体服务可用性。这些机制本身并不等同于"修改模型",但其效果在用户侧与模型降质几乎无法区分——输出变慢、质量波动、上下文截断等现象都可能出现。这正是Victor Nunez所说的"未改动模型"与用户感知到的"体验下降"能够同时为真的技术原因。
相关推荐

AI SDK 发布版本更新:sandbox-just-bash 组件信息速览
AI SDK 生态组件 @ai-sdk/sandbox-just-bash 发布 1.0.147 补丁更新,同步 @ai-sdk/harness 依赖。本文梳理该发布记录的版本信息与升级建议。

@ai-sdk/sandbox-vercel 1.0.147 发布说明
@ai-sdk/sandbox-vercel 1.0.147 版本发布,这是一次补丁级更新,主要同步升级内部依赖 @ai-sdk/harness 至相同版本,通过 GitHub 可信签名验证。

ChatGPT洗碗记:一支叉子引发的AI过度推理反思
一支洗碗机没洗净的叉子,引发AI启动"深度研究"、消耗海量算力甚至挑战纳维-斯托克斯千禧难题的荒诞实验。这则ChatGPT洗碗讽刺视频,折射出AI过度推理、算力成本与场景错配的真实困境。