随机搜索真能找到任务专家?神经厚丛研究遭质疑

新研究质疑神经厚丛假说:随机权重扰动发现的“任务专家”多由选择偏差造成。
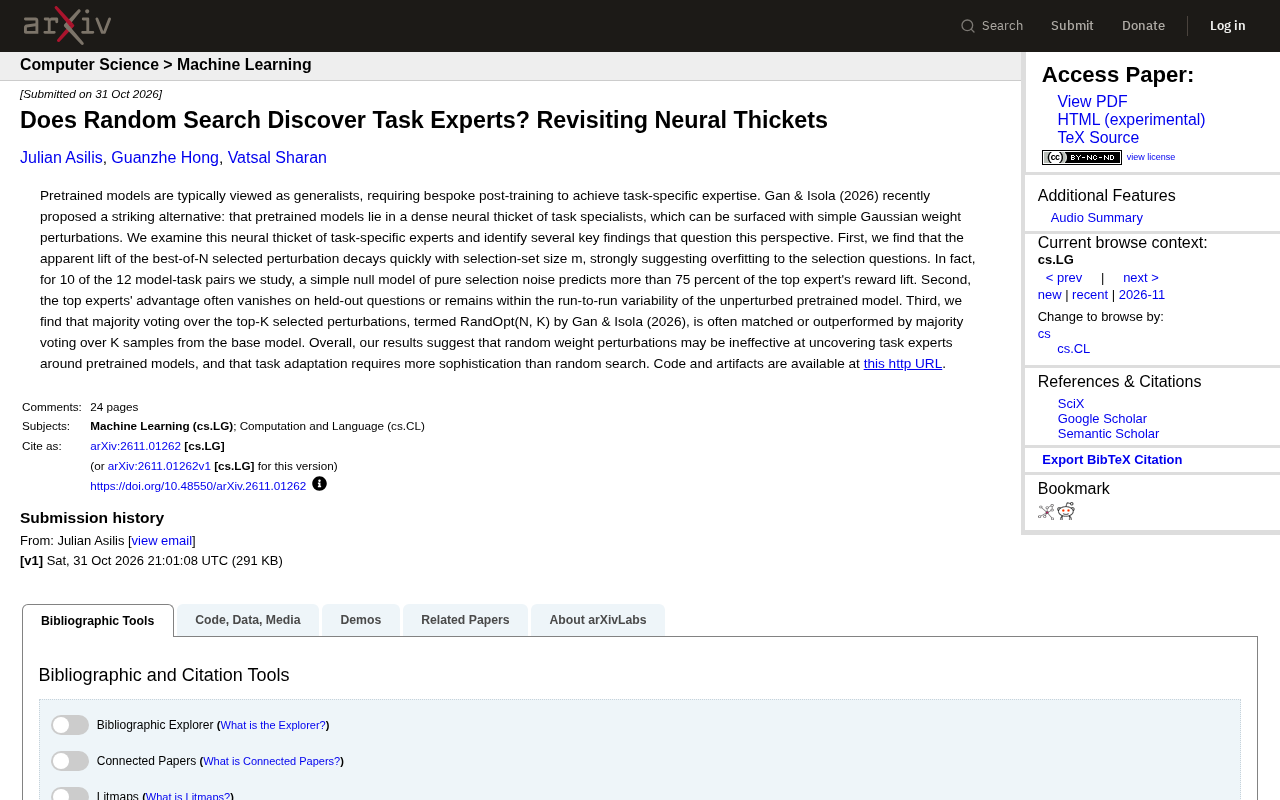
Gan & Isola 提出神经厚丛假说,认为预训练模型周围密集分布着任务专家,只需高斯权重扰动即可显现,并通过 RandOpt 多数投票提升性能。然而,一项重新审视的研究通过系统实验提出质疑:最佳 N 选扰动的提升随选择集增大迅速衰减;零模型显示多数组合中超过 75% 的 top 专家提升可由选择噪声解释;top 专家在留出问题上的优势消失或落入基础模型运行间变异范围;RandOpt(N, K) 常被基础模型直接采样的多数投票匹配或超越。研究表明随机权重扰动可能无法有效发现真正的任务专家,任务适应仍需梯度微调等更精细方法。
预训练模型常被视为通才,需要专门的后训练才能获得任务特定能力。然而,Gan & Isola(2026)提出一个引人注目的替代观点:预训练模型处于一个密集的“神经厚丛”中,其中充满了任务专家,只需简单的高斯权重扰动就能将它们显现出来。这一观点挑战了我们对模型适应性的传统认知,但最近的一项研究对神经厚丛假说提出了质疑,认为随机搜索可能并不足以发现真正的任务专家。
神经厚丛假说:诱人的前景
Gan & Isola 的神经厚丛理论认为,预训练模型并非单一的通才,而是一个密集的专家集合,每个专家擅长不同的任务。通过向模型权重添加随机高斯噪声,可以“激活”这些隐藏的专家,使其在特定任务上表现出色。他们提出的 RandOpt 方法中,对多个扰动版本进行多数投票(RandOpt(N, K))能进一步提升性能。这一发现若成立,将大幅简化任务适应流程——无需梯度更新或额外训练,仅靠随机搜索就能找到专家。
然而,这种方法的实际效果如何?是否真的能可靠地发现任务专家,还是仅仅是在选择集上过拟合?
高斯权重扰动是指向预训练模型的权重参数中添加从高斯分布(正态分布)中独立采样的随机噪声,通常噪声的标准差会按权重尺度进行缩放(如乘以权重矩阵的谱范数或逐元素标准差)。这种做法在贝叶斯神经网络和模型集成文献中常被称为“权重空间噪声注入”。其核心假设是:预训练权重位于一个宽阔的极小值盆地中,小幅随机扰动不会使模型脱离该盆地,因此扰动后的模型仍保持基础能力,同时可能因权重空间的局部几何结构而偏向不同任务。RandOpt 正是利用这一性质,通过采样大量扰动版本来“探测”权重空间邻域内的任务专家。
关键发现:质疑神经厚丛的证据
最近一篇重新审视神经厚丛的研究(代码与工件已开源在 github.com/asil012/RevisitingNeuralThickets)通过系统实验,揭示了几个关键问题,对神经厚丛假说构成了挑战。
1. 选择集上过拟合:最佳扰动的提升随选择集大小迅速衰减
研究首先考察了“最佳 N 选”(best-of-N)策略:从 N 个随机扰动中选出在验证集(选择集)上表现最好的一个。结果发现,这个“最佳专家”的奖励提升随着选择集大小 m 的增加而快速衰减。这意味着,当选择集越大,挑选出的扰动越可能是对选择问题过拟合的,而非真正具备泛化能力的任务专家。
更令人信服的是,研究者构建了一个简单的零模型——假设所有提升都来自纯粹的选择噪声。在研究的 12 个模型-任务组合中,有 10 个组合的 top 专家奖励提升,超过 75% 可以被这个零模型预测。换句话说,大部分看似显著的提升,可能只是选择偏差带来的假象。
“最佳 N 选”(best-of-N)策略是一种常见的推理时扩展方法:独立采样 N 个候选输出或模型变体,然后根据某种评分(如验证集准确率或奖励模型分数)选出最优者。在权重扰动场景中,N 个候选对应 N 个随机扰动模型,选择集则是用于评分的带标签数据。关键在于,当 N 增大时,即使所有候选的真实质量相同,最大观测分数也会因极值统计而系统性偏高——这就是选择偏差。选择集越小,这种偏差越严重,因为评分本身的噪声更大。该研究通过变化选择集大小 m 来量化这一效应,发现 top 专家的表观提升随 m 增大而迅速衰减,直接印证了选择偏差的主导作用。
2. 优势在留出问题上消失或落入噪声范围
如果这些扰动确实找到了任务专家,那么它们的优势应该能泛化到未参与选择的新问题上。然而,实验显示,top 专家的优势在留出问题上经常消失,或者至少落在未扰动预训练模型的运行间变异范围内。也就是说,所谓的“专家”并没有比原始模型稳定地更好,其表现差异可能只是随机波动。
**运行间变异(run-to-run variance)**指同一模型在不同随机种子下(如不同的数据打乱顺序、初始化或推理采样)表现出的性能波动。在评估扰动模型时,一个常见的陷阱是将“扰动模型与基础模型单次运行之间的差异”误判为真实提升,而忽略了基础模型自身重复运行也会产生相近量级的波动。该研究将 top 专家的留出集表现与基础模型多次运行的分布进行对比,发现前者往往落在后者的正常波动范围内,从而说明所谓“专家优势”缺乏统计显著性。这一方法学提醒是评估任何模型适配技术时的基本要求:必须报告基线模型的方差,而非仅比较单点估计。
3. 多数投票策略被基线模型匹配或超越
Gan & Isola 提出的 RandOpt(N, K) 方法,即对 top-K 扰动进行多数投票,被证明往往被一个简单的基线方法匹配或超越:直接从基础模型采样 K 个样本进行多数投票。这表明,随机权重扰动并没有带来额外的多样性或专家信息,基础模型本身的多样性已经足够。
多数投票(majority voting)是一种经典的集成决策规则:对同一输入生成多个预测,然后选择出现频率最高的类别(分类)或对数值输出取平均(回归)。其有效性依赖于成员之间的多样性与个体准确性的平衡。RandOpt(N, K) 的设想是,对 top-K 扰动模型的预测进行多数投票,可以利用不同“专家”的互补性。然而,如果这些扰动模型本质上只是基础模型的噪声版本,它们之间的多样性并不高于从基础模型直接独立采样 K 次所获得的多样性,那么两种投票方案的期望性能就应当相近。该研究的对比实验正是基于这一逻辑,表明随机权重扰动并未引入超越基础模型采样噪声的额外专家信息。
多源交叉验证与分歧
这项研究通过多个实验设置和模型-任务组合进行了交叉验证,结果一致指向神经厚丛假说的局限性。然而,Gan & Isola 的原始工作可能强调了不同的实验条件或评估指标,导致结论差异。双方的分歧主要在于:扰动带来的提升是否具有泛化性,以及多数投票策略的有效性。
从目前证据看,随机权重扰动在 uncovering 任务专家方面可能并不有效,任务适应需要比随机搜索更精细的方法。
对AI实践的启示
对于AI从业者而言,这项研究提醒我们:在追求任务特定性能时,依赖随机搜索或简单扰动可能带来虚假的希望。更可靠的途径仍然是基于梯度的微调、提示工程或结构化适配器等方法。同时,评估方法本身也需谨慎——选择偏差和运行间变异可能掩盖真实效果。
神经厚丛假说虽然诱人,但目前的证据表明,随机搜索可能只是发现了噪声中的幻象,而非真正的任务专家。未来研究需要更严格的泛化测试和基线比较,以厘清预训练模型权重空间的结构。
参考文献
- Gan & Isola (2026). Neural Thickets: Diverse Task Experts Are Dense Around Pretrained Weights.
- 重新审视研究: github.com/asil012/RevisitingNeuralThickets
相关推荐

笔记本CPU跑本地大模型:Ollama+千问3给桌宠装大脑
普通笔记本没显卡也能跑本地大模型:B站UP主用Ollama加开源千问3 8B纯CPU运行,为原创桌宠小金娘装上本地大脑,配合DeepSeekHarness完成插件开发与三轮调试,模型0元、断网可用、隐私不出本机。

Mistral Large 4开源权重发布:1万亿参数,激活49亿
Mistral Large 4开源权重发布:约1万亿参数、激活约49亿,支持图文与百万级上下文。解析厂商自测的编码与网络安全数据、修改版宽松许可、数据中心级硬件门槛,以及权重公开后不可回收的安全风险。

AgentScope 2.0实战:Java企业级AI Agent开发指南
AgentScope 2.0是阿里巴巴推出的Java企业级分布式智能体框架。本文解析它为何适合服务端AI应用,对比客户端AI应用在权限、状态管理、并发上的差异,并梳理从环境配置到项目联调的实战学习路线。