Suno v6模型发布:AI音乐首次获唱片业授权支持
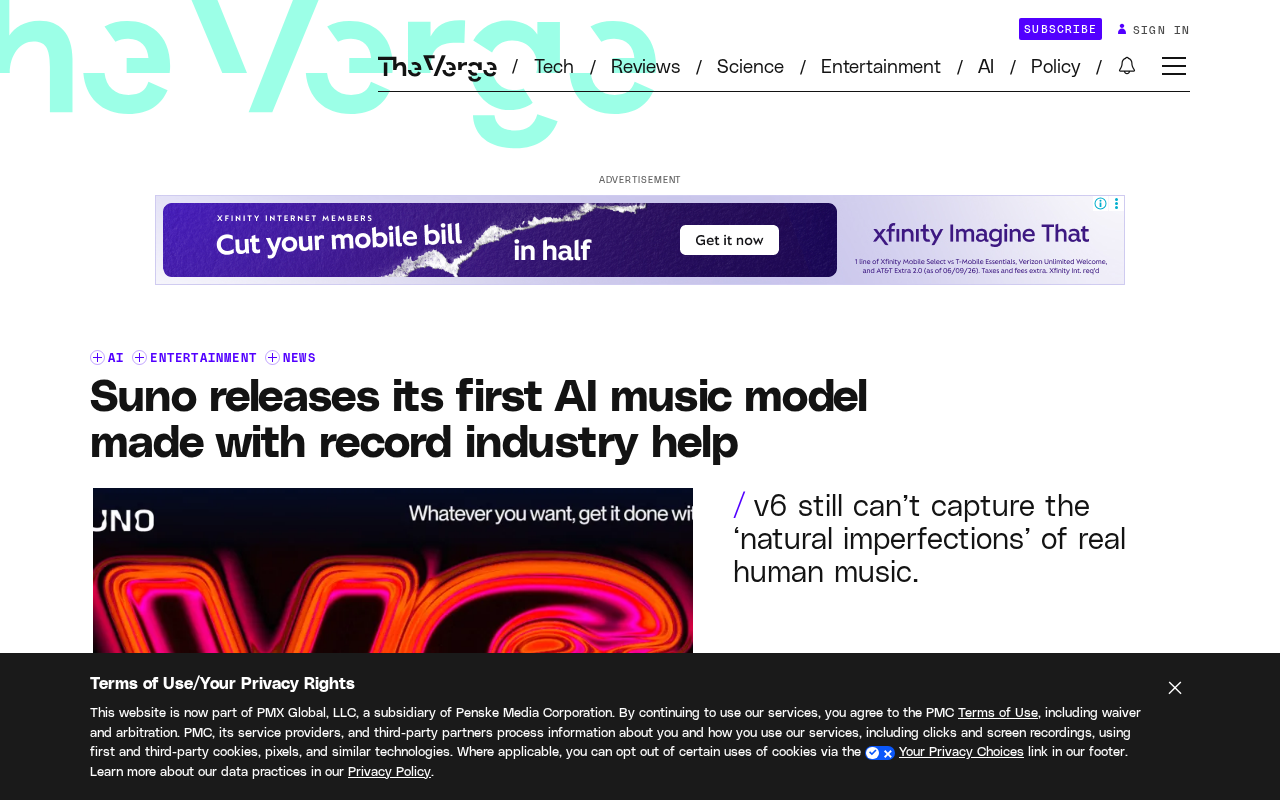
Suno发布首个基于授权数据训练的AI音乐模型v6,标志行业从对抗转向合作。
AI音乐公司Suno发布v6模型,这是其首个在唱片行业支持下、使用全新授权数据集从头训练的模型,彻底切割了此前可能包含侵权内容的旧数据。此举回应了环球、索尼、华纳三大唱片公司此前的版权诉讼,标志着AI音乐行业从野蛮生长进入规范化合作阶段,类似于文本和图像AI领域已经历的版权和解路径。
Suno转向合法数据:v6模型标志行业和解
AI音乐生成领域的领军者Suno近日发布了其第六代音乐模型v6,这不仅是一次技术升级,更是一个具有里程碑意义的行业信号。据Suno团队成员Jack Brody向The Verge透露,v6是该公司首个在唱片行业支持下打造的AI音乐模型。
这一表态背后隐含着深刻的行业转折。在过去两年里,AI音乐生成工具一直处于版权争议的风口浪尖,Suno与Udio等公司曾因涉嫌使用未经授权的音乐数据训练模型而遭到主流唱片公司的诉讼。具体而言,2024年6月,环球音乐集团(UMG)、索尼音乐娱乐和华纳音乐集团联合对Suno和Udio提起诉讼,指控其"大规模侵犯版权",索赔金额高达每首侵权作品15万美元。诉讼文件中展示了AI模型能够生成与受版权保护的歌曲高度相似的输出,以此作为训练数据包含侵权内容的证据。这三大唱片公司合计控制着全球约70%的录制音乐市场份额,它们的联合行动代表了整个行业对AI数据使用方式的集体立场。
这些诉讼基于美国《版权法》第106条,该条款赋予版权持有者对作品复制、分发和创作衍生作品的专有权利。诉讼的核心法律争议在于:将受版权保护的音乐作品输入AI系统进行训练是否构成"复制"行为,以及这种使用是否属于"合理使用"(Fair Use)的范畴。美国版权法中的合理使用原则需综合考量四个因素:使用目的与性质(是否具有转化性)、受版权保护作品的性质、使用部分占整体的比例,以及对原作市场价值的影响。AI公司通常援引"转化性使用"进行抗辩,主张模型学习的是音乐的抽象模式而非复制具体作品,但唱片公司通过展示AI生成与原作高度相似的输出来反驳这一论点。
值得注意的是,这并非唱片行业第一次面对技术颠覆带来的版权挑战——从Napster时代的P2P文件共享到YouTube早期的侵权内容泛滥,唱片公司都经历了从激烈对抗到最终达成商业合作的过程。此次三大唱片公司对AI公司的诉讼策略也颇为精巧:它们通过让AI模型生成特定艺术家风格的歌曲并展示其与原作的高度相似性,试图从技术层面证明模型训练数据中包含了受保护的作品,这一举证方式在版权法领域具有开创性意义。此次v6明确强调"行业支持",意味着这场对抗正在转向合作。

从头训练:全新数据集的技术突破
Brody特别强调,v6是"从头开始训练的,使用了一套全新的数据集,不包含我们之前模型所使用的相同数据。"
这句话的分量不容小觑。在深度学习领域,"从头训练"(training from scratch)意味着不使用任何预训练权重,而是用随机初始化的参数在全新数据集上完成完整的训练过程。这与"微调"(fine-tuning)或"继续训练"(continual training)有本质区别——后两者会保留原有模型从旧数据中学习到的特征表示。
要理解这一区别的深层含义,需要了解神经网络参数与训练数据之间的关系。模型参数(即神经网络中的权重和偏置)是通过反向传播算法在训练数据上迭代优化而得到的。这些参数以分布式表示的方式编码了训练数据中的统计模式。由于这种分布式编码的特性,单个参数无法对应到特定的训练样本,但训练数据的整体统计特征——包括旋律走向、和声进行、节奏模式、音色特征等——已深深嵌入数十亿个参数的交互关系中。因此,即便一个模型在微调阶段只使用了合法数据,其底层的神经网络权重中仍然编码着从旧数据(可能包含侵权内容)中学到的音乐模式和特征。这也是为什么仅仅更换微调数据不足以解决版权问题的技术根源。
对Suno而言,从头训练意味着v6模型的所有音乐知识完全来源于新的合法数据集,从技术层面彻底消除了旧数据可能残留的版权风险。不过,这也意味着巨大的计算成本投入——大规模音乐模型的训练通常需要数千张高端GPU(如NVIDIA A100或H100)运行数周甚至数月,仅算力成本就可能达到数百万美元量级。Suno愿意承担如此高昂的重新训练成本,充分说明了其向合规化转型的决心。
它实际上是对此前模型训练数据来源的一种间接回应——过去的模型可能包含未经充分授权的内容,而v6则彻底切割了这部分数据,转而采用经过授权的合法内容进行训练。这种"重新洗牌"式的做法,不仅是技术选择,更是法律和商业策略上的重新定位。
授权数据为何成为AI音乐的关键
版权困境的核心矛盾
AI音乐生成的根本挑战在于:模型需要海量高质量的音乐作品进行训练,而这些作品绝大多数受版权保护。早期的生成式AI公司普遍采取"先训练、后解决"的激进策略,即先用网络上能获取的一切数据训练模型,再应对可能的法律风险。
要理解这一挑战的技术维度,有必要回顾AI音乐生成技术的发展脉络。该领域经历了从符号音乐生成(MIDI序列)到端到端音频波形生成的重大演变。早期系统如Google的Magenta项目主要基于循环神经网络(RNN)和长短期记忆网络(LSTM)生成简单的单声部旋律,这些系统对训练数据的需求相对有限。2019年OpenAI推出的MuseNet则首次将Transformer架构引入音乐生成,展示了多乐器、多风格音乐生成的可能性。而2023年以来,随着Meta的MusicGen、Google的MusicLM等系统的问世,基于Transformer架构和扩散模型(Diffusion Model)的新一代系统实现了质的飞跃——它们能够直接从文本描述生成高保真的音频波形。
现代AI音乐生成模型主要依赖两种核心技术架构。第一种是基于离散音频编码的自回归模型:首先使用神经音频编解码器(如Meta开发的EnCodec或Google的SoundStream)将连续的音频波形压缩为离散的token序列,然后用类似GPT的Transformer模型在这些token上进行自回归生成。这种方法的优势在于可以直接借鉴大语言模型的成熟训练范式。第二种是扩散模型(Diffusion Model),它通过学习逐步去噪的过程,从纯高斯噪声中生成音频频谱图,再通过声码器(Vocoder)将频谱图转化为音频波形。Stability AI的Stable Audio采用的就是潜在扩散模型(Latent Diffusion Model)架构。Suno的具体技术架构未完全公开,但从其产品特性推测,很可能采用了多阶段生成流水线——先由语言模型生成歌词和音乐结构描述,再由音频生成模型将其转化为实际音频。
Suno采用的技术路线融合了大语言模型的文本理解能力和音频生成模型,用户只需输入文字描述即可生成包含歌词、旋律、编曲和演唱的完整歌曲。这种端到端的歌曲生成在技术难度上远超纯器乐生成,因为它需要模型同时理解语言语义、音乐结构、声乐表现和音频制作等多个维度。正因为需要如此复杂的音乐理解能力,高质量、大规模且覆盖多种风格的训练数据便成为决定模型水平的关键要素。
然而,随着环球音乐、索尼音乐、华纳音乐等唱片巨头的强力介入,这条路径已越走越窄。诉讼、下架、监管压力接踵而至,迫使AI公司必须重新思考数据来源的合法性。与此同时,各国的监管框架也在逐步成型——欧盟《人工智能法案》要求AI开发者披露训练数据中受版权保护的内容摘要,美国版权局也在积极征集关于AI训练数据合规性的公众意见。这些监管动向进一步压缩了使用未授权数据的灰色空间。
Suno的战略转身
Suno选择在v6中全面采用授权数据,实质上是从"对抗者"向"合作者"的转变。这种转变的商业逻辑清晰:
- 降低法律风险:合法数据从源头上规避了侵权诉讼
- 建立行业信任:与唱片公司合作有助于打通商业化渠道
- 可持续发展:为长期的商业模式奠定合规基础
在生成式AI领域,数据授权已形成多种成熟模式,为Suno提供了可参考的先例。在文本领域,OpenAI与美联社(Associated Press)签订了新闻内容许可协议,与德国出版巨头Axel Springer达成了培训和内容使用合作;在图像领域,Shutterstock向AI公司授权其庞大的图库数据,并设立了贡献者基金,确保原始摄影师和艺术家能从AI训练使用中获得经济回报。在音乐领域,Google旗下的Music AI工具Lyria与环球音乐建立了合作关系,允许艺术家利用AI工具进行创作实验;YouTube也推出了AI音乐孵化器项目"Music AI Incubator",邀请了包括Charlie Puth、Demi Lovato在内的知名艺术家探索AI与音乐创作的结合。这些授权协议通常涉及前期许可费用、按使用量或收入分成、或两者结合的复合模式。数据授权的定价目前尚无统一的行业标准,取决于数据的规模、质量、独占性、使用期限以及双方的议价能力。据业内人士估计,大型内容许可交易的金额从数百万到数亿美元不等。Suno此次获得的"唱片行业支持",大概率也遵循了类似的商业框架,可能涉及对训练数据的使用许可费以及对AI生成音乐收入的分成安排。
对于一个希望成为主流音乐工具的平台而言,与其永远处于被诉讼的阴影之下,不如主动拥抱版权体系,这或许是更明智的长期布局。
AI音乐行业格局的深远影响
AI与创意产业的新平衡
Suno v6的发布,可能预示着AI音乐行业进入一个新阶段——从野蛮生长转向规范化合作。这与文本、图像领域的AI发展轨迹惊人地相似:早期的数据获取争议,最终往往通过授权协议、内容许可等方式逐步解决。例如,在AI图像生成领域,Stability AI因使用LAION数据集中未经授权的图片训练Stable Diffusion模型而面临Getty Images等机构的诉讼,此后该领域逐渐转向与图库平台合作获取授权数据的模式。同样,在AI文本领域,纽约时报对OpenAI的诉讼也推动了更多媒体机构与AI公司签订正式的内容许可协议。这些先例表明,版权争议往往是推动行业建立规范化合作框架的催化剂。
对唱片行业而言,与其被动防守,不如主动参与AI工具的构建,从而在新技术浪潮中掌握主动权和分成权益。授权模式让版权方能够从AI生成内容中获得收益,而非单纯地承受冲击。事实上,唱片行业已经从流媒体革命中学到了教训——当年对Spotify等平台的抵制最终证明是徒劳的,而那些率先与流媒体平台合作的厂牌反而获得了新的收入增长点。
对音乐创作者的实际意义
对于普通音乐创作者和内容制作者来说,一个基于合法授权数据的AI模型意味着更少的使用顾虑。用户在使用Suno生成音乐时,可以更放心地将作品用于商业用途,而不必担心潜在的版权纠纷。这种"合规红利"本身就是产品的重要竞争力。
不过,AI生成音乐的版权归属目前在全球范围内仍是法律灰色地带。美国版权局在2023年发布的指导意见中明确表示,纯粹由AI生成的内容不具备版权保护资格,因为版权法要求作品必须具有"人类作者性"(human authorship)。这意味着如果用户仅输入简单的文字提示让Suno生成一首歌,该歌曲可能无法获得版权保护。然而,如果人类创作者在AI生成内容的基础上进行了实质性的选择、编排和修改,则修改后的作品可能获得部分版权保护。这一法律不确定性对AI音乐工具的商业化构成了独特挑战——如果生成的音乐无法获得版权保护,那么使用者就无法阻止他人复制和使用这些音乐,这将显著降低AI音乐在某些商业场景中的价值。因此,Suno等工具的用户在将AI生成音乐用于商业用途时,不仅需要关注训练数据的合法性,还需要审慎评估生成内容本身的版权状态。
在AI音乐生成市场中,Suno的主要竞争对手包括Udio(同样面临三大唱片公司的诉讼)、Google的MusicFX(基于其DeepMind团队开发的Lyria模型)以及Meta开源的MusicGen等。此外,还有Stability AI的Stable Audio、Beatoven.ai等面向不同细分市场的玩家。Suno凭借其用户友好的界面、歌词生成能力和较高的整体音乐质量,截至2024年已吸引超过千万用户,在消费级AI音乐市场中占据领先地位。合规化战略可能帮助Suno在利润更为丰厚的B2B市场获得显著优势——广告公司需要大量背景音乐用于品牌视频、影视制作方对配乐有持续需求、游戏开发商需要动态音乐系统,这些企业客户在采购AI音乐工具时,版权合规性是首要考量因素,因为任何侵权风险都可能导致巨额赔偿和品牌声誉损失。此外,Apple Music、Spotify、YouTube Music等音乐分发平台也在逐步建立AI生成内容的审核和标注机制——Spotify已于2024年开始移除部分被认定为AI生成的低质量内容,YouTube则要求创作者标注AI生成的内容。合规的AI音乐工具将更容易通过这些平台的审查门槛,这使得"合规红利"不仅体现在法律层面,更直接影响产品的市场可达性和分发渠道。
尚待观察的关键问题
尽管v6的发布传递了积极信号,但仍有多个关键问题有待厘清:
- 具体合作方是谁:"唱片行业支持"究竟涉及哪些公司,授权范围有多广,目前尚未完全披露。特别是,此前提起诉讼的三大唱片公司——环球、索尼和华纳——是否包含在合作方之中,这将直接决定此次合作的分量和行业影响力
- 音质与创作能力:从头训练的全新数据集是否会影响模型的生成质量和多样性。这一担忧并非没有根据——授权数据集的规模和多样性往往难以匹敌从互联网无限制爬取的数据。商业授权数据通常集中于主流音乐风格和知名艺术家的作品,而小众音乐类型(如实验电子、民族音乐、地下独立音乐等)的授权资源相对匮乏。此外,授权数据集的总量可能仅为此前无限制爬取数据的一个零头,这在深度学习中通常意味着模型在某些长尾场景下的泛化能力会有所下降。不过,近年来的研究也提供了积极的视角——在深度学习领域,关于数据规模与数据质量的权衡一直是活跃的研究方向。2022年DeepMind发表的Chinchilla论文揭示了训练数据量与模型参数量之间的最优缩放法则。更近期的研究,如Meta的LIMA论文("Less Is More for Alignment"),则证明了在特定任务上,经过精心筛选的少量高质量数据可以显著优于大规模低质量数据。在音乐领域,这一发现尤为相关:专业录音棚制作的母带级音频在信噪比、动态范围、混音质量等方面远优于YouTube翻录或低码率流媒体抓取的音频。使用高质量授权数据训练的模型,虽然在数据总量上可能有所不足,但有可能在音频保真度和制作水准上反而超越使用海量低质量数据训练的模型。Suno是否在数据质量方面做了优化以弥补规模上的不足,值得关注
- 商业分成机制:版权方如何从AI生成内容中获益,具体的利益分配模式尚不明确。这涉及一个根本性的行业问题:当AI模型基于数千位艺术家的作品训练后生成了全新的音乐,这些原始艺术家应该获得怎样的补偿?是一次性的训练数据许可费,还是与AI生成内容的收入挂钩的持续分成?参考流媒体领域的经验,Spotify向版权方支付的分成比例约为其总收入的70%,但这一模式建立在可清晰归属每首歌曲播放次数的基础上。AI生成音乐的情况则更为复杂——一首AI生成的歌曲可能融合了数千首训练歌曲的特征,如何将收益合理分配给贡献了训练数据的各个版权方,目前尚无成熟的技术方案或行业共识。这一问题的解决方案将深刻影响AI时代音乐创作者的经济利益
这些细节将决定v6模式能否成为整个行业的范本,还是仅仅是Suno的一次单独尝试。
结语:AI音乐的合规化转折点
Suno v6的意义远超一次普通的模型迭代。它代表着AI音乐生成从"法律灰色地带"走向"合规合作"的重要转折。当技术公司与传统内容产业找到共赢的合作模式,AI音乐才有可能真正走向成熟和主流化。
这场从对抗到合作的转变,或许正是整个生成式AI行业未来发展的缩影——技术创新终究需要在尊重版权与创意价值的框架内寻求突破。正如互联网的发展历程所揭示的,每一次重大的技术-内容冲突最终都催生了新的商业模式和产业格局。从Napster到iTunes再到Spotify,音乐产业在每一轮技术革命中都经历了阵痛后的重生。AI音乐生成或许正站在类似的历史节点上,而Suno v6的合规化转型,可能就是这一轮变革中最具标志性的第一步。
核心要点
相关推荐

触屏MacBook与混乱的苹果:一场刻意为之的冒险
The Vergecast 深入讨论触屏 MacBook Pro 的发布逻辑、ProLed 命名争议、iPad 被 iPhone 与 Mac 两头挤压的困境,以及苹果在 AI 时代如何靠高端硬件维持竞争力。
研究权力50年:Robert Caro的写作与权力洞察
Robert Caro研究权力50年,在访谈中谈Lyndon Johnson的说服力与杠杆、Robert Moses从理想主义到冷酷的变迁、大规模建设的困境,以及传记写作中压缩主题与孤独专注的方法。
2万美元的机器人能替你干家务吗?实测结果令人意外
一段YouTube实测视频展示2万美元机器人如何响应洗碗、关灯、倒垃圾、喂狗等指令。本文分析其真实能力边界、语音交互技术现状,以及家务机器人距离普及还有多远。