SW-KAN:用q-正交多项式破解KAN的域不匹配难题

SW-KAN用半无限域正交多项式解决KAN变体的域不匹配问题,兼顾数值稳定与参数效率。
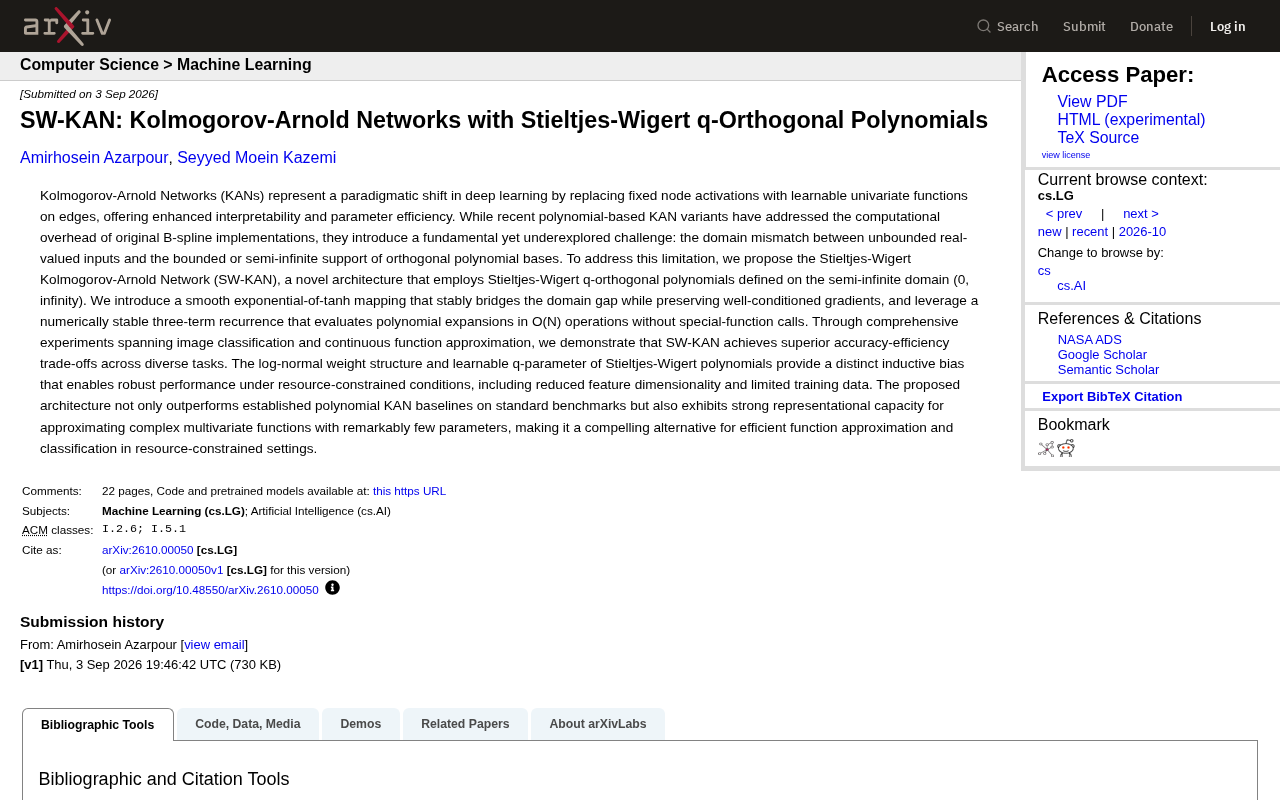
SW-KAN(Stieltjes-Wigert Kolmogorov-Arnold Network)是一篇针对多项式KAN变体中"域不匹配"缺陷的新研究。传统多项式KAN用定义在有界区间的正交多项式替代B样条,但神经网络的实际输入往往是无界实数,两者之间的错配损害了数值稳定性与表达能力。SW-KAN通过三项创新加以解决:选用定义在半无限域(0,∞)的Stieltjes-Wigert q-正交多项式为基函数;引入exponential-of-tanh平滑映射将无界输入稳定映射到正半轴;并利用O(N)三项递推计算多项式展开,无需调用特殊函数。实验显示,SW-KAN在图像分类和函数逼近任务上优于现有多项式KAN基线,尤其在低特征维度和小数据场景下表现稳健。该论文目前为arXiv预印本,结论尚待独立验证。
KAN的崛起与一个被忽视的隐患
Kolmogorov-Arnold Networks(KAN)近年来成为深度学习领域一次颇具范式意义的尝试。与传统神经网络将固定激活函数放在节点上不同,KAN把可学习的单变量函数放到了网络的边上。这一改动带来了两个直接好处:更强的可解释性,以及更高的参数效率。换句话说,用更少的参数,模型能表达更复杂的关系,同时人们还能看懂每条边到底学到了什么。
原始KAN依赖B样条(B-spline)实现,这套方案虽然灵活,但计算开销不小。为此,研究者陆续提出了基于多项式的KAN变体,用正交多项式替代B样条来降低计算成本。然而,这类方法埋下了一个长期被低估的问题:域不匹配(domain mismatch)。
正交多项式通常定义在有界区间或半无限区间上,而神经网络的真实输入往往是无界的实数值。当无界输入强行套用有界支撑的多项式基时,数值稳定性和表达能力都会打折扣。这篇arXiv新论文正是瞄准了这个痛点。
B样条(B-spline)是一种分段多项式曲线,由若干控制点定义,在相邻分段之间保持平滑连续。它的优势在于局部支撑性——改变某个控制点只影响曲线的局部区域,这使得B样条在拟合复杂形状时既灵活又稳定。原始KAN将每条边上的可学习函数用B样条参数化,实际上是在为每个输入-输出连接学习一条自适应曲线。然而B样条的代价是显著的:需要存储和更新大量控制点,且在GPU上的并行计算效率不如矩阵乘法。这正是为什么后续研究者转向正交多项式(如Chebyshev、Legendre多项式等)——这些多项式可以用简洁的递推公式高效计算,天然适合GPU加速,但它们通常定义在[-1,1]等有界区间上,与真实神经网络中无界的激活值之间存在天然裂隙,即本文重点讨论的域不匹配问题。
SW-KAN 的核心思路
论文提出的 Stieltjes-Wigert Kolmogorov-Arnold Network(SW-KAN) 选择了一条不同的路径:采用定义在半无限域 (0, ∞) 上的 Stieltjes-Wigert q-正交多项式作为基函数。
这个选择并非随意。Stieltjes-Wigert 多项式带有 log-normal(对数正态)的权重结构,以及一个可学习的 q 参数。作者认为,这种结构提供了一种独特的归纳偏置(inductive bias),使模型在资源受限的条件下依然能保持稳健——比如特征维度被压缩、训练数据有限时。
如何跨越域的鸿沟
要让无界的实数输入对接到 (0, ∞) 的多项式支撑上,关键在于一个稳定的映射。SW-KAN 引入了一种 exponential-of-tanh(tanh 的指数)平滑映射。这个映射的巧妙之处在于:它既能把任意实数稳定地搬运到正半轴,又能保持梯度良态(well-conditioned),避免训练过程中的梯度爆炸或消失。
域不匹配问题的本质,就是输入分布与基函数支撑范围的错配。SW-KAN 没有去削足适履地裁剪输入,而是设计了一个数学上平滑、数值上稳定的桥梁,这是它区别于此前多项式 KAN 的核心创新点。
tanh函数将任意实数压缩到(-1, 1)区间,而对其取指数(exponential-of-tanh)则将输出范围变为(e⁻¹, e¹) ≈ (0.37, 2.72),这是正半轴(0, ∞)的一个有界子集。SW-KAN此处的设计更为精妙:通过对tanh输出适当缩放,可以覆盖Stieltjes-Wigert多项式权重函数集中的区域,同时映射函数的导数处处非零且有界,确保梯度在反向传播时既不会爆炸也不会消失。这与早期多项式KAN常用的简单截断(clip)或归一化方案有本质区别——截断会引入不可微点,而归一化依赖批统计量,在小批量或推理时不稳定。exponential-of-tanh是一个纯粹的逐元素光滑变换,完全兼容自动微分框架,工程实现上几乎零额外成本。
计算效率的保障
效率是多项式 KAN 的立身之本。SW-KAN 利用了一个 数值稳定的三项递推关系(three-term recurrence) 来计算多项式展开。这套递推的优势是:以 O(N) 的复杂度完成展开,并且不需要调用任何特殊函数(special-function calls)。
这一点在工程实现上意义重大。特殊函数调用往往是性能瓶颈和数值不稳定的来源,而纯递推方式让整个评估过程既快又可控。
实验表现与适用场景
论文围绕两类任务展开了较为全面的实验:图像分类 与 连续函数逼近。结论是,SW-KAN 在多样化任务上取得了更优的精度-效率权衡。
具体来看,作者强调了几个关键结论:
- 在标准基准测试上,SW-KAN 超越了已有的多项式 KAN 基线模型。
- 对于复杂的多变量函数逼近,SW-KAN 用极少的参数就展现出强大的表征能力。
- 在资源受限场景(低特征维度、少量训练数据)下,其 log-normal 权重结构和可学习 q 参数带来的归纳偏置发挥了稳健作用。
这意味着 SW-KAN 的目标用户非常清晰:那些对参数预算敏感、又需要高效函数逼近或分类能力的场景,比如边缘设备部署、小样本学习等。
归纳偏置(inductive bias)指的是模型在训练数据之外做出泛化预测时所依赖的先验假设。所有机器学习模型都包含某种形式的归纳偏置:卷积神经网络假设局部平移不变性,Transformer假设序列中存在全局注意力关系。SW-KAN的归纳偏置来源于Stieltjes-Wigert多项式的log-normal权重结构——该结构对正偏态、乘性关系的数据有天然的拟合优势,这类数据在自然界和工程系统中广泛存在(如金融收益率、粒子物理中的某些分布)。可学习的q参数则进一步允许模型在训练中动态调整这一偏置的强度,使其既能在数据符合先验时快速收敛,又不会在先验不匹配时过度受限。这解释了为何在小数据场景下SW-KAN表现相对稳健:紧凑但具有结构性的归纳偏置能更高效地利用有限样本。
价值与局限的理性看待
SW-KAN 的贡献在于,它把 KAN 多项式变体中一个被长期忽视的理论缺陷——域不匹配——明确提出来,并给出了一个兼顾数学严谨性与工程可行性的解决方案。exponential-of-tanh 映射加上三项递推的组合,体现了作者在稳定性与效率之间的细致权衡。
不过也要保持冷静:这是一篇刚发布的预印本(arXiv:2610.00050v1),尚未经过同行评审。论文声称的性能优势基于其自设的实验范围,真正的泛化能力还需更广泛的复现与第三方验证。此外,Stieltjes-Wigert 多项式带来的 log-normal 偏置是否在所有任务上都适用,仍是开放问题。
对关注 KAN 发展的研究者和工程师而言,SW-KAN 提供了一个值得留意的新方向:与其在有界多项式上打补丁,不如从半无限域基函数出发重新设计。它是否能成为高效函数逼近的主流选择,还有待时间检验。
相关推荐

@ai-sdk/tui 1.0.138 发布:依赖更新带来的版本迭代
@ai-sdk/tui 1.0.138 版本发布,作为补丁更新同步了依赖 ai@7.0.137。本文梳理该版本的变更内容及其对 AI SDK 开发者的意义。

AI编程智能体为何失败?拆解"软件工厂"五大核心架构
AI编程智能体并行运行时为何频繁翻车?本文拆解"软件工厂"的五大核心架构:隔离沙箱、issue认领锁、独立校验器、实时文档查询与冲突集成器,并用真实GitHub仓库演示完整流水线与成本。

用n8n打造AI每日新闻简报:20秒告别信息过载
一位 YouTube 创作者用 n8n 搭建 AI 每日新闻简报工作流:RSS 抓取路透社头条、AI 去标题党并摘要、写入 Supabase 数据库、推送 Telegram,20 秒读完全球资讯。本文拆解其实现逻辑与借鉴价值。