SWE-Smith扩展至JavaScript:6099个合成Bug助力多语言代码修复

引言:从Python走向多语言的代码Bug合成
SWE-bench作为评估大语言模型代码修复能力的重要基准,长期以来仅支持Python语言。SWE-bench是由普林斯顿大学NLP组于2023年发布的代码修复评估基准,它从真实的GitHub Issue和对应的Pull Request中提取任务,要求模型在给定问题描述的情况下生成正确的代码补丁。其独特之处在于评估的是仓库级别的代码理解和修复能力,而非简单的函数级代码生成——模型需要定位问题文件、理解上下文依赖、并生成能通过测试的补丁。自发布以来,SWE-bench已成为衡量AI编程助手实际能力的黄金标准,Anthropic、OpenAI等机构均以此作为核心评估指标。
现在,SWE-Smith Multilingual团队迈出了关键一步——将SWE-Smith的合成Bug生成能力扩展到了JavaScript,并计划在未来数月内覆盖TypeScript、Java、Rust、Golang和C++等主流编程语言。
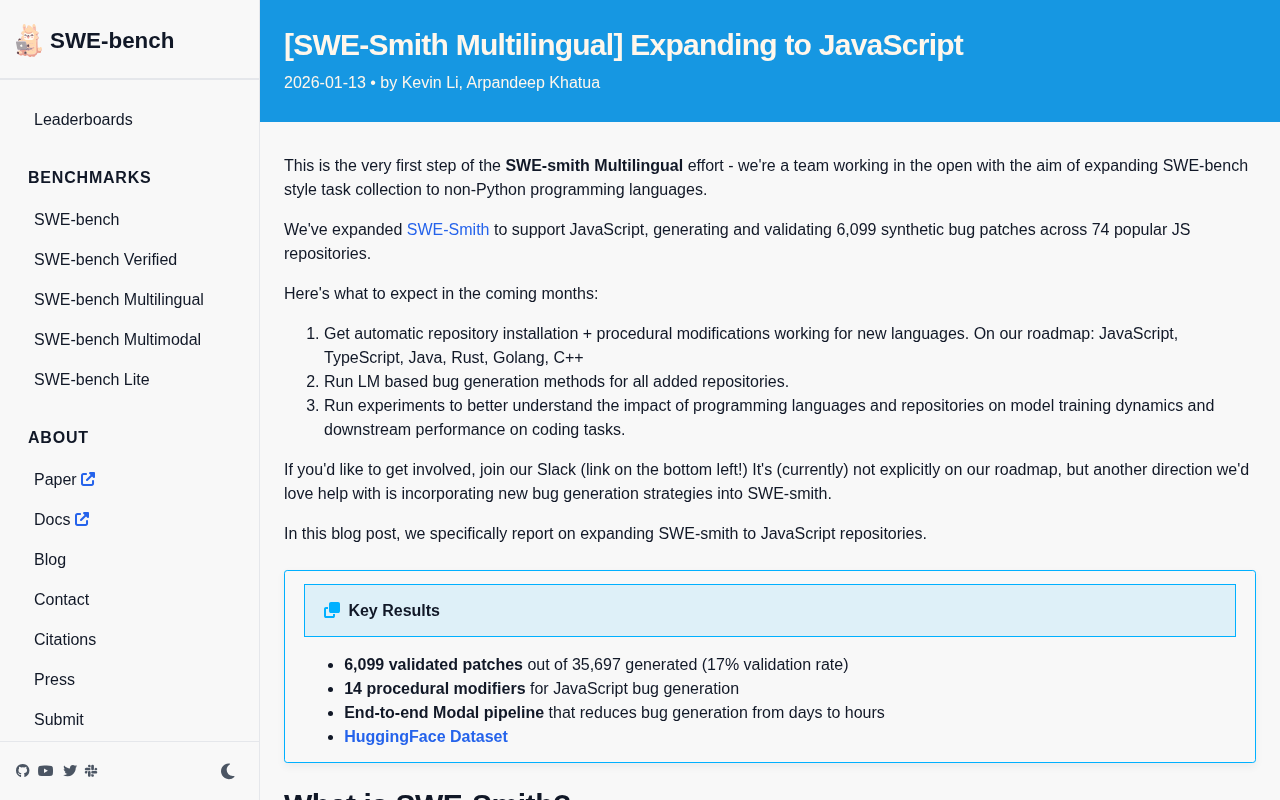
这一扩展的核心成果令人瞩目:团队在74个流行的JavaScript仓库中生成并验证了6,099个合成Bug补丁,验证通过率达到17%。这些数据将为代码修复模型的训练和评估提供宝贵的多语言数据支撑。
SWE-Smith的工作原理
SWE-Smith是一个用于在软件仓库中合成逼真Bug的工具。它的核心思路是对正常工作的代码施加程序化修改(Procedural Modifications),例如翻转运算符、交换函数参数、移除条件判断等,从而制造出能够导致测试失败的Bug。
这种方法源自软件工程中经典的变异测试(Mutation Testing)理论。变异测试最早由Richard Lipton于1971年提出,其核心假设是:如果测试套件能够检测出代码中的微小人为变异(mutant),那么它也能检测出真实的Bug。常见的变异算子包括算术运算符替换(AOR)、关系运算符替换(ROR)、条件运算符替换(COR)等。SWE-Smith将这一理论从测试质量评估转化为训练数据生成——那些能被测试检测到的变异体恰好构成了高质量的Bug-Fix训练对。
这种方法的优势在于:生成的Bug具有真实性(基于实际代码库),且每个Bug都有对应的测试用例来验证其存在和修复。这为训练代码修复模型提供了高质量的「失败→通过」测试对,也为构建评估基准奠定了基础。
仓库级别的产出分析
高产仓库的共同特征
在74个JavaScript仓库中,产出差异极为显著。表现最好的仓库是josdejong/mathjs,生成了845个验证通过的补丁,通过率高达62.8%。这并非偶然——mathjs包含大量算术运算和全面的单元测试,这恰好是程序化Bug生成的理想土壤。
排名前五的仓库包括:
| 仓库 | 生成数 | 验证通过 | 通过率 |
|---|---|---|---|
| josdejong/mathjs | 1,346 | 845 | 62.8% |
| novnc/noVNC | 1,384 | 715 | 51.7% |
| Automattic/mongoose | 1,440 | 653 | 45.3% |
| bootstrap-vue/bootstrap-vue | 1,079 | 492 | 45.7% |
| foliojs/pdfkit | 797 | 408 | 51.2% |
可以看到,高产仓库普遍具备两个特征:丰富的可变异代码模式(如数学运算、条件逻辑)和健全的测试覆盖。测试覆盖率在这里扮演着双重角色:它既是变异体被检测到的前提条件(没有覆盖到变异位置的测试,变异就无法被发现),也是验证修复正确性的保障。
半数仓库颗粒无收
有意思的是,74个仓库中有一半贡献了零个验证通过的补丁。具体原因分为两类:
- 20个仓库在预验证阶段就失败了,测试结果无法正确解析
- 20个仓库生成的补丁数量过少(不足50个),验证成本大于收益
这揭示了一个重要问题:并非所有仓库都适合程序化Bug生成。像jQuery、Express、Three.js这样的知名项目反而产出为零,可能与其代码结构、测试框架兼容性或构建系统复杂度有关。JavaScript生态系统中测试框架的碎片化(Jest、Mocha、Vitest、Karma、Jasmine等)以及构建工具链的多样性(Webpack、Rollup、esbuild、Vite等)使得统一的测试执行和结果解析变得极具挑战性。这也为后续的仓库筛选策略提供了重要参考。
14种修改器的效果对比
团队为JavaScript实现了14种程序化修改器,它们的效果差异显著。
最高效的五种修改器
| 修改器 | 描述 | 验证通过数 | 通过率 |
|---|---|---|---|
| func_pm_op_flip | 翻转二元运算符 | 1,117 | 30.8% |
| func_pm_arg_swap | 交换函数参数 | 722 | 32.7% |
| func_pm_remove_assign | 移除赋值语句 | 632 | 25.4% |
| func_pm_remove_cond | 移除条件判断 | 604 | 21.9% |
| func_pm_ctrl_invert_if | 交换if/else分支 | 490 | 35.7% |
运算符翻转(op_flip)以1,117个验证补丁遥遥领先,几乎是第二名的两倍。这很好理解:将===翻转为!==、<翻转为>=、&&翻转为||,这类修改适用范围极广,几乎在所有仓库中都能找到目标。值得注意的是,JavaScript中严格相等运算符(===/!==)与宽松相等运算符(==/!=)的区分,以及类型强制转换的存在,使得运算符翻转在JS中比在强类型语言中能产生更多样化的Bug模式。
值得关注的长尾修改器
一些看似小众的修改器展现出了令人惊喜的通过率:
- func_pm_ctrl_shuffle(循环内语句打乱):虽然只生成了388个补丁,但通过率高达36.7%,排名第一
- func_pm_ctrl_invert_if(交换if/else分支):通过率35.7%,说明条件逻辑的反转是一种高效的Bug注入方式
- svg/svgo仓库的整体通过率达到73.7%,表明SVG处理类代码特别适合程序化变异
团队也指出,func_pm_ctrl_shuffle修改器的HAS_LOOP过滤条件可能过于严格,限制了其适用范围,后续有优化空间。从变异测试理论的角度看,语句顺序变异(Statement Order Mutation)属于较高阶的变异算子,它能暴露代码中隐含的顺序依赖关系——这类Bug在实际开发中也很常见,例如在初始化之前使用变量、在资源释放后继续访问等。
工程基础设施:Modal云端流水线
此前,大规模Bug生成需要数天的本地计算。团队现在将整个流水线迁移到了Modal云平台,将耗时从数天缩短到数小时。
Modal是一个专为机器学习和数据密集型工作负载设计的无服务器云计算平台。与传统云服务不同,Modal允许开发者用纯Python定义计算任务,平台自动处理容器化、GPU调度、并行扩展和结果收集。其核心优势包括:毫秒级冷启动、按实际计算时间计费(精确到秒)、以及对自定义Docker镜像的原生支持。对于SWE-Smith这类需要在隔离环境中运行大量仓库测试套件的场景,Modal的容器隔离和弹性扩展能力尤为关键——每个补丁验证都在独立容器中执行,避免了环境污染和依赖冲突。
流水线分为三个阶段:
- 生成补丁:对仓库代码施加程序化修改,通过AST(抽象语法树)解析识别可变异位置,然后应用对应的修改器生成候选补丁
- 验证补丁:在隔离容器中运行每个仓库的测试套件,确认变异后测试失败(Bug存在)且原始代码测试通过(修复有效)
- 存储结果:将验证通过的数据集上传至HuggingFace,包含Bug补丁、修复补丁、相关测试用例等完整信息
这种端到端的云端流水线设计,使得后续扩展到更多编程语言时能够快速复用基础设施。
SWE-gen:从真实PR中提取任务
除了合成补丁,团队还在利用SWE-gen工具从GitHub的已合并PR中自动提取可验证任务。SWE-gen能够检测编程语言、构建系统和测试框架,通过反转PR来重建Bug状态,并通过「失败→通过」测试来验证。
SWE-gen的PR反转(PR reversal)技术是一种巧妙的数据工程方法。其原理是:一个已合并的PR代表了从Bug状态到修复状态的转变,通过反转这个diff(即将修复后的代码回退到修复前),可以重建Bug状态。然后利用PR中新增或修改的测试用例来验证Bug确实被重新引入(测试失败)且原始代码确实修复了它(测试通过)。这种方法的优势在于能够捕获真实世界中的复杂Bug模式,包括跨文件修改、API变更、以及需要深层上下文理解的逻辑错误——这些都是简单的程序化变异难以模拟的场景。
目前,SWE-gen-JS已从30个流行的JS/TS开源仓库中生成了1,000个任务。这些来自真实Bug修复的任务能够捕获多文件变更和复杂的测试设置,弥补了程序化修改器难以模拟的场景。将SWE-Smith的合成数据与SWE-gen的真实数据结合使用,可以在训练数据的规模(合成数据的优势)和多样性(真实数据的优势)之间取得平衡。
未来展望
团队在路线图中明确了几个关键方向:
- 语言扩展:JavaScript之后,TypeScript、Java、Rust、Golang、C++将陆续加入。每种语言都有其独特的挑战——TypeScript的类型系统为变异提供了额外维度,Rust的所有权模型使得某些变异会被编译器直接拒绝,Java的面向对象特性需要类层面的变异算子
- 仓库筛选优化:从20个零产出仓库中学习经验,改进仓库选择启发式策略
- 预验证检查:在添加仓库配置前确保至少有部分预验证测试通过
- LM驱动的Bug生成:为所有已添加的仓库运行基于语言模型的Bug生成方法,利用LLM对代码语义的理解来生成更复杂、更接近真实开发者错误的Bug模式
- 训练动态研究:深入理解编程语言和仓库选择对模型训练和下游编码任务性能的影响,探索跨语言迁移学习的可能性
这个项目以开放协作的方式推进,感兴趣的开发者可以通过Slack加入团队。特别是在新型Bug生成策略方面,团队明确表示欢迎社区贡献。
总结
SWE-Smith向JavaScript的扩展,标志着多语言代码修复基准建设的重要里程碑。6,099个验证通过的合成Bug补丁、14种经过验证的修改器、以及云端化的生成流水线,为后续快速扩展到更多语言奠定了坚实基础。随着多语言数据的积累,我们有理由期待下一代代码修复模型在跨语言场景下展现出更强的泛化能力。从更宏观的视角看,这项工作正在解决AI辅助编程领域的一个核心瓶颈——高质量、多语言训练数据的稀缺性,其影响将远超单一基准测试的范畴。
相关推荐
AI编程代理持久记忆方案:逆向解析Understand Anything插件
逆向解析Understand Anything插件:它如何为Claude Code、Codex、Cursor等AI编程代理构建本地持久知识库,通过代码地图、业务逻辑连接与增量更新实现项目级记忆,而非依赖更大的上下文窗口。
Cursor、Claude Code、Qwen Code 1.0 三大AI编程Agent横评
对比 Cursor、Claude Code 与 Qwen Code 1.0 三款 AI 编程 Agent 的差异:Qwen Code 开源且无需 Node.js,Claude Code 覆盖终端与 IDE,Cursor 支持多模型并接入 Slack 与 GitHub 评审。从开源、模型绑定和工作流入口三个维度给出选型思路。
AI Agent开发者必知的5个免费GitHub仓库
探索AI Agent开发者必知的5个免费GitHub仓库,涵盖Agent项目模板、代码生成与Claude等大模型集成工具,帮助你快速搭建和优化AI智能体,降低开发门槛。